

1. 서 론
2. 데이터 구성
2.1 데이터베이스 및 연구 대상
2.2 3차원 지반 모델과 프로파일 추출
2.3 SPT N치 전처리
3. 예측 프레임워크
3.1 개요
3.2 트랜스포머–다층 퍼셉트론 아키텍처
3.3 학습 설정
4. 결과 및 분석
4.1 근입장 예측
4.2 설계 지지력 기반 근입장 결정
4.3 지지력 예측
4.4 역전파신경망 기준 모델 비교
4.5 지반 물성 추출 방법의 효과
4.6 미학습 현장에 대한 일반화 평가
5. 결 론
1. 서 론
기성 매입말뚝(prebored and precast pile)은 시공 중 소음과 진동이 작아 도심 주거 건설에서 널리 사용된다(Hsiao et al., 2025; Kobayashi and Ogura, 2007). 현장 타설 말뚝과 달리 기성 매입말뚝은 직경, 두께 및 재료 물성이 제작 단계에서 결정되어 시공 중 단면을 조정할 수 없다. 따라서 목표 지지력을 만족시키는 근입장(embedment length, L)이 주된 설계 변수가 된다. 설계자는 목표 지지력에 대응하는 근입장을 결정하고, 시공 후 일부 시험말뚝에 대해 동재하시험(dynamic load test)으로 지지력을 검증한다. 그러나 동재하시험은 전체 시공 말뚝 중 일부에만 수행되므로, 검증되지 않은 다수의 시공 말뚝이 남는다.
국내 지반조사에서 표준관입시험(Standard penetration test; SPT)으로 얻는 N치와 통일분류법(Unified Soil Classification System; USCS)에 따른 토질 분류는 가장 보편적으로 확보되는 지반정보이다. 이러한 SPT 기반 정보로부터 말뚝 지지력을 산정하기 위해 여러 경험식이 제안되어 왔다(Aoki and Velloso, 1975; Meyerhof, 1976). 경험식은 깊이별 N치 프로파일을 평균과 같은 소수의 대표값으로 축약하여 적용한다. 이 과정에서 깊이에 따른 지반 변화 정보가 소실되며, 식에 포함된 계수가 특정 데이터를 기준으로 고정되어 있어 적용 대상이 보정 데이터와 다를 때 오차가 발생한다. 수치해석 기반 방법은 지반 물성과 경계 조건에 대한 추가 정보를 요구하여, 표준 SPT 조사만으로는 적용이 제한된다.
이러한 한계를 극복하기 위해 데이터 기반(data-driven) 기법이 도입되었다. 인공신경망을 적용한 초기 연구(Lee and Lee, 1996) 이후 다양한 기계학습 기법이 말뚝 지지력 예측에 적용되었다(Amjad et al., 2022; Kumar et al., 2024; Pham et al., 2020). 기성 매입말뚝을 대상으로 데이터 기반 기법으로 지지력을 추정한 연구도 보고되었다(Kim, 2025; Seo et al., 2025). 그러나 다수의 모델은 표준 SPT 조사에서 확보되지 않는 입력을 요구하거나, N치 프로파일을 스칼라 값으로 축약하여 사용한다(Alkroosh et al., 2015; Harandizadeh and Toufigh, 2020). 최근 트랜스포머(transformer) 구조를 순차적 지반 프로파일에 적용한 연구(Youwai and Thongnoo, 2025)는 깊이 방향 정보를 보존하는 처리가 예측 성능을 높인다는 점을 보였다.
근입장 결정과 관련해서는 기존 연구가 말뚝 배치 최적화나 단일 현장 기반 예측을 다루었으나(Leung et al., 2010; Yin et al., 2021), 목표 지지력과 SPT 기반 프로파일로부터 필요한 근입장을 직접 산정하는 체계는 제시되지 않았다. 현행 실무는 경험식을 반복 적용하거나 동일한 식을 근입장에 대해 정리하여 길이를 간접적으로 구한다(Jeong et al., 2021; Meyerhof, 1976). 두 절차 모두 동일한 경험적 관계에 의존한다.
본 연구는 트랜스포머 기반 딥러닝(deep learning)을 활용하여 기성 매입말뚝의 근입장 결정과 지지력 평가를 함께 다루는 프레임워크를 제시한다. 입력은 SPT N치와 USCS 프로파일, 말뚝 제원 및 지하수위로 한정한다. 시추공 데이터로부터 역거리가중 보간(Inverse distance weighting; IDW)으로 3차원 지반 모델을 구성하고, 말뚝 위치에서 깊이별 프로파일을 추출하여 트랜스포머 인코더로 처리한다. 프레임워크는 입출력 관계가 서로 반대인 두 모델로 구성된다. 근입장 결정 모델은 목표 지지력으로부터 필요한 근입장을 예측하여 설계단계의 근입장 결정을 지원한다. 지지력 예측 모델은 주어진 근입장에 대해 선단지지력과 주면마찰력을 예측하여, 동재하시험이 수행되지 않은 시공 말뚝의 지지력을 평가한다. 근입장 결정 모델은 설계를 대체하는 최적화 도구가 아니라 설계단계의 의사결정을 지원하는 도구이다.
2. 데이터 구성
2.1 데이터베이스 및 연구 대상
본 연구의 데이터베이스는 국내 12개 주거 건설 현장에서 시공된 250본의 기성 매입말뚝으로 구성된다. 대상 현장은 풍화 정도가 다른 기반암 위에 풍화토와 풍화암이 분포하는 전형적인 화강풍화 지반이며, 말뚝은 이러한 지층의 전이 구간을 관통한다. 모든 말뚝은 PHC(Pretensioned spun high-strength concrete) 말뚝으로 외경 600 mm, 두께 90 mm의 중공 원형 단면으로 제작된다. 탄성계수는 38,000~43,000 MPa, 단위중량은 23.5~24.5 kN/m3 범위로 거의 일정하다. 단면과 재료가 제작 단계에서 고정되어, 각 말뚝은 근입장에서만 차이를 보인다. 각 시추공의 지하수위를 함께 수집하였으며, 말뚝 위치의 지하수위는 N치 및 USCS와 동일한 방식으로 보간하여 산정하고, 지반의 포화 상태를 반영하는 스칼라 입력으로 사용하였다.
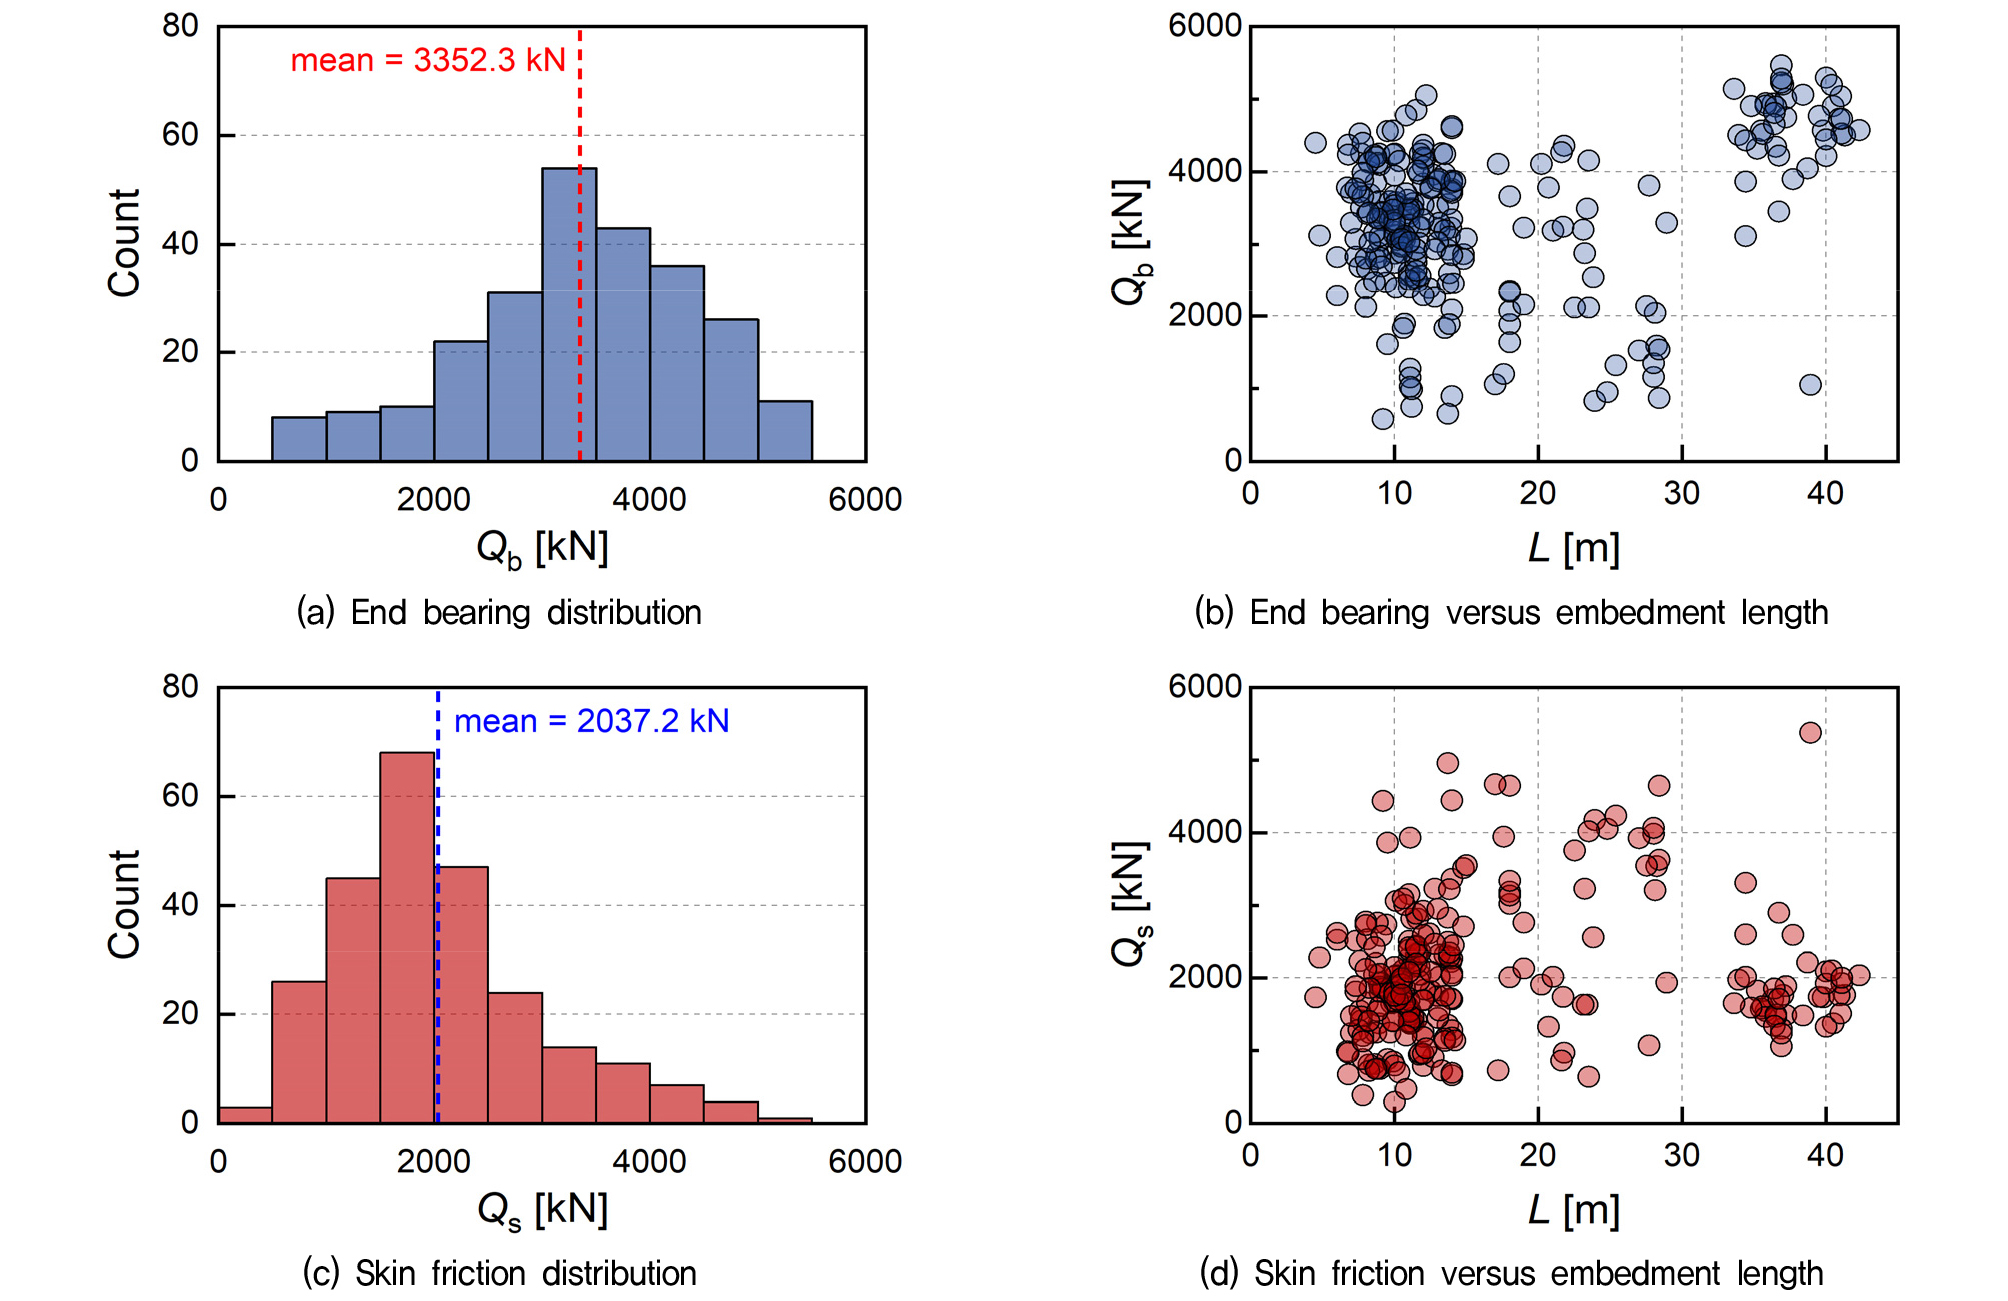
각 말뚝의 지지력은 동재하시험 결과에 CAPWAP(Case Pile Wave Analysis Program) 신호매칭을 적용하여 선단지지력(Qb)과 주면마찰력(Qs)으로 분해한 값을 사용하였다(Woo et al., 2016). 동재하시험은 시공 후 재항타(restrike) 조건에서 수행하였고, 초기항타 종료 후 약 7일이 지난 시점에 이루어졌다. 대상 12개 현장의 설계 허용지지력은 모두 1,900 kN이다. 두 성분을 분리하면 서로 다른 지반 구간에 의존하는 저항 기구를 각각 모델링할 수 있다. Fig. 1에 두 성분의 분포와 근입장과의 관계를 나타냈다. 선단지지력은 평균 약 3,352 kN을 중심으로 분포하며(Fig. 1a), 근입장이 길수록 증가하는 경향을 보인다(Fig. 1b). 이는 근입장이 긴 말뚝이 더 깊고 견고한 지지층에 도달하기 때문이다. 주면마찰력은 평균 약 2,037 kN으로 선단지지력보다 좁은 범위에 분포하며(Fig. 1c), 말뚝과 지반 사이 경계면을 따라 축적되는 저항으로 인해 근입장이 길수록 증가하는 경향을 보이나, 동일 근입장에서도 산포가 크다(Fig. 1d).
2.2 3차원 지반 모델과 프로파일 추출
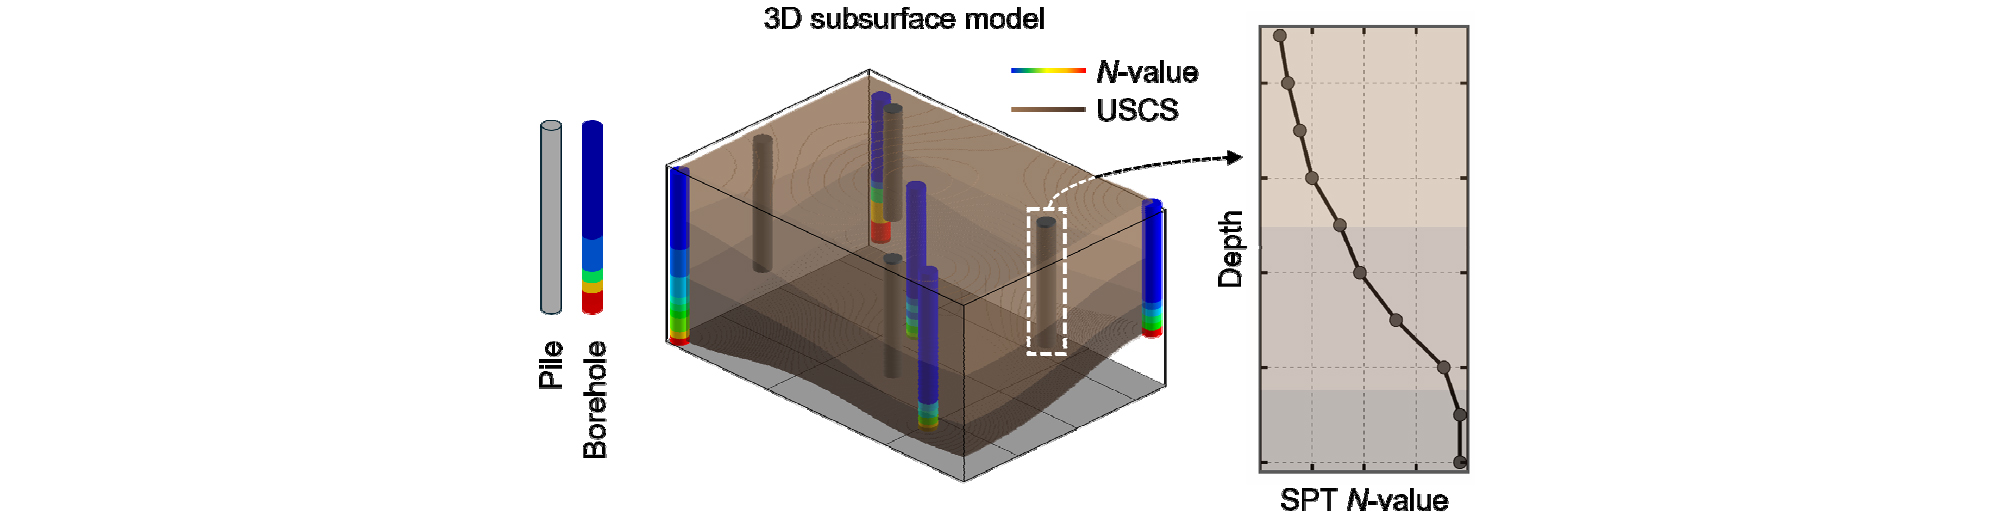
말뚝 시공 위치의 지반 물성은 직접 측정할 수 없으므로 인근 시추공 데이터로부터 추정해야 한다. 본 연구는 시추공의 N치와 USCS 데이터에 IDW 보간(Shepard, 1968)을 적용하여 각 현장의 3차원 지반 모델을 구성하였다. 보간 격자는 수평 2 m, 수직 1 m 간격으로 설정하였으며, 이를 통해 현장 전역에 걸친 N치와 USCS의 연속적인 공간 분포를 얻었다. 연속 변수인 N치는 수치 보간으로 처리하였다. 범주형 변수인 USCS는 시추공별로 지층 경계의 심도를 추출한 뒤, N치와 동일한 IDW 격자에서 각 경계 심도면을 연속적으로 보간하고, 각 격자에는 그 심도가 속하는 지층의 USCS 분류를 부여하였다.
3차원 지반 모델로부터 각 말뚝 위치에서 깊이 방향 프로파일을 1 m 간격으로 추출하였다(Fig. 2). 추출하는 깊이 구간은 두 모델에서 다르다. 근입장 결정 모델은 근입장을 미리 알 수 없으므로 지표면부터 최대 조사 심도까지의 전체 프로파일을 입력으로 사용한다. 지지력 예측 모델은 근입장이 입력으로 주어지므로 지표면부터 해당 근입장까지(0–L)의 프로파일만 사용하며, 이를 통해 근입장 정보가 입력 구조에 반영된다.
2.3 SPT N치 전처리
현장 N치는 표준 30 cm 관입 기준으로 환산하여 사용하였다. 이때 관입이 멈춘 기록(예: “50/1”)은 수백에서 1,000을 넘는 값이 되지만, 국내 SPT 실무는 30 cm를 관입하지 못한 채 타격수 50회에 도달하면 시험을 종료하므로, 50을 넘는 값은 측정된 타격수가 아니라 해석적 외삽에 해당한다. 또한 N치가 50을 넘는 구간은 대개 말뚝이 풍화암에 근입한 이후 구간이며, 이 정보는 USCS 프로파일에 이미 담겨 있다. 따라서 50을 넘는 N치의 크기는 중복된 정보에 가까우므로, N치를 50으로 상한 제한(capping)하여 중복을 줄이고 학습 효율을 높였다. 상한 제한을 적용한 경우가 적용하지 않은 경우보다 지지력 예측 성능이 향상되어 상한 제한을 채택하였다. 정량적 비교는 결과에서 제시한다. N치는 에너지효율 및 상재압에 대한 보정을 적용하지 않고 현장 측정값을 그대로 사용하였다.
전처리된 N치는 학습 데이터의 통계량을 이용하여 0–1 범위로 정규화(normalization)하였다. USCS 분류는 코드 사이에 인위적인 순서 관계가 부여되지 않도록 학습 가능한 벡터로 변환하는 범주형 임베딩(categorical embedding)으로 처리하였다. 실트질 모래가 점토질 모래보다 크거나 작다는 수치적 순서를 갖지 않도록 하기 위함이다. 서로 다른 길이의 프로파일을 배치 단위로 처리하기 위해 고정 길이 패딩(fixed-length padding)을 적용하였으며, 패딩 마스킹(padding mask)으로 데이터가 없는 위치에는 어텐션(attention)과 풀링(pooling) 계산에 반영되지 않도록 하였다.
3. 예측 프레임워크
3.1 개요
본 연구의 프레임워크는 입력과 출력을 서로 반대로 구성한 두 모델로 이루어진다. Fig. 3은 입력 데이터군과 양방향 입출력 구조를 보여준다. 입력 데이터는 네 군으로 구분된다. A군은 3차원 지반 모델에서 추출한 N치 및 USCS 프로파일, B군은 말뚝 제원으로서 형상과 재료 물성, C군은 근입장(L), D군은 지지력으로서 선단지지력(Qb)과 주면마찰력(Qs)이다.
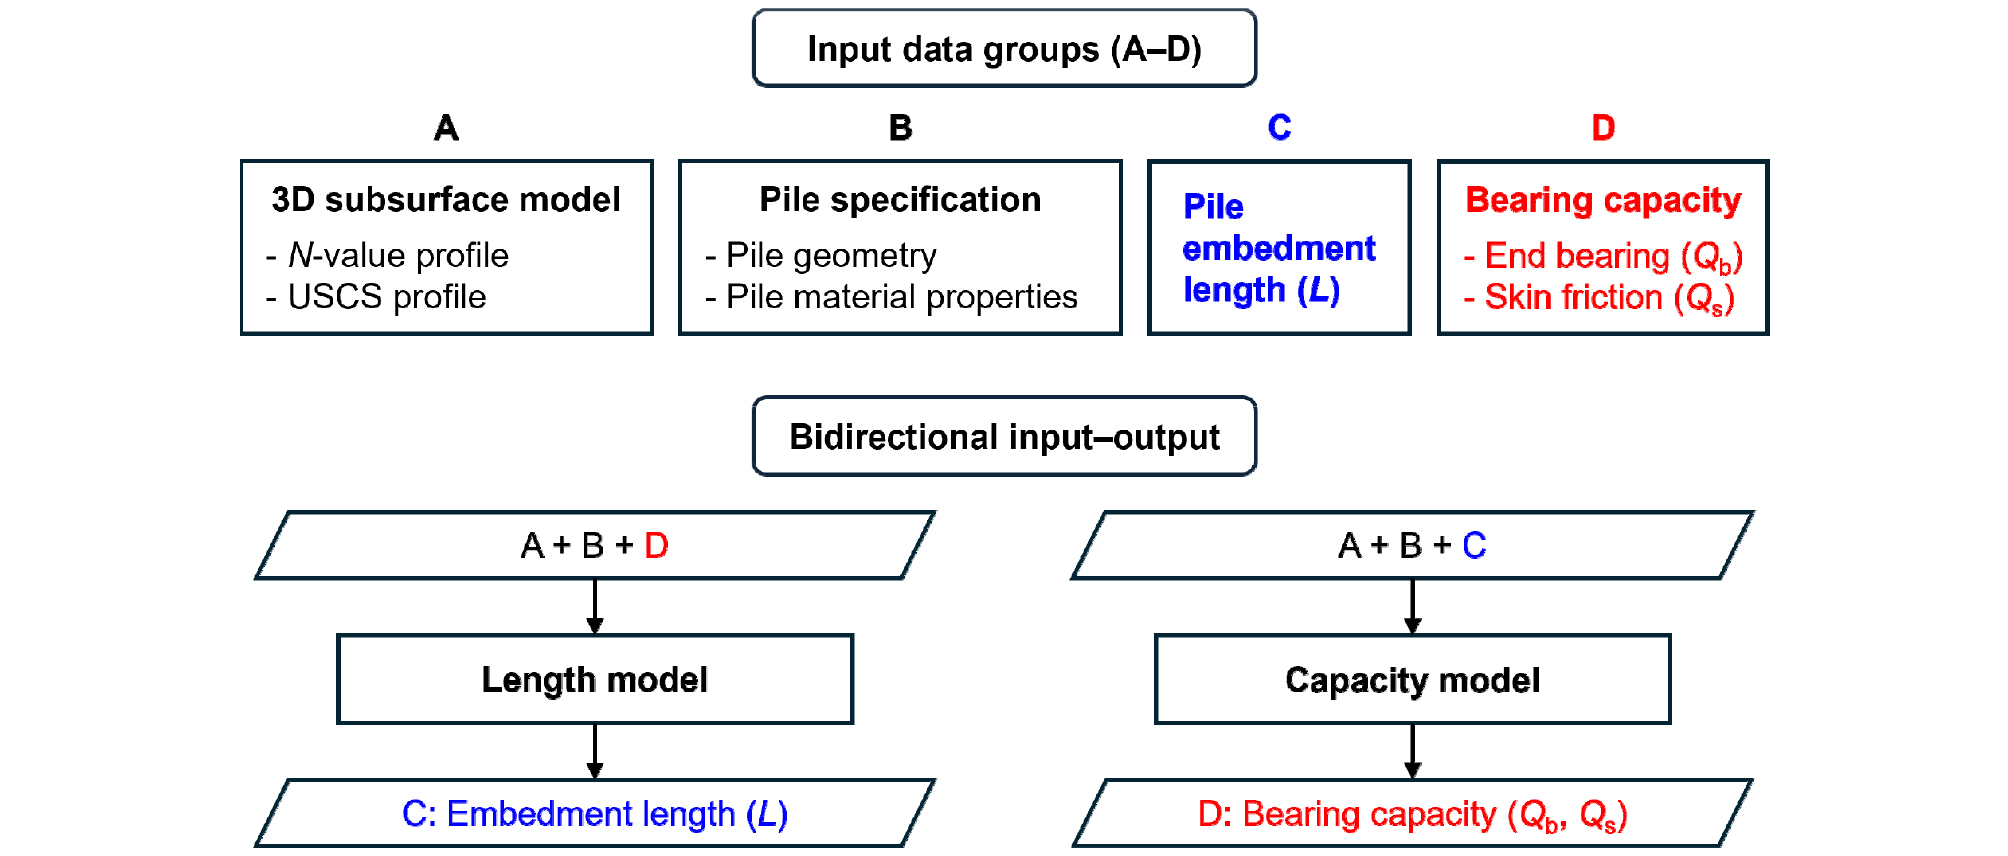
근입장 결정 모델은 지반 정보(A), 말뚝 제원(B) 및 목표 지지력(D)을 입력받아 필요한 근입장(C)을 예측한다. 여기서 목표 지지력은 선단지지력과 주면마찰력을 합한 값이며, 학습 시에는 각 말뚝의 측정 지지력을 사용하였다. 설계단계에서 목표 지지력에 대응하는 근입장을 직접 산정하여, 경험식을 반복 적용하는 기존 절차 없이 근입장 후보를 제시한다. 지지력 예측 모델은 지반 정보(A), 말뚝 제원(B) 및 근입장(C)을 입력받아 선단지지력과 주면마찰력(D)을 예측한다. 동재하시험이 수행되지 않은 시공 말뚝의 지지력을 평가하는 데 사용한다. 두 모델은 동일한 데이터군을 공유하되 무엇을 입력으로 두고 무엇을 출력으로 두는지가 반대이다.
3.2 트랜스포머–다층 퍼셉트론 아키텍처
두 모델은 순차 입력을 처리하는 트랜스포머 인코더(transformer encoder)(Vaswani et al., 2017)와 스칼라 입력을 처리하는 다층 퍼셉트론(Multi-layer perceptron; MLP) 인코더를 결합한 동일한 구조를 사용한다(Fig. 4). 이 구조는 성격이 다른 두 종류의 입력을 함께 다루면서 지반 프로파일의 깊이 방향 관계를 학습한다.
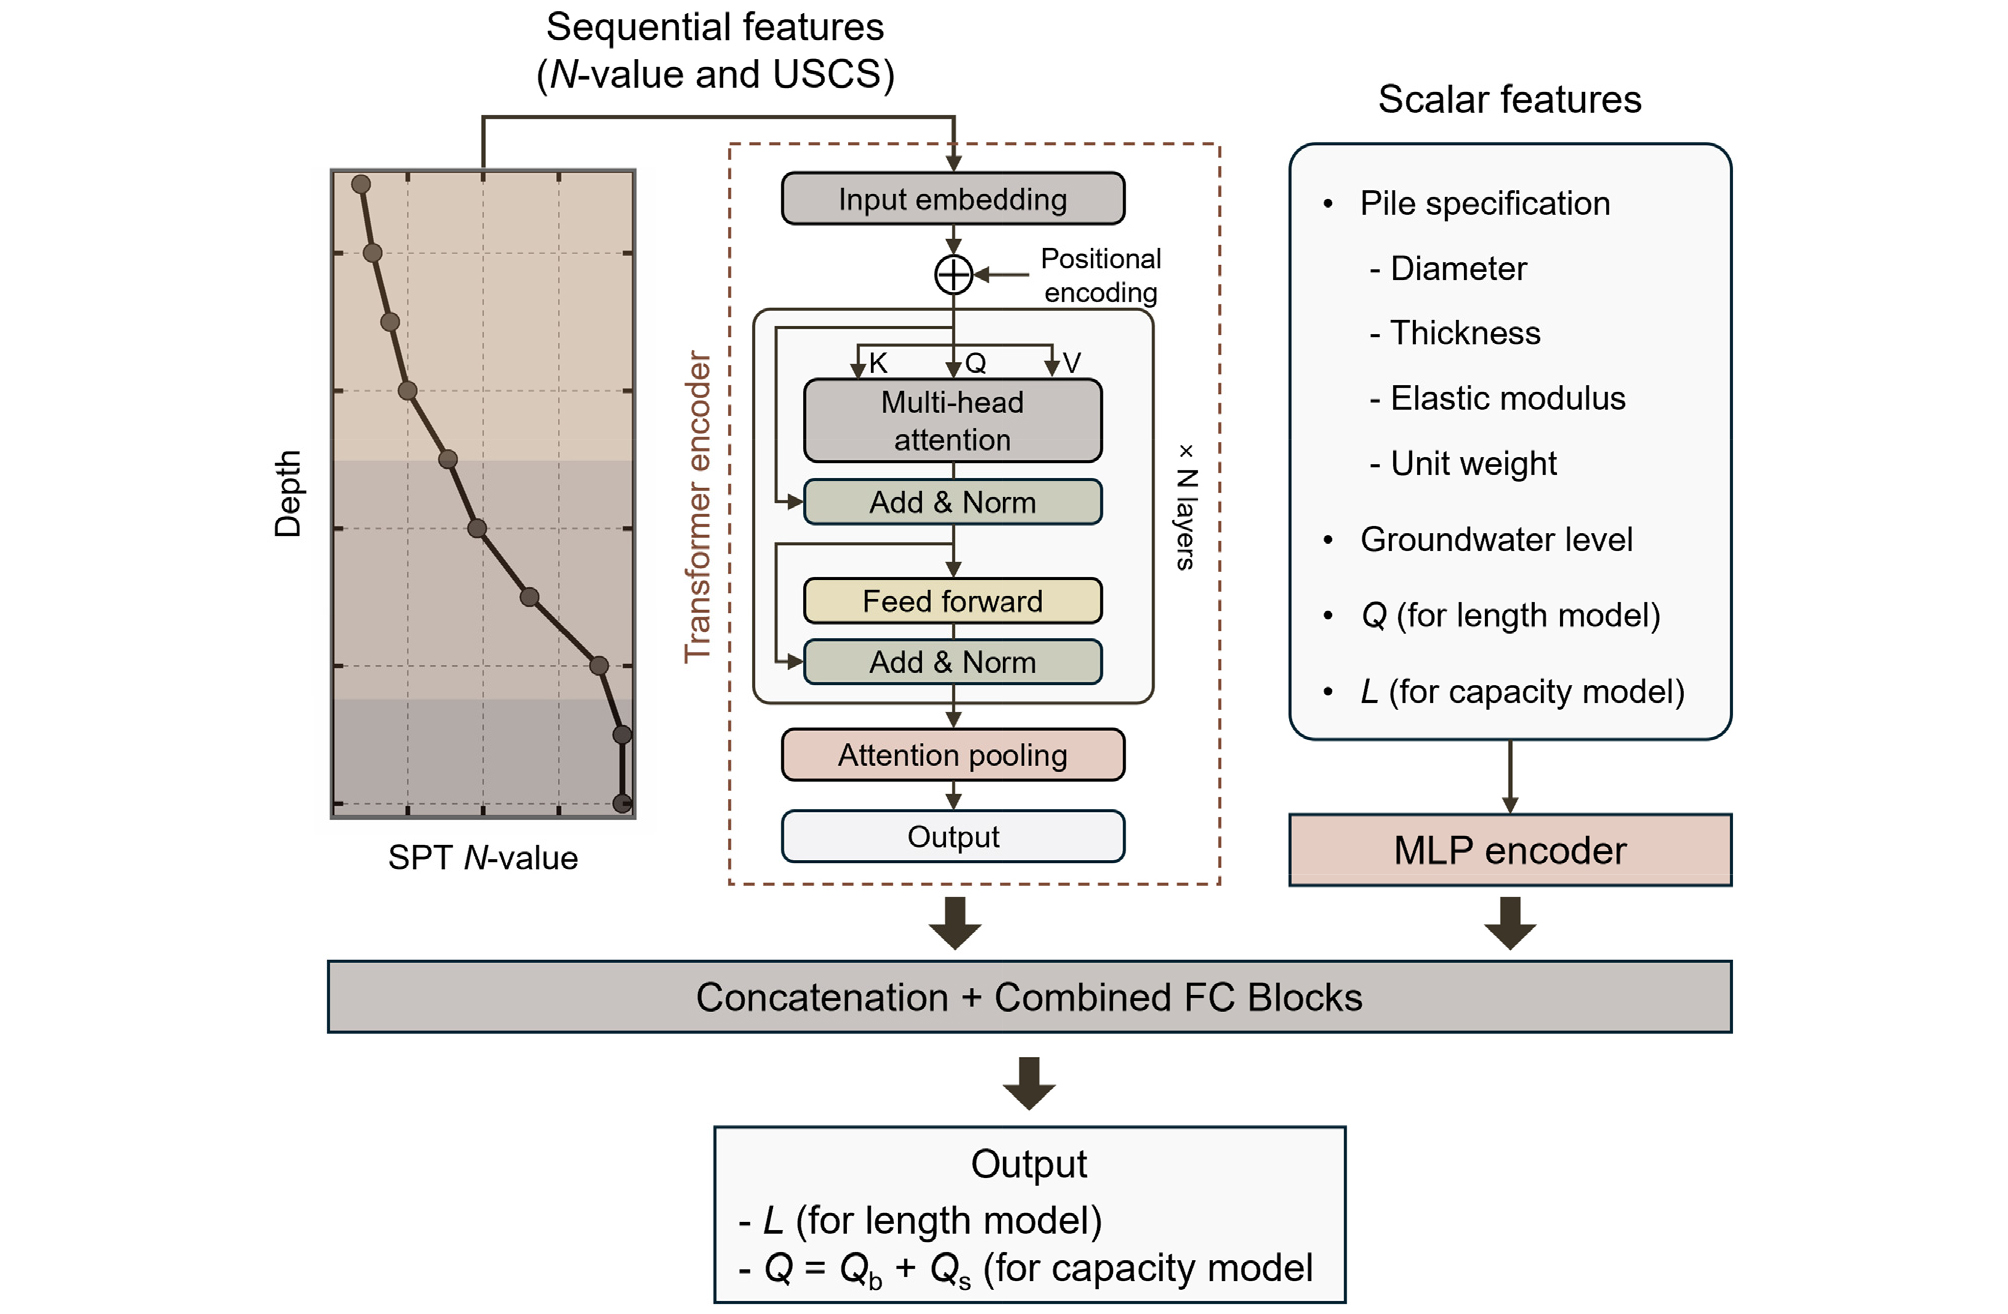
N치 및 USCS 프로파일은 입력 임베딩(input embedding)을 거쳐 은닉 차원의 벡터로 변환된 뒤, 위치 인코딩(positional encoding)과 더해져 깊이 순서 정보를 함께 담는다. 이로써 값이 같은 N치라도 놓인 깊이에 따라 서로 다른 표현으로 구별된다. 이어지는 트랜스포머 인코더는 멀티헤드 어텐션(multi-head attention)과 피드포워드(feed forward) 층으로 이루어진 블록을 여러 층으로 반복 적층하며, 각 하위 층 뒤에 잔차 연결과 정규화(Add & Norm)를 둔다. 멀티헤드 어텐션은 깊이가 다른 지반 특성 사이의 의존 관계, 예컨대 지층 강성이 급변하는 구간이나 선단부 지지층의 상태를 함께 참조한다. 인코더를 통과한 표현은 어텐션 풀링(attention pooling)으로 요약되며, 모든 깊이를 균등하게 평균하지 않고 학습된 가중치로 가중합하여 고정 길이 벡터를 만든다.
스칼라 입력은 직경, 두께, 탄성계수, 단위중량 및 지하수위로 구성되며, 근입장 결정 모델에서는 목표 지지력이, 지지력 예측 모델에서는 근입장이 추가된다. 이 스칼라 입력은 MLP 인코더로 처리된다. 어텐션 풀링으로 얻은 시퀀스 표현과 MLP의 스칼라 표현을 연결한 뒤, 잔차 연결을 포함한 결합 완전연결 층(Combined FC)을 거쳐 출력을 산출한다. 출력은 근입장 결정 모델에서 근입장(L), 지지력 예측 모델에서 선단지지력(Qb)과 주면마찰력(Qs)이다. 지지력 예측 모델은 선단지지력과 주면마찰력을 각각 예측하는 두 개의 하위 모델로 구성되며, 두 하위 모델은 동일한 구조를 공유하되 독립적으로 학습된다.
3.3 학습 설정
전체 250본은 8:1:1로 나누되, 각 현장의 표본이 학습, 검증, 테스트에 고루 들어가도록 배분하였다(표본이 적은 현장은 비율을 조정하여 최종 학습 206본, 검증 22본, 테스트 22본). 이러한 현장 균형 분할은 한두 현장의 특성이 평가 지표를 좌우하는 것을 완화한다.
손실함수는 평균제곱오차(Mean squared error; MSE), 최적화기는 AdamW를 사용하였고, 학습 과정에는 학습률 스케줄러와 검증 손실 기준의 조기 종료를 적용하였다. 구조 및 학습 하이퍼파라미터는 베이지안 최적화(Bayesian optimization)(Snoek et al., 2012)로 탐색하여 근입장 결정 모델과 지지력 예측 모델의 선단지지력 및 주면마찰력에 대해 각각 결정하였다. 세 경우(근입장 결정, 선단지지력, 주면마찰력)에 대해 트랜스포머 층 수는 각각 3, 4, 2개, 은닉 차원은 384, 512, 128, 어텐션 헤드 수는 6, 8, 2개, 드롭아웃 비율은 0.259, 0.311, 0.121이었다. 배치 크기는 32, 128, 32, 학습률은 3.62 × 10⁻⁴, 1.40 × 10⁻³, 3.54 × 10⁻³이었으며, 에폭은 최대 에폭을 근입장 결정 모델 250, 지지력 예측 모델 200으로 설정하였으며, 앞서의 검증 손실 기준 조기 종료에 따라 실제 학습은 이보다 일찍 종료되었다. 모델 성능은 결정계수(Coefficient of determination; R2), 평균절대오차(Mean absolute error; MAE), 평균제곱근오차(Root mean squared error; RMSE) 및 평균절대백분율오차(Mean absolute percentage error; MAPE)로 평가하였다.
4. 결과 및 분석
4.1 근입장 예측
근입장 결정 모델은 시공 근입장을 높은 정확도로 예측하였다. Fig. 5는 학습 및 테스트 데이터에 대한 예측 근입장과 실제 근입장을 함께 보여준다. 예측값은 약 5 m에서 40 m에 이르는 전체 근입장 범위에서 1:1 선을 따라 분포한다. 학습 데이터의 R2는 0.988, 테스트 데이터의 R2는 0.985였으며(Table 1), 두 데이터에서 비슷한 정확도를 유지하였다. 테스트 데이터의 MAE는 0.988 m, RMSE는 1.384 m, MAPE는 7.80%였다. N치 상한 제한이 근입장 예측에 미친 영향은 작아, 테스트 R2는 상한 제한 적용 전 0.984에서 적용 후 0.985로 거의 변하지 않았고 MAPE는 9.15%에서 7.80%로 감소하였다. 길이 범위 전반에서 정확도가 일정하게 유지된다는 점은 모델이 SPT 기반 프로파일과 필요한 근입장 사이의 관계를 포착함을 보여준다.
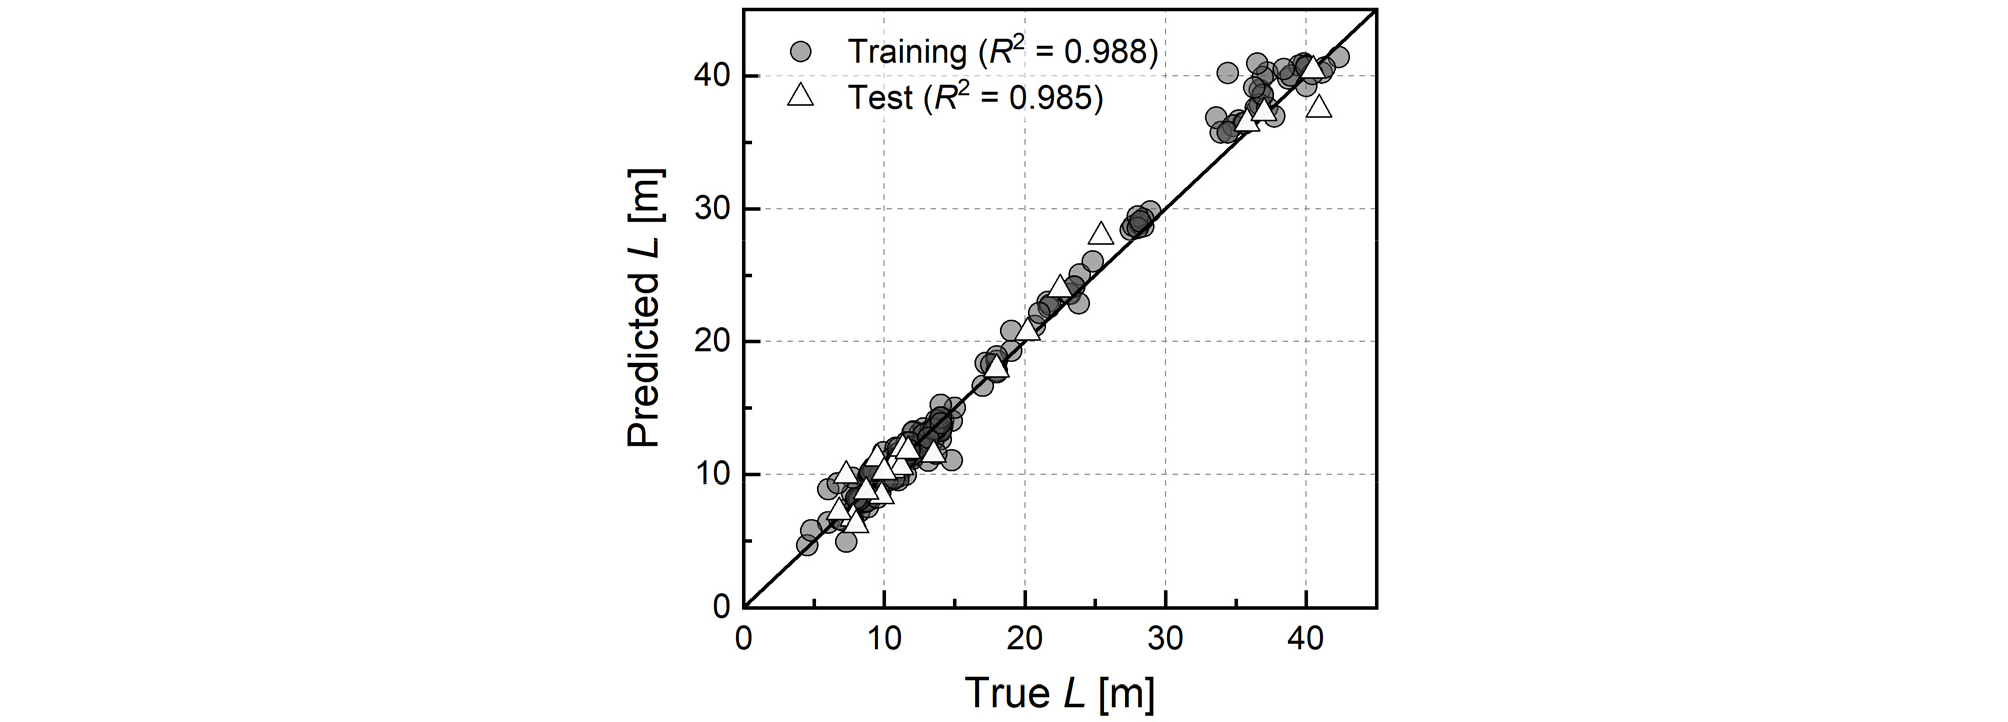
Table 1.
Embedment length determination model performance
| Split | R2 | MAE [m] | RMSE [m] | MAPE [%] |
| Training | 0.988 | 0.824 | 1.136 | 5.797 |
| Test | 0.985 | 0.988 | 1.384 | 7.799 |
4.2 설계 지지력 기반 근입장 결정
근입장 결정 모델에 측정 지지력 대신 설계 지지력 4,750 kN을 입력하면, 설계 지지력에 대응하는 근입장을 추정할 수 있다. 여기서 4,750 kN은 설계 허용지지력 1,900 kN에 안전율 2.5를 적용한 극한지지력으로, CAPWAP으로 산정한 측정 지지력과 동일한 기준의 값이다. Fig. 6은 전체 250본에 대해 이렇게 추정한 근입장과 시공 근입장의 차이 ΔL(= Ldesign − Linstalled) 분포를 보여준다. 분포는 음의 값으로 치우쳐 있으며 최빈값은 약 −1.2 m이다. 전체 평균 ΔL은 −1.29 m로, 시공 근입장 평균 대비 약 7.7%에 해당한다. 말뚝의 약 65%는 평균 2.73 m의 길이 감소 가능성을, 약 35%는 평균 1.41 m의 길이 증가를 보였다.
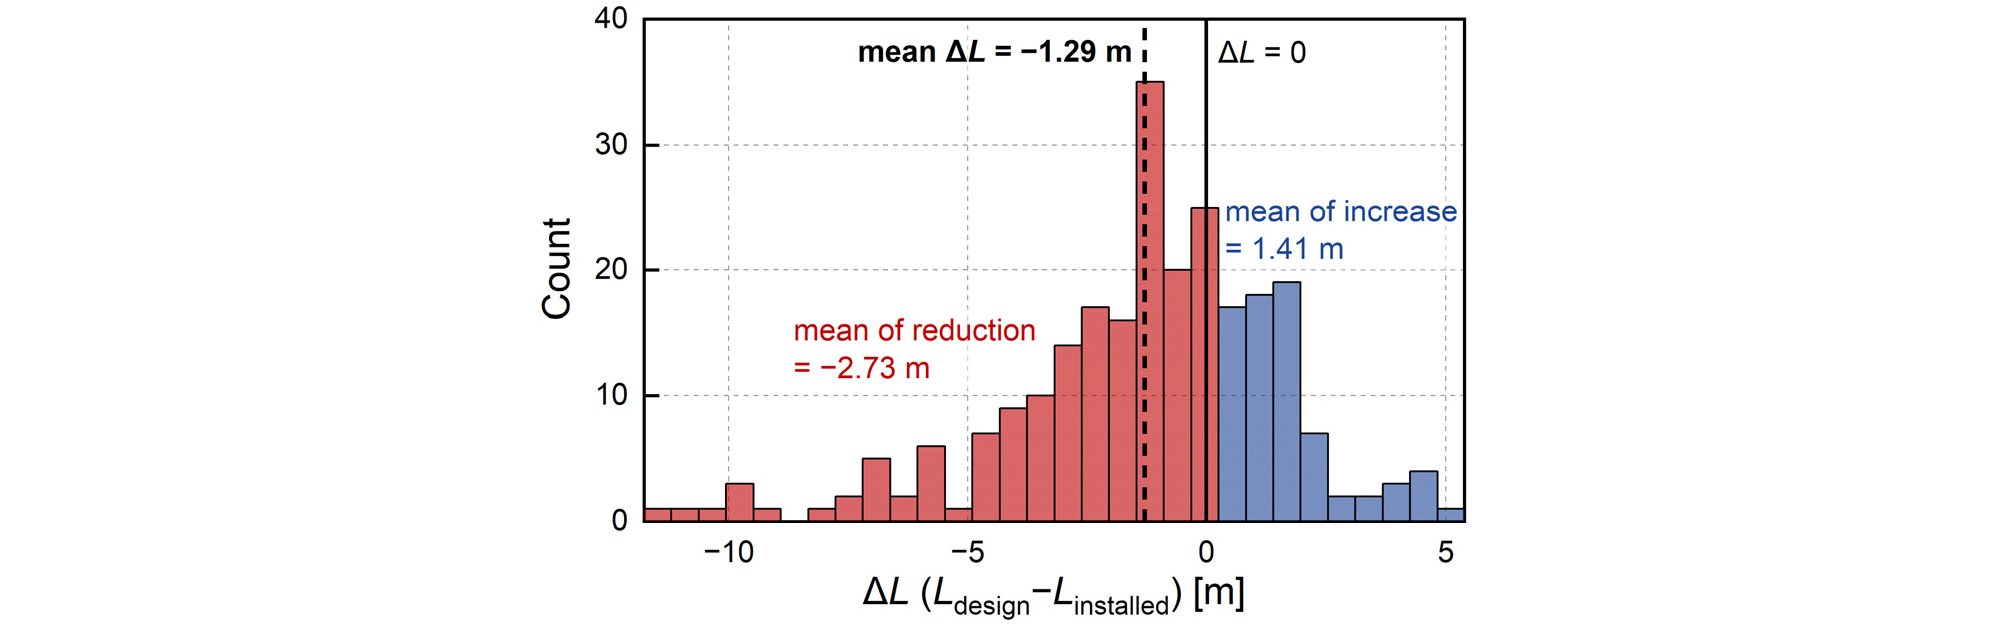
이 결과는 설계단계에서 목표 지지력에 대응하는 근입장을 가늠하는 참고 정보로 해석된다. 음의 ΔL이 우세하다는 것은 일부 시공 근입장이 설계 지지력 기준의 추정 근입장보다 여유 있게 결정되었을 가능성을 시사한다. 두 모델은 독립적으로 학습되었으며, 상호 정합성을 보장하는 방식으로 결합되지 않았다. 따라서 ΔL은 설계 지지력에 기반한 추정 근입장과 실제 시공 근입장 간의 차이를 의미할 뿐, 두 모델을 연계한 폐루프 검증을 통해 도출된 최적값은 아니다. 즉, ΔL은 설계를 대체하는 절대적인 최적값이 아니라, 통상적인 설계 검토와 현장 조건의 확인을 전제로 활용되는 의사결정 지원 정보로 해석되어야 한다.
4.3 지지력 예측
지지력 예측 모델은 선단지지력과 주면마찰력을 각각 예측한다. Fig. 7은 두 성분의 예측 결과를 학습 및 테스트 데이터에 대해 제시한다. 선단지지력의 테스트 R2는 0.822, 주면마찰력의 테스트 R2는 0.685였다(Table 2). 선단지지력의 예측값은 1:1 선 주변에 모이며, 주면마찰력은 더 넓은 산포를 보인다. N치 상한 제한을 적용하지 않은 경우의 테스트 R2는 선단지지력 0.619, 주면마찰력 0.344였으며, 상한 제한을 적용하면 각각 0.822와 0.685로 뚜렷하게 향상되었다.
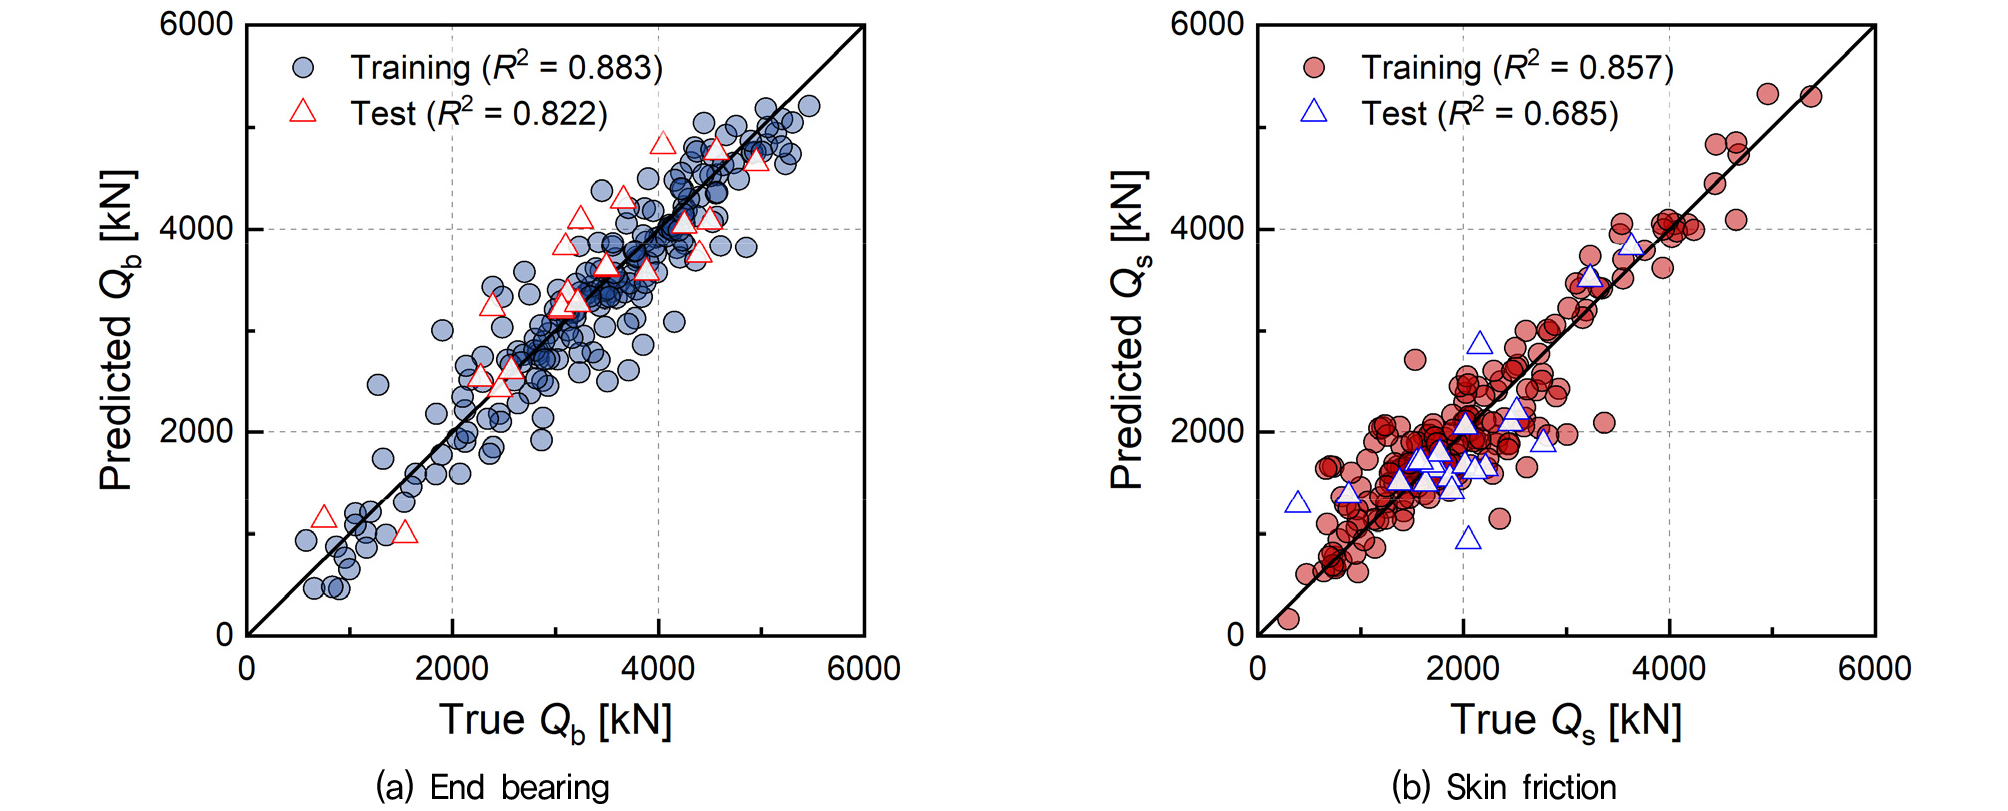
Table 2.
Capacity prediction model performance
| Target | Split | R2 | MAE [kN] | RMSE [kN] | MAPE [%] |
| End bearing | Training | 0.883 | 280.3 | 376.5 | 10.03 |
| Test | 0.822 | 362.4 | 449.8 | 13.40 | |
| Skin friction | Training | 0.857 | 276.2 | 370.5 | 17.33 |
| Test | 0.685 | 369.9 | 475.3 | 17.20 |
주면마찰력의 정확도가 선단지지력보다 낮은 것은 두 저항 기구의 특성 차이에 기인한다. 선단지지력은 주로 선단부의 조건에 의존하며, 이는 해당 깊이의 N치와 토질 분류로 설명된다. 반면 주면마찰력은 말뚝 전체 길이를 따라 축적되며, 경계면 조건, 시공 교란 및 측방토압과 같이 입력 특징이 직접 담지 못하는 요인의 영향을 받는다. 또한 CAPWAP 신호매칭으로 총지지력을 성분으로 분리하는 과정에는 비유일성에 따른 불확실성이 존재하며, 이 불확실성이 성분 단위 학습 타깃에 반영된다.
지지력 예측 모델의 학습 타깃은 2.1절에서 기술한 측정 선단지지력과 주면마찰력이다. 이 지지력은 초기항타 종료 후 약 7일이 지난 재항타 시점에 측정되어, 시멘트 페이스트의 양생과 간극수압 소산이 상당히 진행된 상태의 값이므로 지지력 증가 효과(set-up)가 대체로 완료된 저항을 반영한다. 따라서 학습 타깃은 현장 간에 일관된 기준을 유지하며, 이러한 일관성으로 인해 4.2절의 ΔL 해석 역시 set-up에 따른 지지력 변동으로 왜곡되지 않는다.
4.4 역전파신경망 기준 모델 비교
입력 표현의 효과를 분리하기 위해 역전파신경망(Back-propagation neural network; BPNN) 기준 모델과 비교하였다. 이 기준 모델은 학습 절차와 학습 타깃을 동일하게 두되, 깊이별 프로파일을 각 지층의 평균 N치와 USCS로 집약하여 BPNN으로 처리한 모델이다. Fig. 8에 BPNN 기준 모델의 선단지지력과 주면마찰력 예측 결과를 나타냈다. 테스트 R2는 선단지지력 0.365, 주면마찰력 0.138이었다(Table 3). 이는 동일한 데이터에 대해 선단지지력 0.822, 주면마찰력 0.685를 기록한 지지력 예측 모델(Table 2)에 미치지 못하는 값이다.
Fig. 8에서 BPNN 기준 모델의 예측값은 데이터의 평균 부근에 모인다. 즉 말뚝별 차이를 반영하기보다 전체 데이터의 평균값에 가까운 출력을 낸다. 이는 깊이별 프로파일을 지층 단위로 집약할 때 지층 내부의 N치 변화와 깊이 방향 변화 양상이 함께 소실되기 때문이다. 예측이 평균으로 수렴하면 Table 3에서 주면마찰력의 테스트 MAE와 RMSE가 학습보다 작게 나타나지만, 이는 타깃이 평균에 가까운 테스트에서 절대오차가 줄어드는 것일 뿐 분산 설명력인 R2는 낮게 유지된다. 이 비교는 깊이 방향 프로파일을 지층 단위로 집약하면 말뚝별 차이를 복원하기 어렵다는 점을 보여준다.
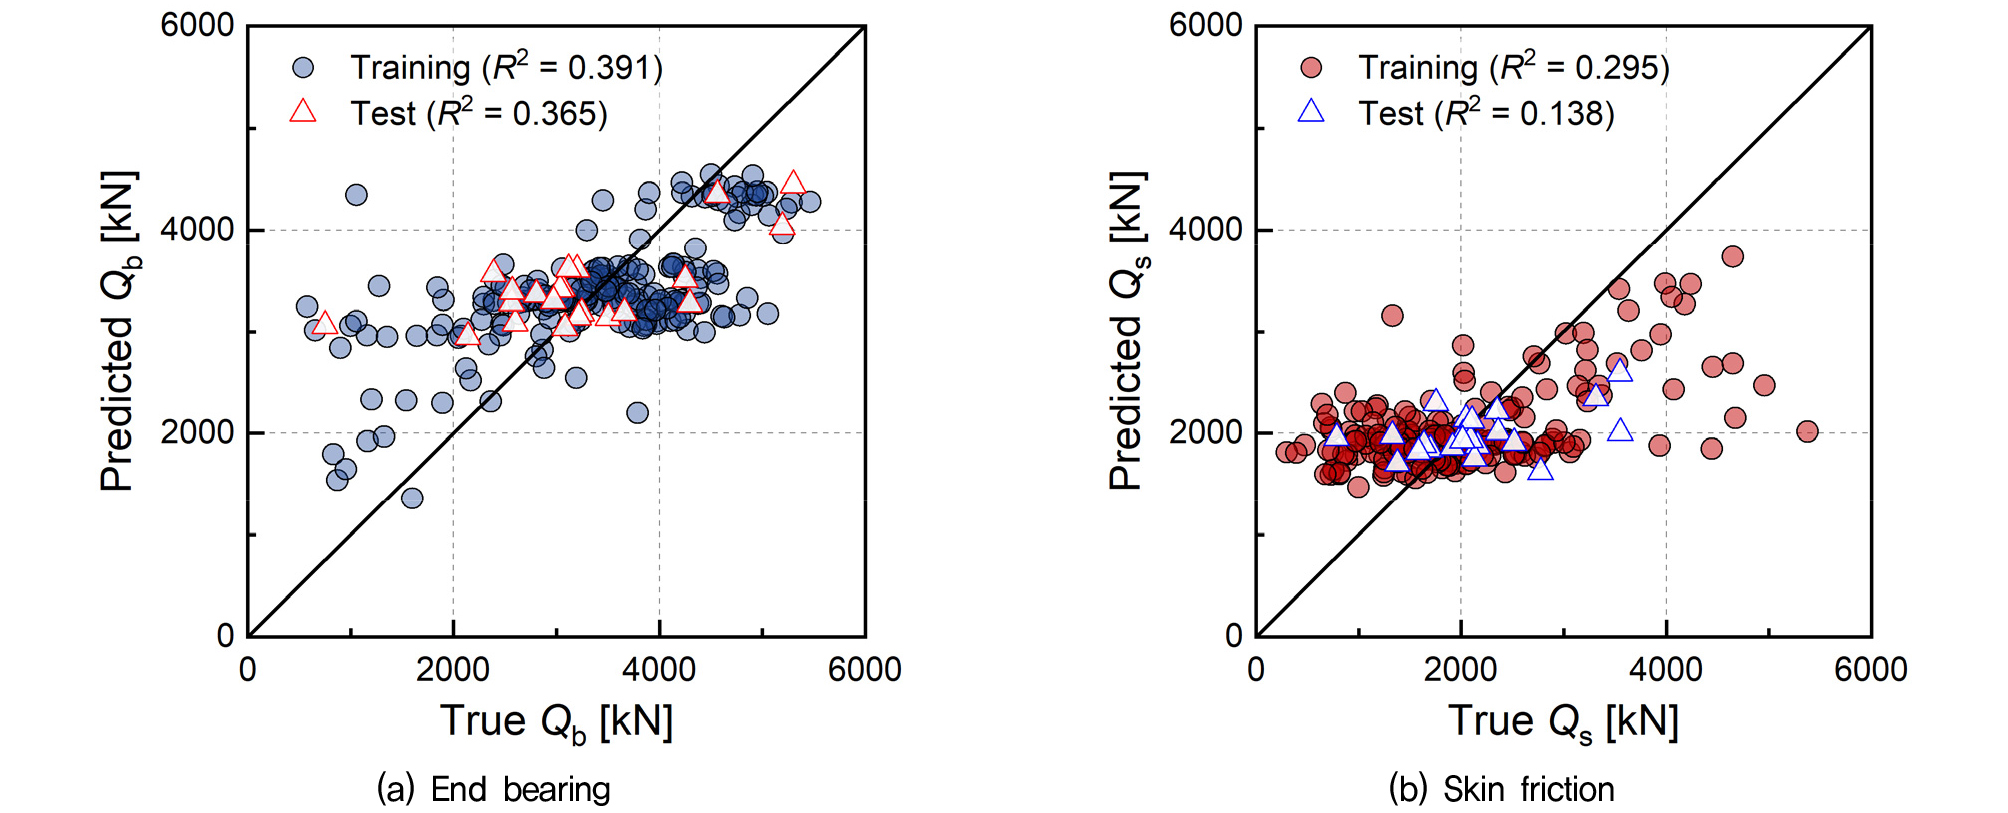
Table 3.
Capacity prediction performance of the BPNN baseline model
| Target | Split | R2 | MAE [kN] | RMSE [kN] | MAPE [%] |
| End bearing | Training | 0.391 | 641.3 | 829.7 | 28.71 |
| Test | 0.365 | 630.6 | 797.3 | 30.44 | |
| Skin friction | Training | 0.295 | 603.7 | 803.7 | 42.85 |
| Test | 0.138 | 459.0 | 627.7 | 23.94 |
다만 이 비교에서는 입력 표현과 신경망 구조가 함께 바뀌므로, 성능 차이를 순차 처리의 효과만으로 단정하기는 어렵다. 비교의 목적은 순차 처리와 대표값 집약이라는 두 입력 처리 방식의 의도된 설계 효과를 확인하는 데 있다. 트랜스포머의 셀프 어텐션(self-attention)과 위치 인코딩은 깊이 순서에 따른 의존 관계를 보존하는 반면, 지층 평균으로의 집약은 이 관계를 소실시킨다. 동일한 구조에서 입력만 달리하는 추가 비교는 별도 연구로 남겨 둔다.
4.5 지반 물성 추출 방법의 효과
지반 물성 추출 방법의 효과를 확인하기 위해, IDW 보간 대신 공간 보간 없이 최근접 시추공의 N치 프로파일을 사용하는 방법을 비교하였다. 임계거리를 10, 7, 5, 3 m로 두고, 각 임계거리 안에 시추공이 위치하는 말뚝만 포함하여 모델을 학습하였다. Fig. 9는 네 임계거리에 대한 선단지지력과 주면마찰력 예측 결과를 제시한다. 모든 경우의 성능은 250본 전체에 IDW 보간을 적용한 지지력 예측 모델(선단지지력 테스트 R2 0.822, 주면마찰력 0.685, Table 2)에 못 미쳤다(Table 4).
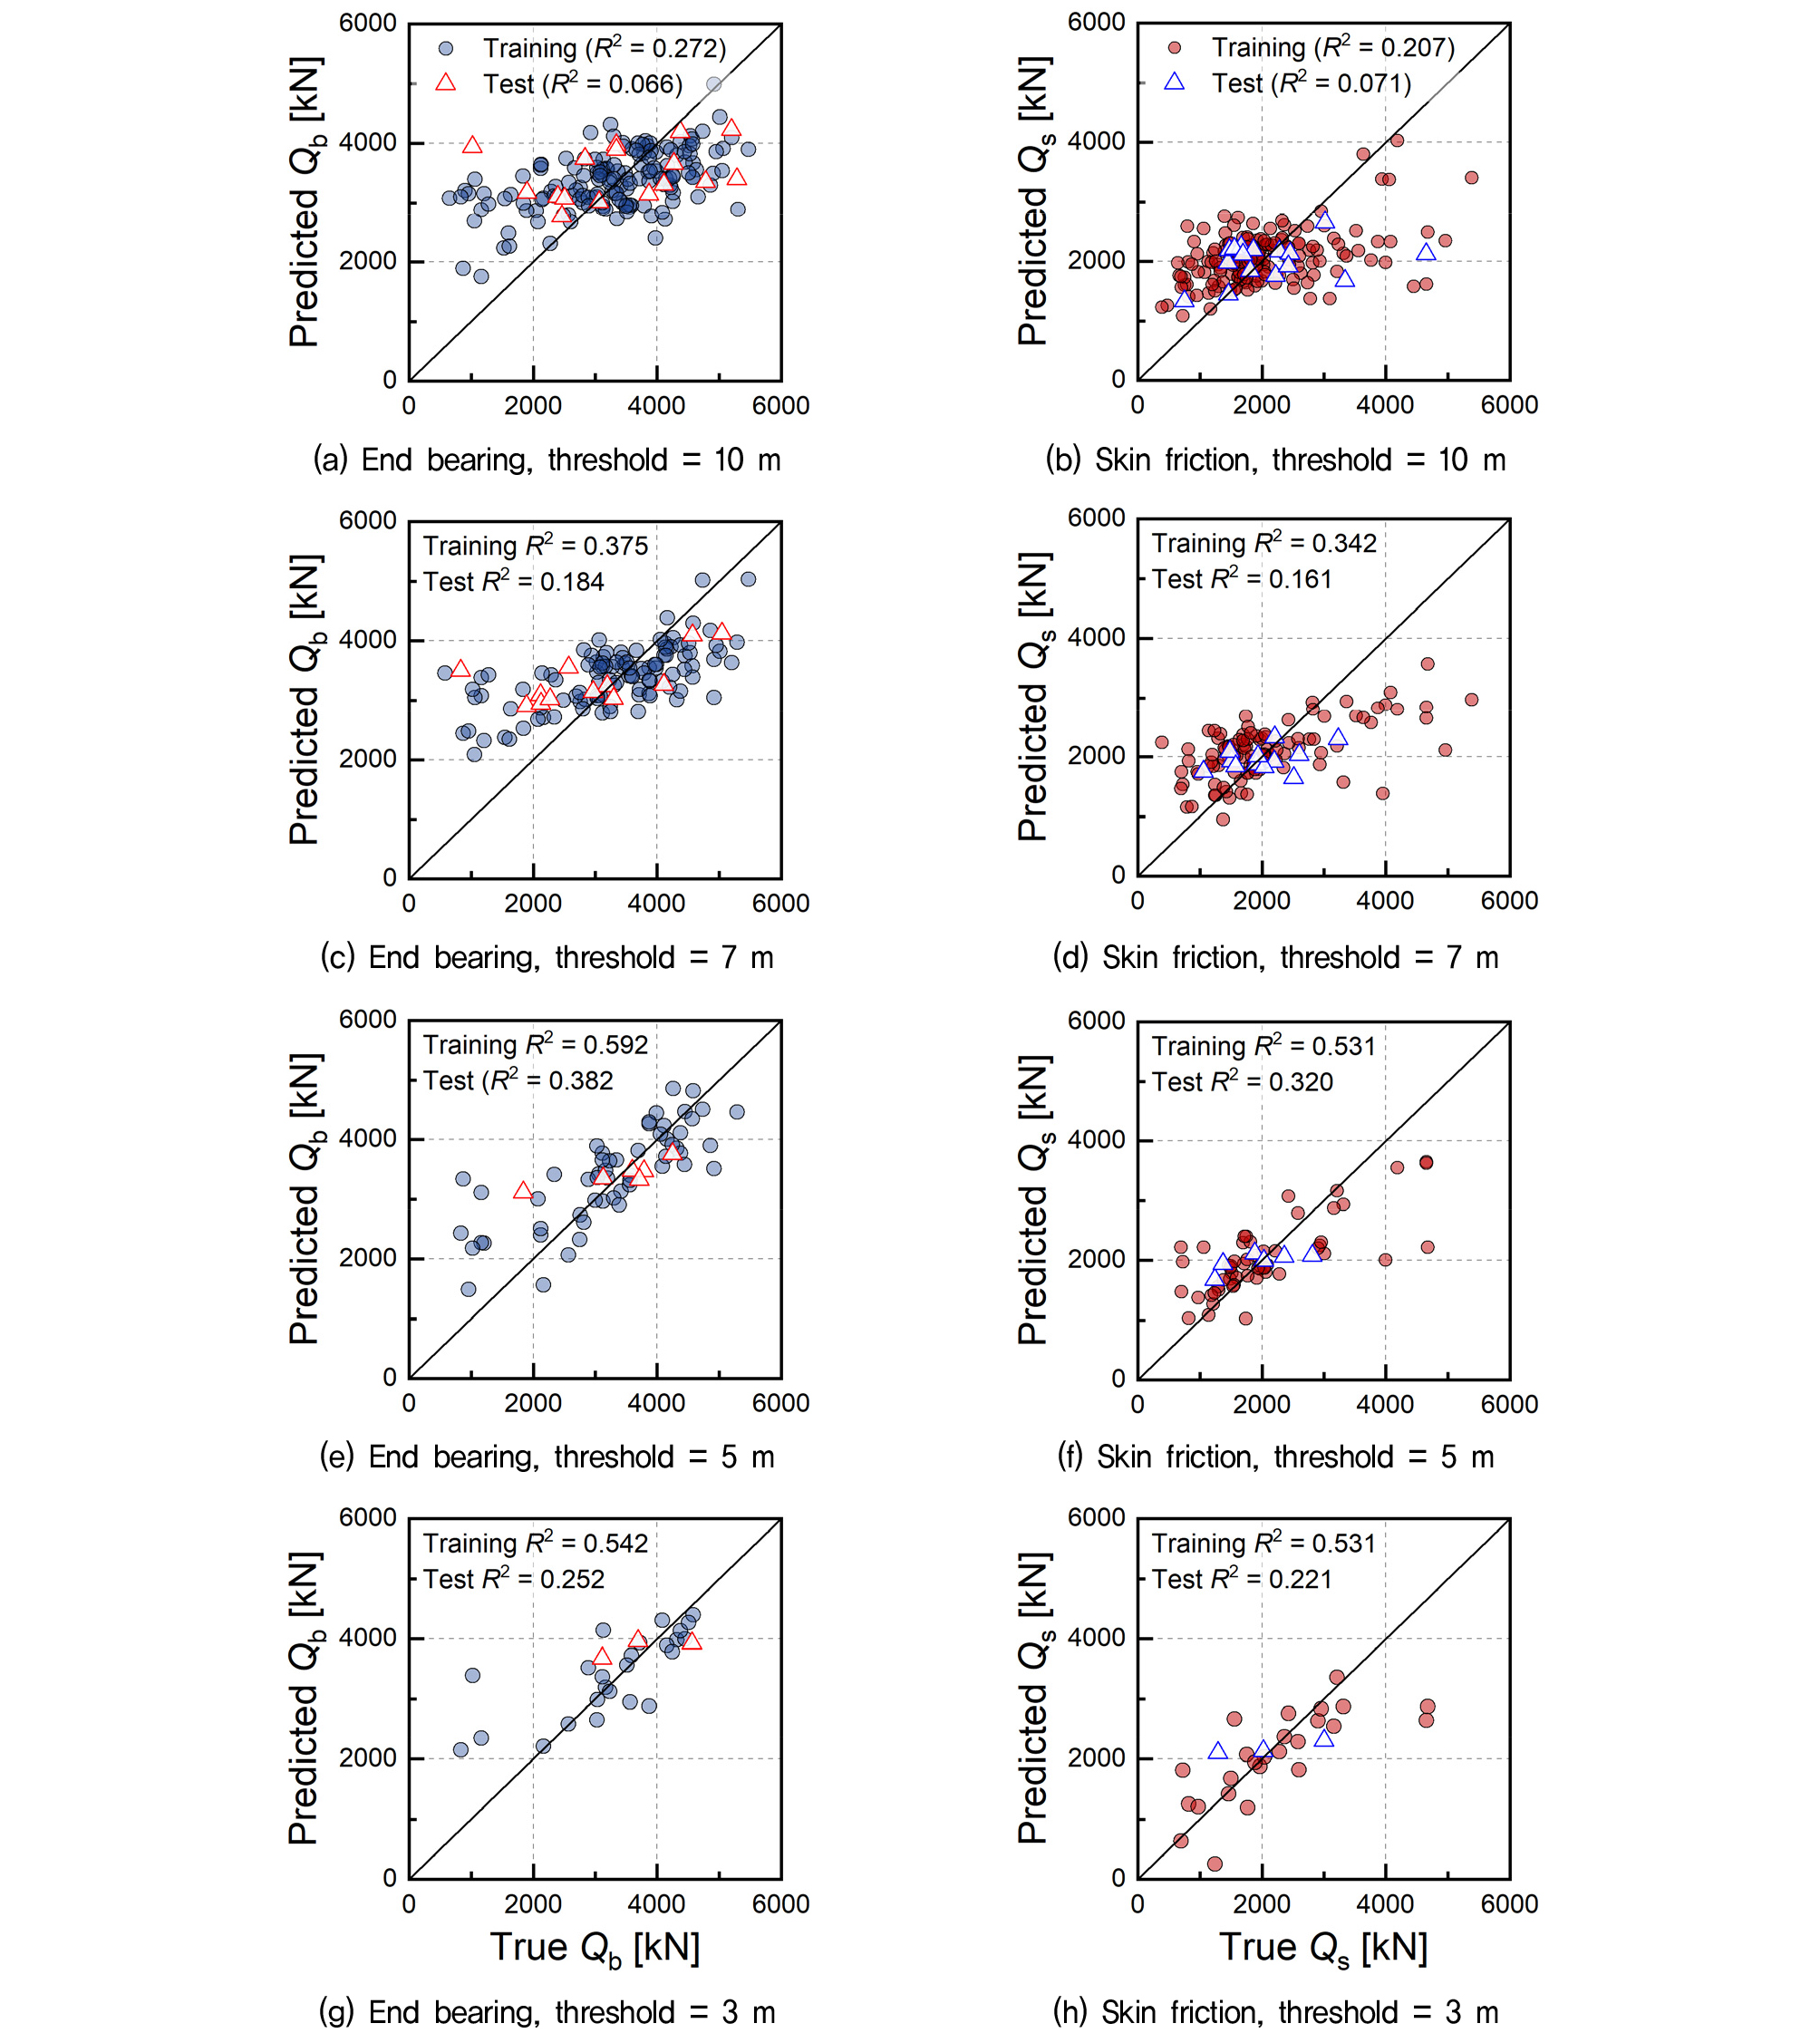
Table 4.
Capacity prediction performance without IDW interpolation
임계거리에 따라 학습에 포함되는 말뚝 수가 달라진다. 임계거리 10 m와 7 m에서는 각각 학습 155본과 107본이 포함되지만 학습 데이터의 R2마저 낮아, 최근접 시추공의 프로파일이 말뚝 위치의 조건을 충분히 대표하지 못함을 보여준다. 임계거리 5 m에서는 학습 56본으로 최근접 시추공 방법 중 가장 좋은 성능(선단지지력 테스트 R2 0.382, 주면마찰력 0.320)을 보였으나, 이는 IDW 기반 결과의 절반에 그쳤다. 임계거리 3 m에서는 가장 가까운 시추공을 사용함에도 테스트 성능이 5 m보다 낮았는데, 기준을 만족하는 말뚝이 28본으로 줄어 과적합이 나타났기 때문이다. 즉 임계거리가 넓으면 최근접 시추공의 대표성이 부족하고, 좁으면 표본이 줄어 과적합되며, 5 m가 두 효과의 절충점에 해당한다.
이 비교는 IDW 보간의 두 가지 이점을 보여준다. 첫째, 주변 여러 시추공의 데이터를 연속적인 공간 분포로 결합하여 단일 시추공보다 말뚝 위치의 조건을 잘 대표한다. 둘째, 시추공과의 거리에 관계없이 모든 말뚝 위치에서 예측이 가능하여, 거리 기준에 따른 표본 감소를 피한다.
4.6 미학습 현장에 대한 일반화 평가
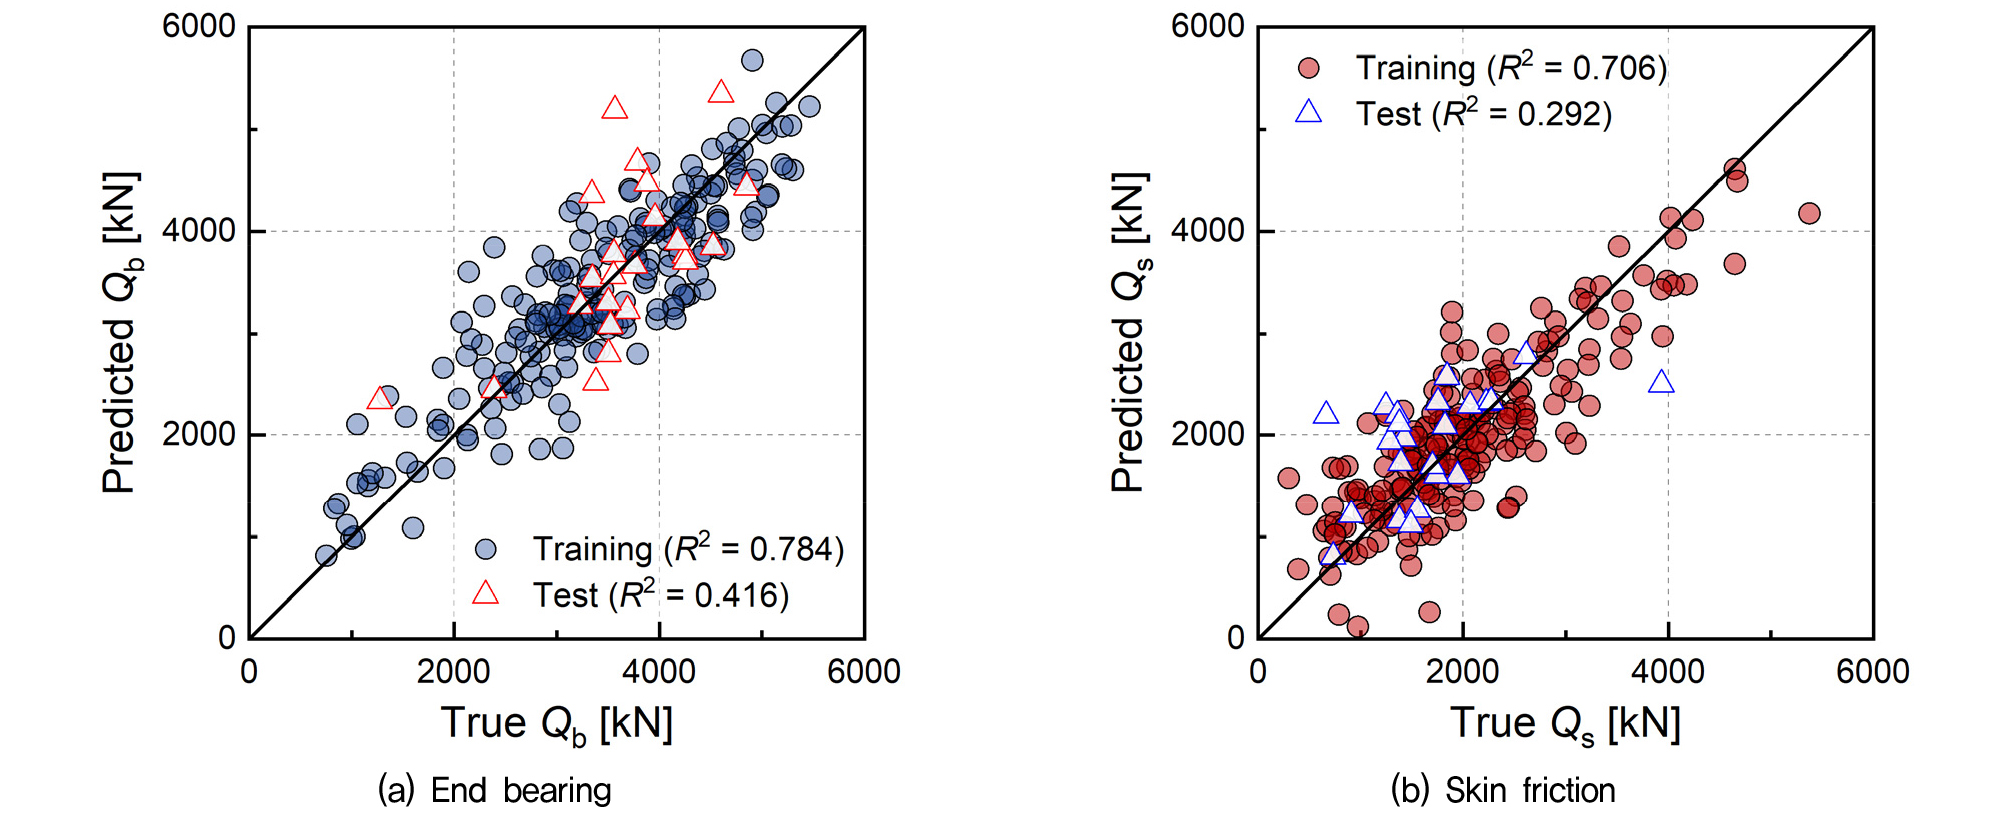
앞선 평가에서는 각 현장의 표본을 학습, 검증, 테스트에 고루 배분하였다. 학습에 포함되지 않은 현장에 대한 일반화 성능을 확인하기 위해 한 현장 제외 평가(leave-one-site-out; LOSO)를 수행하였다. 12개 현장 중 임의로 1개 현장을 테스트, 1개 현장을 검증에 두고 나머지 10개 현장을 학습에 사용하였으며, 테스트 현장의 23본은 학습 과정에서 사용되지 않았다. Fig. 10과 Table 5는 LOSO 조건에서 지지력 예측 모델의 결과를 보여준다. 테스트 R2는 선단지지력 0.416, 주면마찰력 0.292로, 현장 균형 분할(Table 2)보다 낮았다.
Table 5.
Capacity prediction performance under the leave-one-site-out (LOSO) split
| Target | Split | R2 | MAE [kN] | RMSE [kN] | MAPE [%] |
| End bearing | Training | 0.784 | 383.5 | 493.6 | 13.29 |
| Test | 0.416 | 512.1 | 642.5 | 15.96 | |
| Skin friction | Training | 0.706 | 388.1 | 493.8 | 25.39 |
| Test | 0.292 | 476.3 | 627.7 | 35.57 |
성능은 감소하였으나 예측값이 데이터의 평균으로 수렴하지 않고 말뚝별로 변동하였다(Fig. 10). 이는 모델이 미학습 현장에서도 말뚝 사이의 상대적 차이를 구별함을 의미한다. 따라서 성능 감소는 아키텍처의 실패라기보다 학습 데이터가 포괄하는 조건의 다양성에 기인한다.
5. 결 론
본 연구는 트랜스포머 기반 딥러닝을 활용하여 기성 매입말뚝의 근입장 결정과 지지력 평가를 함께 다루는 프레임워크를 제시하였다. 입력은 SPT N치와 USCS 프로파일, 말뚝 제원 및 지하수위로 한정하였다.
근입장 결정 모델은 목표 지지력으로부터 필요한 근입장을 직접 예측하여 설계단계의 근입장 결정을 지원하였으며, 테스트 R2 0.985를 보였다. 설계 지지력 4,750 kN을 입력하였을 때 예측 근입장은 시공 근입장보다 평균 1.29 m(7.7%) 짧았다. 지지력 예측 모델은 선단지지력과 주면마찰력을 각각 예측하여(테스트 R2 0.822 및 0.685), 동재하시험이 수행되지 않은 시공 말뚝의 지지력 평가에 활용할 수 있다.
두 비교는 본 프레임워크의 핵심 설계 결정을 뒷받침한다. 프로파일을 지층 단위로 집약한 BPNN 기준 모델은 데이터의 평균에 가까운 출력에 머물러, 깊이 방향 프로파일의 순차적 처리가 필요함을 보였다. 또한 IDW 보간은 모든 임계거리의 최근접 시추공 방법보다 높은 정확도를 보여, 지반 물성의 공간 보간이 신뢰할 만한 예측에 기여함을 확인하였다.
학습에 포함되지 않은 현장을 대상으로 한 LOSO 평가에서 예측 성능은 감소하였으나, 예측이 평균값에 머무르지 않고 말뚝별 차이를 유지하여 미학습 현장에 대한 일반화 가능성을 보였다. SPT N치와 USCS는 표준 지반조사가 이루어지는 현장이라면 어디서나 확보되는 국제 표준이므로, 적용 범위를 지리적으로 한정하는 요인은 입력 형식에 있지 않다. 일반화 성능을 좌우하는 것은 학습 데이터가 포괄하는 조건의 다양성이다.