

1. 서 론
2. Distance Correlation 기반 Group-Based Oversampling 알고리즘
2.1 알고리즘 개요
2.2 Distance Correlation 기반 변수 그룹화
2.3 계층적 군집분석을 이용한 변수 그룹 생성
2.4 그룹별 Oversampling 수행
2.5 그룹 데이터 통합
3. 데이터 그룹의 특성
4. 데이터 생성 결과
4.1 K=1, S=0 조건의 하이퍼파라미터
4.2 K=1, S=1000 조건의 하이퍼파라미터
4.3 K=5, S=0 조건의 하이퍼파라미터
5. 토 론
5.1 평균 차이율 및 표준편차 유지율
5.2 생성된 개별 물리량의 거동 분석
6. 결 론
1. 서 론
최근 인공지능 및 기계학습 기술은 다양한 공학 분야에서 활용되고 있으며, 재료공학, 암반공학 및 지반공학 분야에서도 물성 예측, 상태 평가 및 성능 분석을 위한 연구가 활발히 수행되고 있다(Kim, 2025; Cho, 2026; Kim, 2026). 특히 데이터 기반 모델은 복잡한 물리적 현상을 효과적으로 분석할 수 있다는 장점으로 인해 다양한 연구에 적용되고 있다. 그러나 대부분의 공학 데이터는 실험 비용, 시료 확보의 어려움 및 장기간의 시험 기간 등으로 인해 충분한 양의 데이터를 확보하기 어려운 경우가 많다. 또한 특정 상태나 조건에 대한 데이터가 제한적으로 존재하는 경우 데이터 불균형 문제가 발생하며, 이는 인공지능 모델의 학습 성능 저하 및 예측 편향을 유발할 수 있다. 이러한 문제를 해결하기 위하여 데이터 증폭(Data Augmentation) 또는 Oversampling 기법이 널리 활용되고 있다. 대표적인 방법으로는 Random Over Sampling(ROS), Synthetic Minority Over-sampling Technique(SMOTE), Adaptive Synthetic Sampling(ADASYN) 등이 있으며, 특히 SMOTE와 ADASYN은 기존 데이터를 기반으로 새로운 가상 데이터를 생성할 수 있다는 장점으로 인해 다양한 연구 분야에서 활용되고 있다(Li et al., 2025; Zhao and Teng, 2025). SMOTE는 최근접 이웃 기반의 선형 보간을 이용하여 새로운 데이터를 생성하며, ADASYN은 데이터 밀도에 따라 생성 비율을 조정함으로써 클래스 불균형 문제를 완화한다(Akosah and Gratchev, 2026). 그러나 기존 Oversampling 기법은 모든 입력 변수를 하나의 특징 공간으로 간주하여 데이터를 생성한다는 공통적인 특징을 가진다(Yoon et el., 2022). 이러한 접근은 변수 간 상관관계와 구조적 특성을 충분히 고려하지 못할 수 있으며, 특히 공학 데이터와 같이 복잡한 비선형 관계를 포함하는 경우 원본 데이터가 가지는 구조적 특성이 왜곡될 가능성이 존재한다. 예를 들어 암석 또는 지반 물성 데이터는 압축파 속도, 전단파 속도, 영의 계수, 포아송비, 간극률 및 균열밀도와 같이 서로 밀접한 물리적 관계를 가지는 변수들로 구성된다. 이와 같은 데이터에 대해 전체 변수를 대상으로 일괄적인 Oversampling을 수행할 경우 실제 데이터에서 나타나는 변수 간 의존성이 충분히 반영되지 못할 수 있다.
최근 변수 간 관계를 고려한 데이터 분석의 중요성이 증가하면서 Pearson Correlation, Mutual Information 및 Distance Correlation 등을 이용한 변수 관계 분석 연구가 수행되고 있다(Baek and Cho, 2025). 특히 Distance Correlation은 선형 관계뿐만 아니라 비선형 관계까지 정량적으로 평가할 수 있어 복잡한 공학 데이터의 구조를 분석하는 데 효과적인 방법으로 알려져 있다(Zhang et al., 2025; Wang et al., 2026). 따라서 데이터 생성 과정에서도 변수 간 의존성을 고려할 수 있다면 기존 Oversampling 기법의 한계를 일부 개선할 수 있을 것으로 기대된다. 이에 본 연구에서는 Distance Correlation을 이용하여 변수 간 의존성을 분석하고, 계층적 군집분석을 통해 유사한 특성을 갖는 변수들을 그룹화한 후 그룹 단위로 데이터를 생성하는 Group-Based Oversampling 기법을 제안하였다. 제안 기법은 기존 SMOTE 및 ADASYN과 달리 변수 간 구조적 관계를 고려한 상태에서 데이터를 생성할 수 있도록 설계되었다. 해당 연구에는 Yoon(2025)의 암석 풍화 실험 데이터를 활용하였다. 해당 데이터는 풍화 과정에서 측정된 압축파 속도, 전단파 속도, 영의 계수, 포아송비, 간극률 및 균열밀도의 6개 물리량으로 구성되어 있다. 본 연구에서는 Distance Correlation 기반 변수 그룹화를 수행한 후 데이터를 생성하였으며, 생성된 데이터와 원본 데이터의 확률밀도함수, 평균 차이율 및 표준편차 유지율을 비교함으로써 제안 기법의 특성을 분석하였다. 본 연구의 목적은 단순히 데이터 개수를 증가시키는 것이 아니라, 변수 간 구조적 관계를 고려한 데이터 생성 가능성을 검토하고, 생성 데이터가 원본 데이터의 통계적 특성을 얼마나 효과적으로 재현할 수 있는지를 평가하는 데 있다. 이를 통해 향후 공학 분야 데이터 증폭 기법의 활용성과 적용 가능성에 대한 기초 자료를 제공하고자 한다.
2. Distance Correlation 기반 Group-Based Oversampling 알고리즘
2.1 알고리즘 개요
기존의 Synthetic Minority Over-sampling Technique(SMOTE) 및 Adaptive Synthetic Sampling(ADASYN) 알고리즘은 전체 입력 변수를 하나의 특징 공간으로 간주하여 소수 클래스의 데이터를 증폭한다. 이러한 방법은 클래스 불균형 문제를 효과적으로 완화할 수 있으나, 변수 간 상관구조를 고려하지 않은 상태에서 데이터를 생성하기 때문에 원시 데이터가 가지고 있는 구조적 특성이 왜곡될 가능성이 존재한다. 특히 지반공학 및 재료공학 분야의 데이터는 변수 간 비선형 관계와 복잡한 상호 의존성을 포함하는 경우가 많다. 예를 들어 일부 변수들은 강한 상관성을 가지는 반면, 다른 변수들은 거의 독립적인 특성을 나타낼 수 있다. 이와 같은 상황에서 전체 변수를 대상으로 일괄적인 Oversampling을 수행할 경우, 실제 데이터에서 존재하지 않는 조합이 생성될 가능성이 있다.
본 연구에서는 이러한 문제를 해결하기 위하여 Distance Correlation(dCor)을 이용하여 변수 간 의존성을 정량화하고, 유사한 상관구조를 가지는 변수들을 그룹화한 후 각 그룹별로 독립적인 Oversampling을 수행하는 Group-Based Oversampling 기법을 제안하였다.
제안된 알고리즘은 다음과 같은 4단계로 구성된다.
(1) Distance Correlation 행렬 생성
(2) 계층적 군집분석(Hierarchical Clustering)을 이용한 변수 그룹화
(3) 그룹별 SMOTE 또는 ADASYN 수행
(4) 생성된 그룹 데이터 통합
2.2 Distance Correlation 기반 변수 그룹화
Pearson 상관계수는 선형 관계만을 측정할 수 있으므로 비선형 관계를 충분히 반영하기 어렵다. 이에 본 연구에서는 선형 및 비선형 관계를 모두 고려할 수 있는 Distance Correlation을 적용하였다. 두 변수 (X)와 (Y)에 대하여 거리행렬은 다음과 같이 정의된다.
여기서, aij와 bij는 각각 변수 (X)와 (Y)의 샘플 간 거리이다.
거리행렬에 대해 이중 중심화(Double Centering)를 수행하면 다음과 같다.
여기서, a 위에 있는 줄은 평균을 의미하며, ai와 aj는 각각 행 j열의 평균을 보인다. B와 관련된 수식의 개별 인자도 a와 동일한 의미를 가진다.
이를 기반으로 Distance Covariance와 Distance Variance는 다음과 같이 계산된다.
여기서, 각 기호가 의미하는 내용은 수식 (1), (2) 그리고 (3)과 같으며, n은 데이터 개수를 의미한다. 따라서 Distance Correlation은 다음과 같이 정의된다.
Distance Correlation 값은 0~1 범위를 가지며, 값이 클수록 두 변수 간 의존성이 높음을 의미한다. 본 연구에서는 모든 변수 쌍에 대해 Distance Correlation을 계산하여 상관행렬을 구축하였다.
2.3 계층적 군집분석을 이용한 변수 그룹 생성
Distance Correlation 행렬을 기반으로 변수 간 거리행렬을 다음과 같이 정의하였다.
Distance Correlation 값이 클수록 변수 간 거리는 작아지며, 유사한 특성을 갖는 변수들이 동일 그룹으로 분류된다. 본 연구에서는 Average Linkage 기반 계층적 군집분석(Hierarchical Clustering)을 적용하였다.
두 군집 (A) 와 (B) 사이의 거리는 다음과 같이 계산된다.
여기서, 는 각각 군집 A와 B의 변수 개수를 의미한다. 계층적 군집분석 결과를 이용하여 전체 변수 집합은 그룹으로 분할 된 후 유사한 상관구조를 가지는 변수들이 동일 그룹에 포함되도록 구성하였다.
2.4 그룹별 Oversampling 수행
생성된 각 그룹에 대해서는 독립적으로 Oversampling을 수행하였다. 먼저 변수 스케일 차이에 의한 영향을 제거하기 위하여 Z-score 정규화를 수행하였다.
여기서, 는 평균, 는 표준편차를 의미한다. 정규화된 데이터에 대해 SMOTE 알고리즘을 적용하였으며, 본 연구에서는 클래스별 데이터 수를 고려하여 최근접 이웃 개수를 다음과 같이 자동 조정하였다.
여기서, k는 사용자가 지정한 이웃의 수이며, Nmin은 최소 클래스의 데이터수를 의미한다. 최종적으로는 Oversampling 수행 후 역정규화를 적용하여 원래 단위계로 복원하였다.
2.5 그룹 데이터 통합
각 그룹에서 생성된 증폭 데이터는 최종적으로 하나의 데이터셋으로 통합된다. 그룹별 생성 결과를 각각 x(1), x(2), x(3), x(n)이라고 하면 최종 데이터 셋인 X는 X=[x(1), x(2), x(3), x(n)]로 구성된다. 즉, 동일한 클래스 레이블을 유지한 상태에서 그룹별 생성 결과를 결합하여 최종 증폭 데이터를 생성한다. 이와 같은 방법은 전체 변수를 동시에 증폭하는 기존 SMOTE와 달리 변수 간 상관구조를 반영한 상태에서 데이터를 생성할 수 있으며, 원시 데이터가 가지는 구조적 특성을 보다 효과적으로 유지할 수 있다는 장점을 가진다.
3. 데이터 그룹의 특성
본 연구에서는 Yoon(2025)에서 제시된 암석 시료의 풍화 실험 결과를 활용하였다. 해당 연구에서는 암석 시료에 대하여 물리적 풍화와 화학적 풍화를 단계적으로 적용하고, 풍화 진행에 따른 물리적 특성 변화를 정량적으로 분석하였다. 풍화 과정 동안 암석의 탄성파 특성 및 공극 구조 변화를 평가하기 위하여 압축파 속도, 전단파 속도, 간극률 등을 측정하였으며, 측정 결과를 기반으로 영의 계수(Young’s modulus), 포아송비 및 균열밀도를 산정하였다. 이러한 변수들은 풍화에 따른 암석의 강성 저하와 내부 구조 변화를 반영하는 대표적인 물성 인자로 알려져 있다.
본 연구에서는 데이터 증폭 기법의 성능을 평가하기 위하여 압축파 속도, 전단파 속도, 영의 계수(Young’s modulus), 포아송비, 간극률, 균열밀도의 총 6개 물리량을 입력 변수로 구성하였다. 각 변수는 풍화 단계에 따른 암석의 물리적 특성을 나타내며, 상호 간의 구조적 관계를 포함하고 있어 데이터 증폭 과정에서 분포 및 상관구조 유지 여부를 평가하기에 적합한 데이터셋으로 판단된다. 본 연구는 데이터 증폭 알고리즘의 구조적 특성 분석에 초점을 두고 있으므로, 풍화에 따른 암석의 대표적인 물리 및 역학적 특성을 나타내는 6개 물리량만을 분석 대상으로 선정하였다. 한편, 각 물리량의 세부 측정 방법, 실험 장비, 계산 과정 및 분석 절차는 Yoon(2025)에 상세히 기술되어 있으므로 본 논문에서는 중복 설명을 생략하였다. 보다 자세한 실험 방법과 데이터 획득 과정은 해당 참고문헌을 참고하기 바란다.
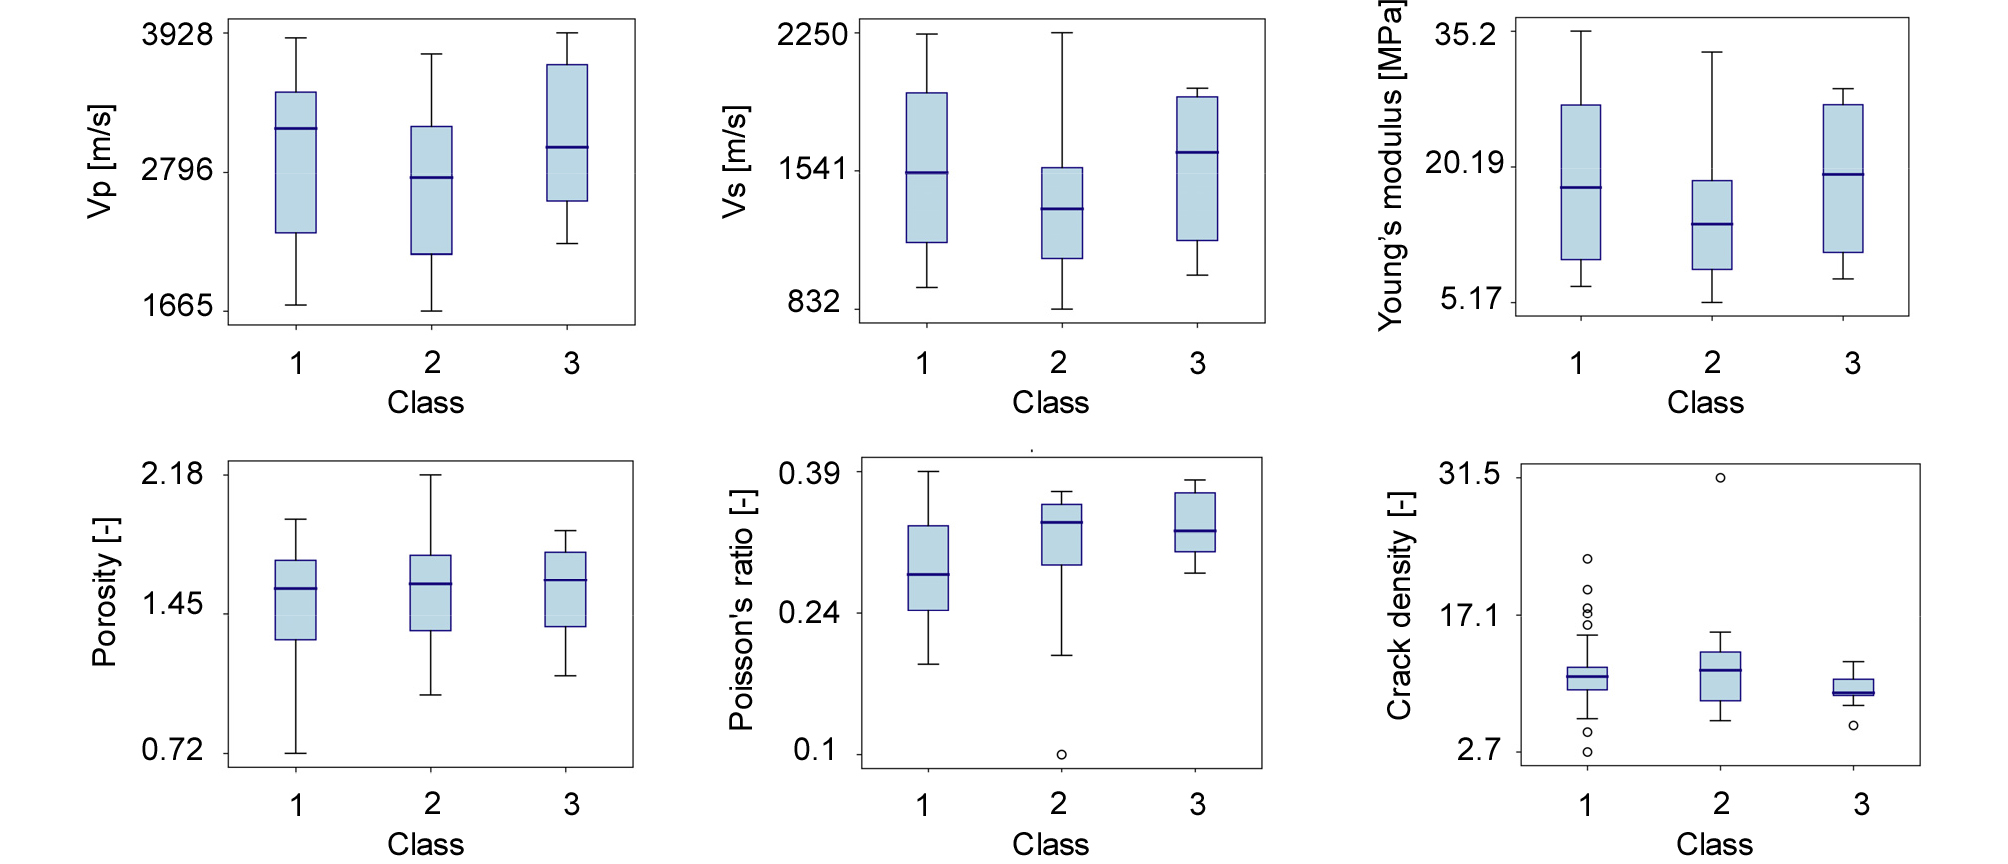
Fig. 1은 데이터 증폭 이전 원본 데이터에 대해 각 Class별 물리량 분포를 Box plot으로 나타낸 결과이며, 각각은 모두 도일한 풍화조건에 기인한다. 전체적으로 압축파 속도(Vp), 전단파 속도(Vs), 영의 계수(Young’s modulus)는 Class 2에서 상대적으로 낮은 중앙값(median)을 보이며, Class 3에서 다시 증가하는 경향을 나타낸다. 특히 Vp와 Vs는 Class 1과 Class 3에서 유사한 수준의 분포를 보이는 반면, Class 2는 중앙값과 상위 사분위수 모두 다소 낮게 나타나 탄성파 속도 특성에서 차이를 보였다. Young’s modulus 역시 유사한 경향을 보이며, Class 2에서 가장 낮은 중앙값을 나타내어 상대적으로 작은 강성 특성을 가지는 것으로 판단된다. 간극률은 세 Class 모두 유사한 분포 범위를 나타내며 중앙값 또한 큰 차이를 보이지 않았다. 다만 Class 1은 최소값과 최대값의 범위가 가장 넓게 분포하여 다른 Class에 비해 데이터 변동성이 상대적으로 큰 것으로 나타났다. 포아송비는 Class 1에서 가장 낮은 중앙값을 보였으며, Class 2와 Class 3에서는 증가하는 경향을 나타냈다. 특히 Class 2에서는 낮은 이상치가 관찰되어 일부 시료에서 현저히 작은 값을 가지는 것으로 확인되었다. 균열밀도는 다른 물리량에 비해 Class 간 차이가 가장 뚜렷하게 나타났다. Class 2는 가장 높은 중앙값을 보였으며, Class 3은 가장 낮은 중앙값과 비교적 좁은 분포 범위를 나타냈다. 또한 Class 1과 Class 2에서는 다수의 이상치가 관찰되어 균열 밀도의 공간적 또는 재료적 불균질성이 존재함을 시사한다. 반면 Class 3은 이상치의 수가 상대적으로 적고 분포 범위 또한 좁게 나타나 보다 균질한 특성을 보였다. 따라서 균열밀도는 Class 구분에 가장 민감하게 반응하는 변수로 판단되며, 포아송비와 Young’s modulus 역시 Class에 따른 분포 차이를 일부 나타내었다. 반면 간극률은Class 간 분포가 상당 부분 중첩되어 구분력이 상대적으로 낮은 것으로 확인되었다. 이러한 결과는 이후 데이터 증폭 과정에서 각 물리량의 분포 특성과 Class별 구조가 얼마나 유지되는지를 평가하는 기준 자료로 활용될 수 있다.
4. 데이터 생성 결과
4.1 K=1, S=0 조건의 하이퍼파라미터
Fig. 2와 3은 제안된 Group-Based Oversampling 알고리즘을 적용하여 생성된 Class 1 및 Class 2 데이터의 확률밀도함수(Probability Density Function)를 원본 데이터와 비교한 결과이다. 본 연구에서는 Class 1이 가장 많은 데이터를 포함하고 있어 증폭 대상에서 제외하였으며, 상대적으로 데이터 수가 부족한 Class 2와 Class 3에 대해서만 데이터 증폭을 수행하였다. 또한 제안 알고리즘의 기본 특성을 확인하기 위하여 최근접 이웃 수 K=1, 난수 시드 S=0조건을 적용하였다. 전체적으로 Class 2와 Class 3 모두에서 생성 데이터의 분포는 원본 데이터가 나타내는 주요 분포 영역 내에서 형성되는 경향을 보였다. 이는 제안 알고리즘이 원본 데이터의 범위를 크게 벗어나지 않는 범위에서 새로운 데이터를 생성하고 있음을 의미한다. 그러나 생성 데이터의 분포 폭은 원본 데이터보다 상대적으로 좁게 나타났으며, 대부분의 물리량에서 특정 구간에 데이터가 집중되는 경향이 확인되었다.
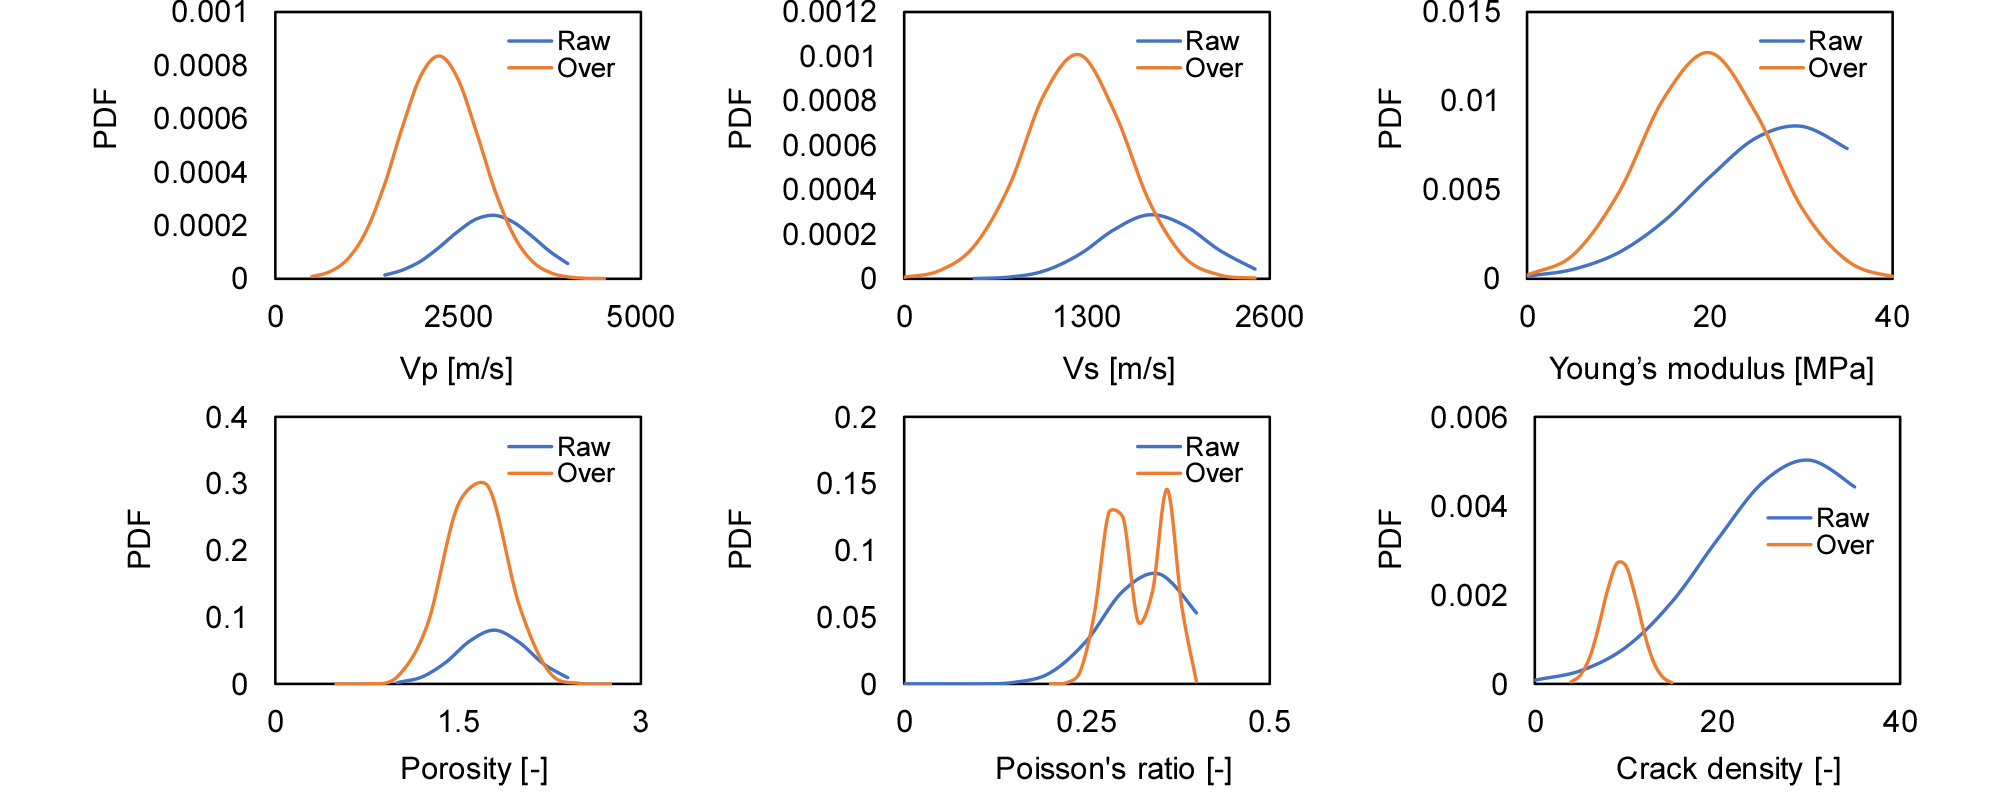
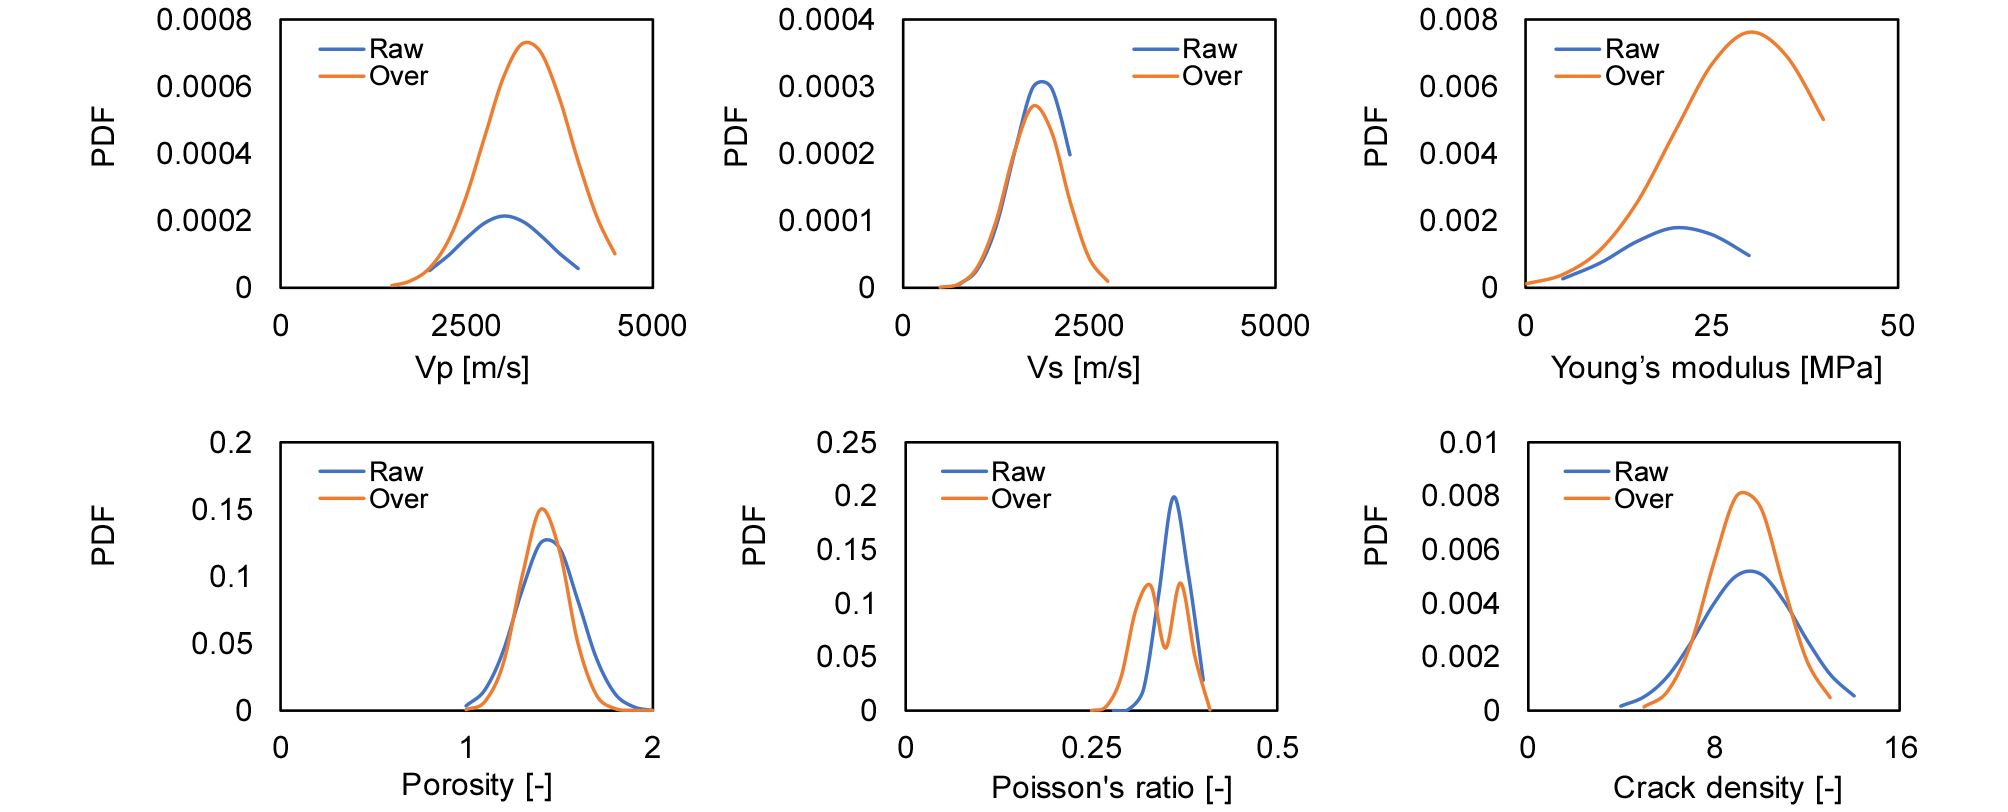
Vp의 경우 Class 2와 Class 3 모두에서 생성 데이터의 분포 중심은 원본 데이터가 가장 많이 분포하는 구간과 유사하게 형성되었으나, 분포 범위는 상대적으로 감소하였다. 특히 원본 데이터에서 나타나는 고속 영역과 저속 영역의 일부 특성이 충분히 재현되지 못하고 중앙 영역에 데이터가 집중되는 경향이 나타났다. Vs 역시 Vp와 유사한 경향을 보였으며, 생성 데이터가 원본 데이터의 평균적인 특성은 유지하였으나 분산은 감소하는 모습을 나타냈다. Young’s modulus 또한 생성 데이터가 원본 데이터의 주요 분포 구간 내에서 형성되었으나, 분포 폭이 감소하면서 중앙값 부근에 데이터가 집중되는 경향이 확인되었다. 간극률의 경우 원본 데이터와 생성 데이터 모두 유사한 중심 위치를 나타내었으며, 다른 물리량에 비해 상대적으로 분포 형상이 잘 유지되는 것으로 나타났다. 포아송비는 다른 변수들과 비교하여 다소 특징적인 결과를 보였다. 원본 데이터는 단일 봉우리 형태를 나타내는 반면, 생성 데이터는 두 개의 봉우리가 형성되는 이중 분포 형태가 일부 관찰되었다. 이는 K=1 조건에서 최근접 이웃 간 보간이 제한적으로 수행되면서 특정 구간에 데이터가 집중된 결과로 판단된다. 균열밀도는 원본 데이터와 생성 데이터 간 차이가 가장 크게 나타난 변수였다. 생성 데이터는 원본 데이터의 낮은 균열밀도 영역에 집중되는 경향을 보였으며, 원본 데이터에서 나타나는 넓은 분포 범위와 고밀도 영역이 충분히 재현되지 못하였다. 특히 Class 2와 Class 3 모두에서 분포 폭이 크게 감소하는 현상이 확인되었다. 따라서 K=1과 S=0 조건에서 제안 알고리즘은 원본 데이터의 평균적인 분포 위치를 유지하면서 새로운 데이터를 생성하는 것으로 나타났다. 그러나 대부분의 물리량에서 분포 폭이 감소하고 특정 구간에 데이터가 집중되는 경향이 확인되었으며, 균열밀도와 포아송비에서는 원본 데이터의 분포 형상이 충분히 재현되지 못하는 한계도 관찰되었다. 이는 최근접 이웃 수가 1인 경우 생성 가능한 데이터의 다양성이 제한되기 때문으로 판단되며, 이후 K 값 및 시드 값 변화에 따른 결과 비교를 통해 제안 알고리즘의 분포 재현성을 추가적으로 검토할 필요가 있다.
4.2 K=1, S=1000 조건의 하이퍼파라미터
K와 S를 각각 1과 1000으로 설정하여 생성한 데이터의 확률밀도함수(PDF) 비교 결과를 Fig. 4와 Fig. 5에 나타내었다. 생성 데이터의 분포 특성을 보다 명확하게 평가하기 위하여 Fig. 2 및 Fig. 3과 동일하게 원본 데이터의 분포를 함께 도시하였다. 분석 결과, 난수 시드를 1000으로 변경한 경우에도 생성 데이터의 전체적인 분포 형상은 S=0 조건에서 얻어진 결과와 큰 차이를 보이지 않았다. 대부분의 물리량에서 생성 데이터는 원본 데이터가 분포하는 범위 내에서 형성되었으며, 분포 중심 또한 원본 데이터와 유사한 위치에 나타났다. 이러한 결과는 난수 시드 변화가 제안 알고리즘의 전반적인 데이터 생성 구조에 미치는 영향이 크지 않으며, 생성된 데이터의 기본적인 통계적 특성이 안정적으로 유지됨을 보여준다.
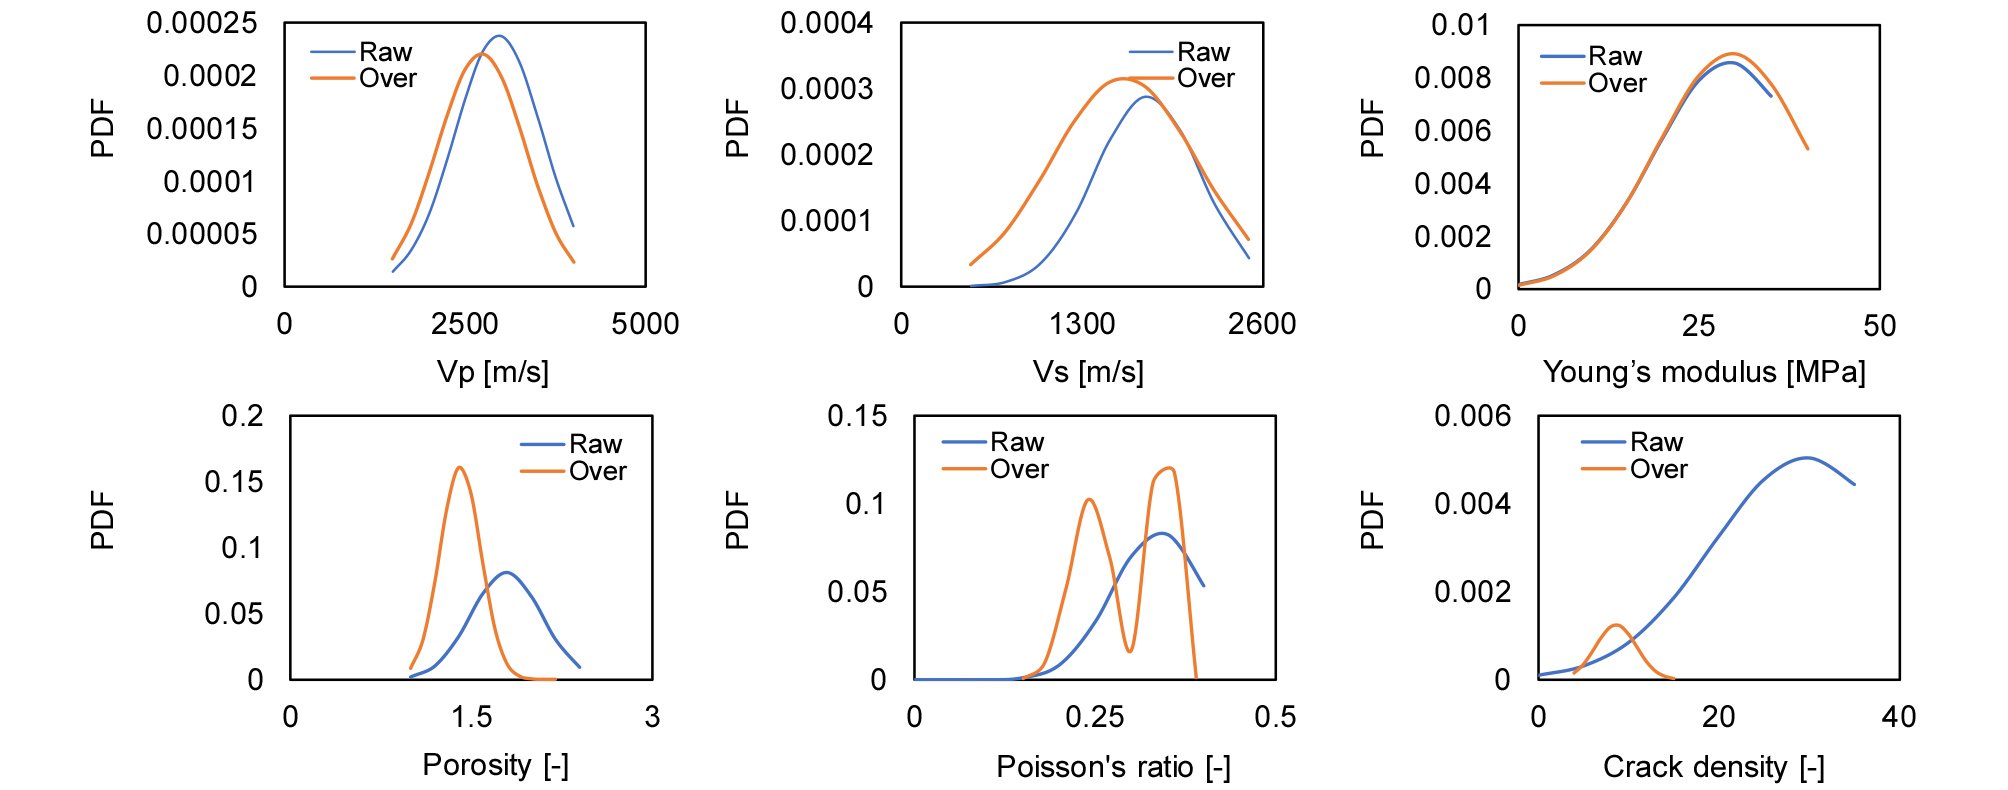
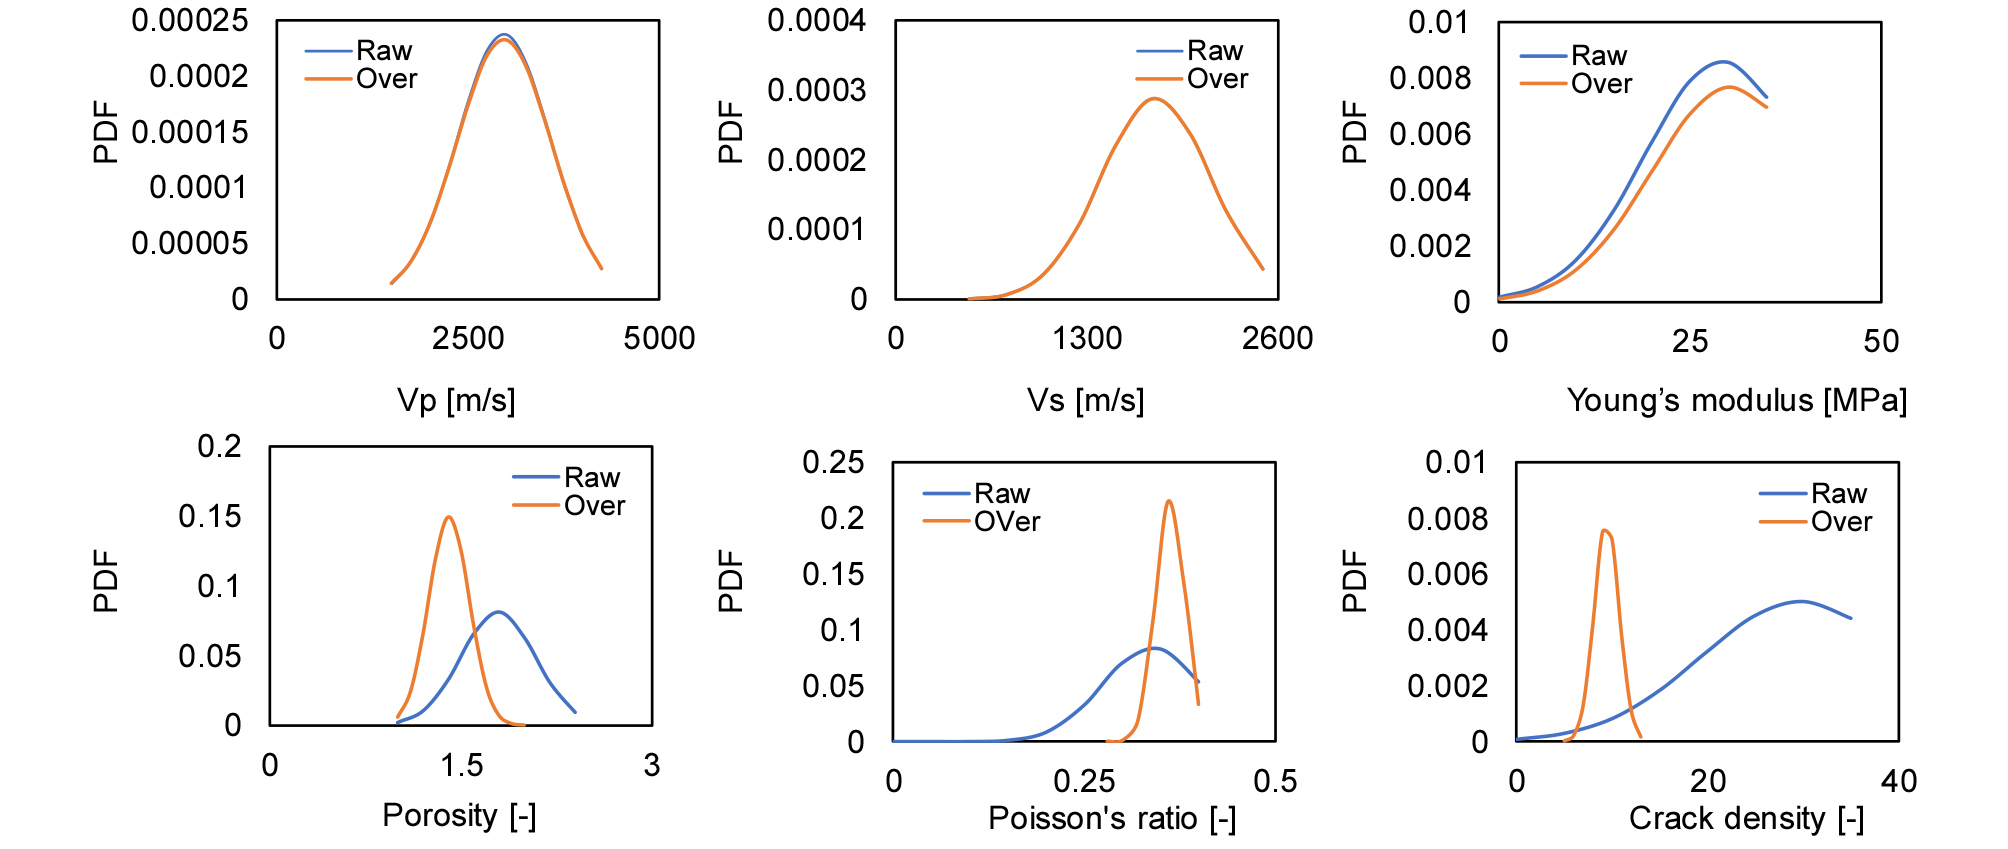
Vp와 Vs는 Class 2와 Class 3 모두에서 원본 데이터의 중심 영역을 비교적 잘 재현하는 것으로 나타났다. 다만 생성 데이터의 분포 범위는 원본 데이터보다 다소 제한적으로 형성되었으며, 특히 분포 양단부에 위치한 데이터의 재현성은 상대적으로 낮게 나타났다. 이는 생성 데이터가 원본 데이터의 대표적인 특성을 유지하면서도 극단값 영역에 대한 표현은 다소 부족함을 의미한다. Young’s modulus의 경우 원본 데이터와 생성 데이터 간 분포 곡선의 중첩 정도가 높게 나타났다. 분포의 중심 위치뿐만 아니라 전체적인 형상 또한 유사하게 유지되어 비교 대상 변수 중 원본 분포를 가장 안정적으로 재현한 물리량으로 판단된다. 반면 간극률은 생성 데이터가 특정 구간에 집중되는 경향을 보였다. 원본 데이터가 비교적 넓은 범위에 걸쳐 분포하는 것과 달리 생성 데이터는 분포 폭이 감소하면서 단일 구간에 밀집되는 형태를 나타냈다. 이는 데이터 증폭 과정에서 일부 분산 정보가 감소하였음을 의미한다. 포아송 비는 S=0 조건에서 관찰된 특성과 유사하게 이중 봉우리 형태의 분포가 나타났다. 원본 데이터가 단일 봉우리 형태를 보이는 것과 달리 생성 데이터는 특정 구간에서 데이터 밀도가 증가하면서 두 개의 분포 중심이 형성되는 경향을 나타냈다. 이러한 현상은 K=1 조건에서 생성 데이터가 제한된 최근접 이웃 정보를 기반으로 생성되기 때문으로 해석될 수 있다. 마지막 물성치인 균열밀도는 원본 데이터와 생성 데이터 간 차이가 가장 크게 나타난 변수였다. 생성 데이터는 상대적으로 낮은 균열밀도 구간에 집중되어 분포하였으며, 원본 데이터가 나타내는 넓은 분포 범위와 높은 균열밀도 영역은 충분히 반영되지 못하였다. 그 결과 생성 데이터의 분포 폭은 원본 데이터보다 현저히 축소되는 경향을 보였다. 결과적으로 K=1, S=1000 조건에서 생성된 데이터는 K=1, S=0 조건에서 생성된 데이터와 매우 유사한 분포 특성을 나타냈다. 대부분의 물리량에서 원본 데이터의 주요 분포 구간은 유지되었으나, 분포 폭 감소와 특정 영역으로의 데이터 집중 현상 또한 동일하게 관찰되었다. 특히 포아송 비와 균열밀도는 원본 데이터와의 차이가 상대적으로 크게 나타났다. 이러한 결과는 동일한 최근접 이웃 수를 사용하는 경우 난수 시드의 변화가 생성 데이터의 구조적 특성에 미치는 영향은 제한적이며, 생성 데이터의 분포 형상은 시드 값보다는 최근접 이웃 수(K)의 설정에 의해 보다 크게 영향을 받음을 시사한다.
4.3 K=5, S=0 조건의 하이퍼파라미터
K와 S가 각각 5 및 0 인 조건에서 생성된 결과는 Fig. 6과 7에 도시하였다. K=5조건에서는 앞서 분석한 K=1 조건에 비해 생성 데이터의 분포가 보다 매끄러운 형태를 나타내는 경향이 확인되었다. 생성 데이터는 대부분 원본 데이터가 분포하는 영역 내에서 형성되었으며, 일부 변수에서는 원본 데이터의 중심 위치를 비교적 안정적으로 재현하는 모습을 보였다. 이는 최근접 이웃 수 증가에 따라 데이터 생성 시 활용되는 참조 정보가 확대되면서 특정 샘플에 대한 의존성이 감소한 결과로 판단된다. Class 2의 경우 Vp, Vs 및 Young’s modulus는 원본 데이터와 생성 데이터의 분포 중심이 비교적 유사하게 유지되었다. 특히 Young’s modulus는 원본 데이터와 생성 데이터의 분포 곡선이 상당 부분 중첩되어 나타났으며, 이전 조건에서 관찰되었던 분포 중심의 편차가 다소 감소하는 경향을 보였다. 반면 간극률, 포아송 비 그리고 균열밀도는 여전히 원본 데이터보다 좁은 분포 범위를 나타내었으며, 일부 변수에서는 특정 구간에 데이터가 집중되는 현상이 확인되었다. Class 3에서도 유사한 경향이 나타났다. Vp와 Vs는 원본 데이터의 전체적인 분포 형태를 비교적 안정적으로 유지하였으며, Young’s modulus 또한 원본 데이터의 주요 분포 영역 내에서 생성 데이터가 형성되었다. 그러나 간극률과 균열밀도는 생성 데이터가 특정 범위에 집중되는 경향이 지속적으로 나타났으며, 포아송 비 역시 원본 데이터보다 좁은 분포를 형성하는 것으로 확인되었다.
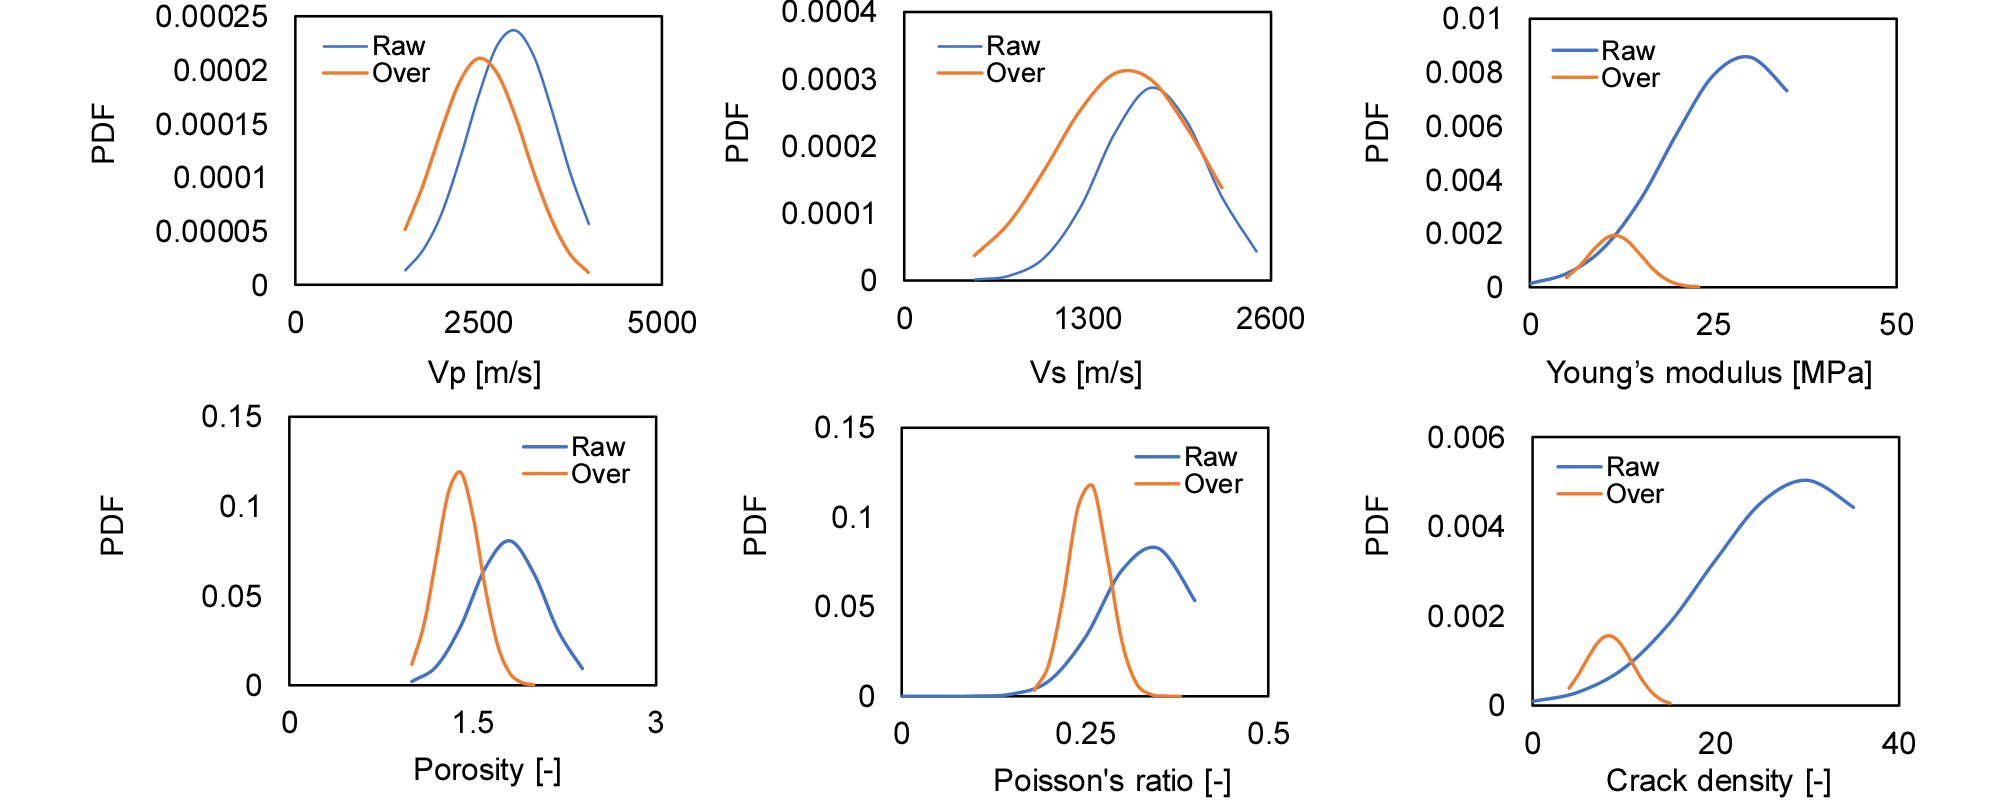
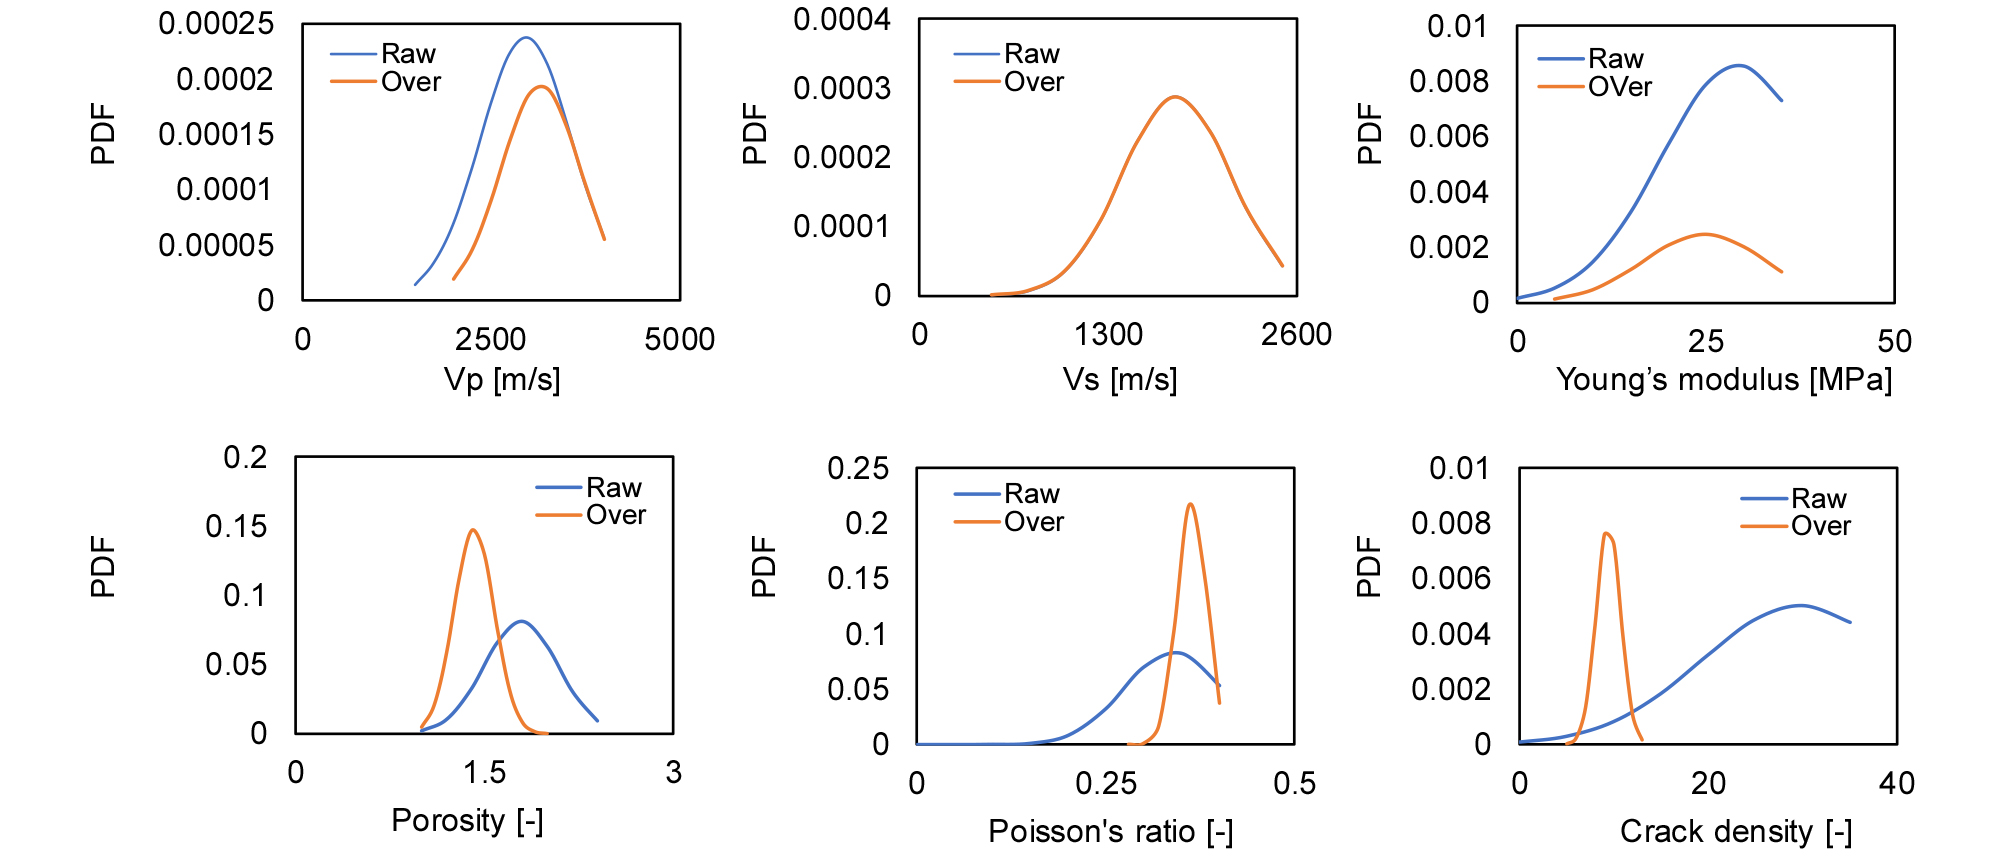
특히 K=1 조건에서 일부 변수에서 관찰되었던 이중 분포 현상은 K=5 조건에서 다소 완화되는 경향을 보였다. 이는 최근접 이웃 수 증가에 따라 데이터 생성 과정에서 보다 다양한 샘플이 활용되면서 특정 구간으로의 집중 현상이 감소하였기 때문으로 판단된다. 반면 분포 폭 자체는 여전히 원본 데이터보다 감소하는 경향을 나타내어, 생성 데이터가 원본 데이터의 평균적 특성은 유지하나 극단값 영역까지 충분히 재현하지는 못하는 것으로 확인되었다. 결국 K=5 조건은 K=1 조건에 비해 보다 안정적이고 연속적인 분포를 생성하는 경향을 나타냈다. 특히 탄성파 속도(Vp, Vs) 및 Young’s modulus와 같은 변수에서는 원본 데이터와의 분포 유사성이 향상되는 모습을 보였으며, 생성 데이터의 국부적 집중 현상도 일부 감소하였다. 반면 간극률, 포아송 비 그리고 균열밀도에서는 여전히 원본 데이터와의 차이가 관찰되었으며, 생성 데이터의 분포 범위가 제한되는 특성이 유지되었다. 따라서 최근접 이웃 수의 증가는 생성 데이터의 안정성을 향상시키는 데 기여하지만, 모든 변수에 대해 원본 데이터의 분포 특성을 완전하게 재현하는 것은 아닌 것으로 판단된다.
5. 토 론
5.1 평균 차이율 및 표준편차 유지율
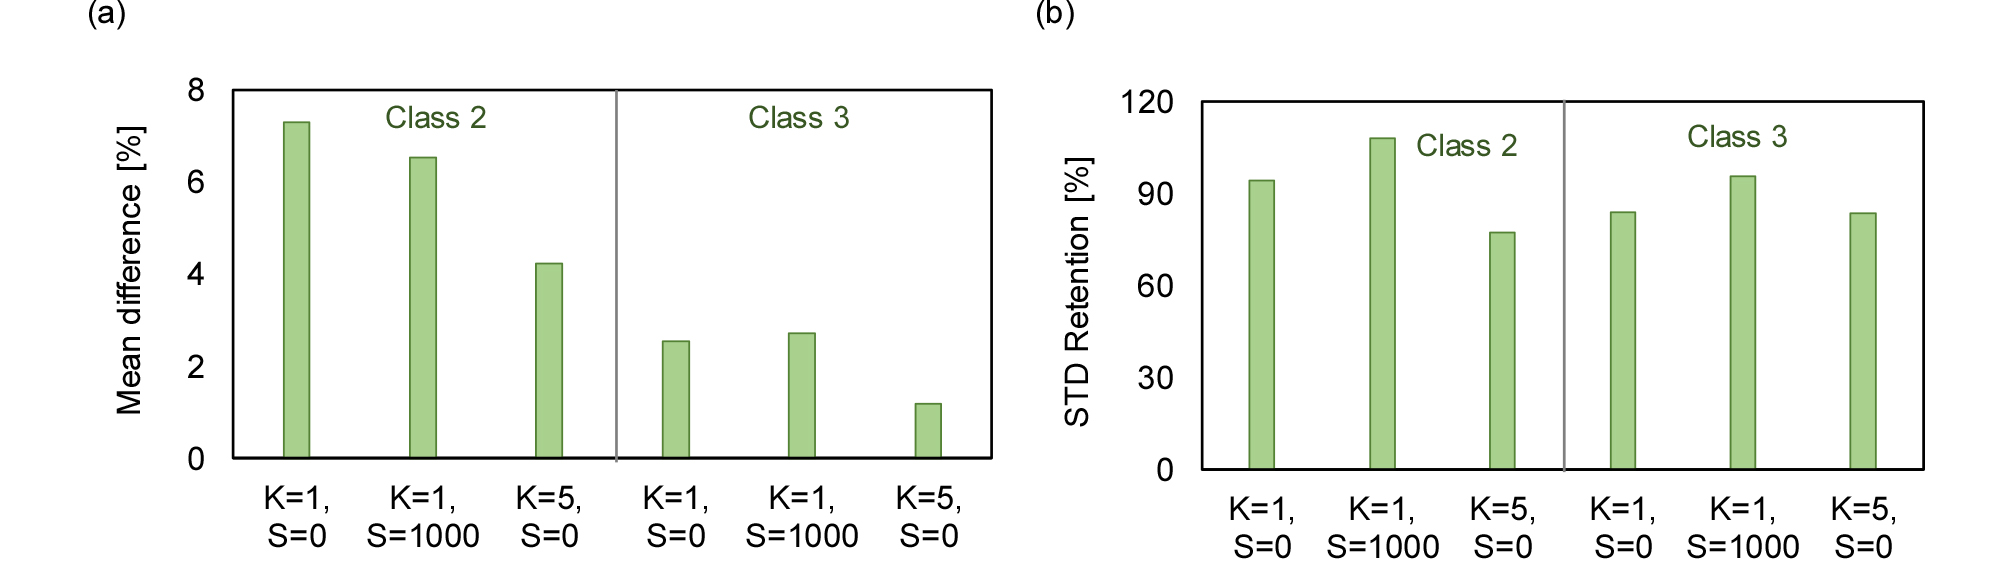
Fig. 8은 앞서 PDF 기반의 정성적 비교 결과를 정량적으로 검증하기 위해 평균 차이율(Mean Difference)과 표준편차 유지율(Standard Deviation Retention)을 계산한 결과를 나타낸 것이다. Mean Difference는 생성 데이터의 평균값이 원본 데이터의 평균값으로부터 얼마나 벗어났는지를 나타내며, 값이 작을수록 원본 데이터의 중심 경향을 잘 보존하고 있음을 의미한다. 반면 STD Retention은 생성 데이터의 표준편차를 원본 데이터의 표준편차와 비교한 값으로, 100%에 가까울수록 원본 데이터의 변동성을 잘 유지하고 있음을 의미한다. Fig. 8(a)의 Mean Difference 결과를 살펴보면, Class 2에서는 K=1, S=0 조건에서 약 7.3%, K=1, S=1000 조건에서 약 6.5%, K=5, S=0 조건에서 약 4.2%의 평균 차이를 나타냈다. 반면 Class 3에서는 각각 약 2.5%, 2.7%, 1.2% 수준으로 나타나 모든 조건에서 Class 2보다 작은 평균 차이를 보였다. 특히 K=5, S=0 조건에서 두 Class 모두 가장 낮은 Mean Difference를 나타내어 원본 데이터의 평균 특성을 가장 효과적으로 재현하는 것으로 확인되었다. 또한 동일한 K=1 조건에서 시드 값을 0에서 1000으로 변경하였을 때 Mean Difference의 변화는 크지 않은 것으로 나타났다. 이는 생성 데이터의 평균적 특성이 난수 시드보다는 최근접 이웃 수(K)의 영향을 더 크게 받음을 의미한다. Fig. 8(b)의 STD Retention 결과에서는 다소 다른 경향이 관찰되었다. Class 2의 경우 K=1, S=1000 조건에서 약 108%로 가장 높은 값을 나타냈으며, K=1, S=0 조건에서는 약 94%, K=5, S=0 조건에서는 약 77% 수준으로 감소하였다. Class 3에서도 K=1, S=1000 조건이 약 96%로 가장 높은 값을 나타냈으며, K=1, S=0 및 K=5, S=0 조건은 각각 약 84% 수준으로 나타났다. 이는 K=5 조건이 평균값 보존 측면에서는 우수하지만 데이터의 분산 특성은 다소 감소시키는 경향이 있음을 보여준다. 반대로 K=1, S=1000 조건은 평균 오차는 다소 존재하지만 원본 데이터의 변동성을 가장 잘 유지하는 것으로 나타났다. 결국K가 증가함에 따라 생성 데이터의 평균 특성은 원본 데이터에 더욱 가까워지는 경향을 보였으나, 동시에 분산 특성은 감소하는 경향이 확인되었다. 반면 시드 값의 변화는 평균 차이와 표준편차 유지율 모두에서 상대적으로 작은 영향을 나타냈다. 따라서 제안된 알고리즘에서 생성 데이터의 구조적 특성을 결정하는 주요 인자는 난수 시드보다는 최근접 이웃 수(K)로 판단되며, 평균값 보존과 분산 유지 사이의 균형을 고려한 하이퍼파라미터 선정이 필요할 것으로 판단된다. 또한 Class 3이 모든 조건에서 Class 2보다 낮은 Mean Difference를 나타낸 점은 주목할 만하다. 이는 Class 3의 원본 데이터 분포가 상대적으로 집중되어 있어 데이터 생성 과정에서 분포 재현이 용이했기 때문으로 해석될 수 있다. 반면 Class 2는 상대적으로 넓은 분포 범위와 큰 변동성을 포함하고 있어 생성 데이터가 원본 데이터의 통계적 특성을 완전히 재현하는 데 더 큰 어려움이 있었던 것으로 판단된다. 이러한 결과는 이후 각 물리량별 Mean Difference 및 STD Retention 분석을 통해 보다 구체적으로 확인할 수 있을 것으로 기대된다.
5.2 생성된 개별 물리량의 거동 분석
Fig. 9는 생성된 데이터와 원본 데이터 간의 통계적 유사성을 보다 세부적으로 분석하기 위하여 각 물리량별 Mean Difference와 Standard Deviation Retention을 비교한 결과이다. Fig. 9(a)와 (b)의 Mean Difference 결과를 살펴보면 Class 2와 Class 3 모두에서 물리량에 따라 생성 데이터의 재현성이 다르게 나타났다. Class 2에서는 Young’s modulus가 가장 큰 평균 차이를 나타냈으며, K=1, S=1000 조건에서 약 17% 이상의 차이를 보여 가장 높은 민감도를 나타냈다. 반면 간극률은 모든 조건에서 약 5% 이하의 평균 차이를 보였으며, 특히 K=1, S=1000 및 K=5, S=0 조건에서는 2% 이하의 차이를 나타내어 원본 데이터의 평균 특성이 비교적 안정적으로 유지되었다. 균열밀도 역시 조건에 따라 큰 차이를 보였는데, K=1, S=1000에서는 거의 차이가 발생하지 않은 반면 K=1, S=0 및 K=5, S=0에서는 약 10% 이상의 차이를 나타냈다. 이는 동일한 알고리즘이라 하더라도 특정 변수는 하이퍼파라미터 변화에 민감하게 반응할 수 있음을 보여준다. Class 3에서는 전반적으로 Mean Difference가 Class 2보다 낮게 나타났다. 대부분의 물리량에서 평균 차이가 6% 이하로 유지되었으며, 포아송 비와 균열밀도는 일부 조건에서 1% 이하의 매우 작은 차이를 보였다. 특히 K=5, S=0 조건에서는 Vp, Vs, 간극률 및 포아송비가 모두 1% 내외의 평균 차이를 나타내어 원본 데이터의 중심 특성을 효과적으로 재현하는 것으로 확인되었다. 이러한 결과는 앞서 Fig. 8에서 확인된 바와 같이 Class 3의 데이터 구조가 Class 2보다 상대적으로 안정적으로 재현되고 있음을 뒷받침한다.
Fig. 9(c)와 (d)는 표준편차 유지율을 비교한 결과이다. Class 2에서는 변수별 편차가 비교적 크게 나타났다. Vp, Vs, Young’s modulus 및 간극률은 일부 조건에서 100%를 초과하는 값을 나타내어 생성 데이터가 원본 데이터보다 더 큰 변동성을 갖는 경우도 확인되었다. 반면 균열밀도는 모든 조건에서 약 60~75% 수준에 머물러 원본 데이터의 변동성을 충분히 재현하지 못하는 것으로 나타났다. 특히 포아송비는 K=1, S=0 조건에서 약 50% 수준까지 감소하였으나 K=1, S=1000 조건에서는 약 100% 수준까지 증가하여 하이퍼파라미터 변화에 따른 민감성이 가장 크게 나타난 변수 중 하나로 확인되었다. Class 3에서는 전반적으로 모든 물리량이 약 70~100% 범위 내에서 분포하였다. Class 2와 비교할 때 변수 간 편차가 상대적으로 작게 나타났으며, 특정 변수에서 과도하게 높거나 낮은 표준편차 유지율은 관찰되지 않았다. 특히 포아송비는 모든 조건에서 약 85~95% 수준을 유지하였으며, 간극률 역시 비교적 안정적인 유지율을 나타냈다. 반면 균열밀도는 다른 변수들에 비해 상대적으로 낮은 유지율을 보였으며, 이는 앞서 PDF 분석에서 확인된 분포 폭 감소 현상과 일치하는 결과이다.
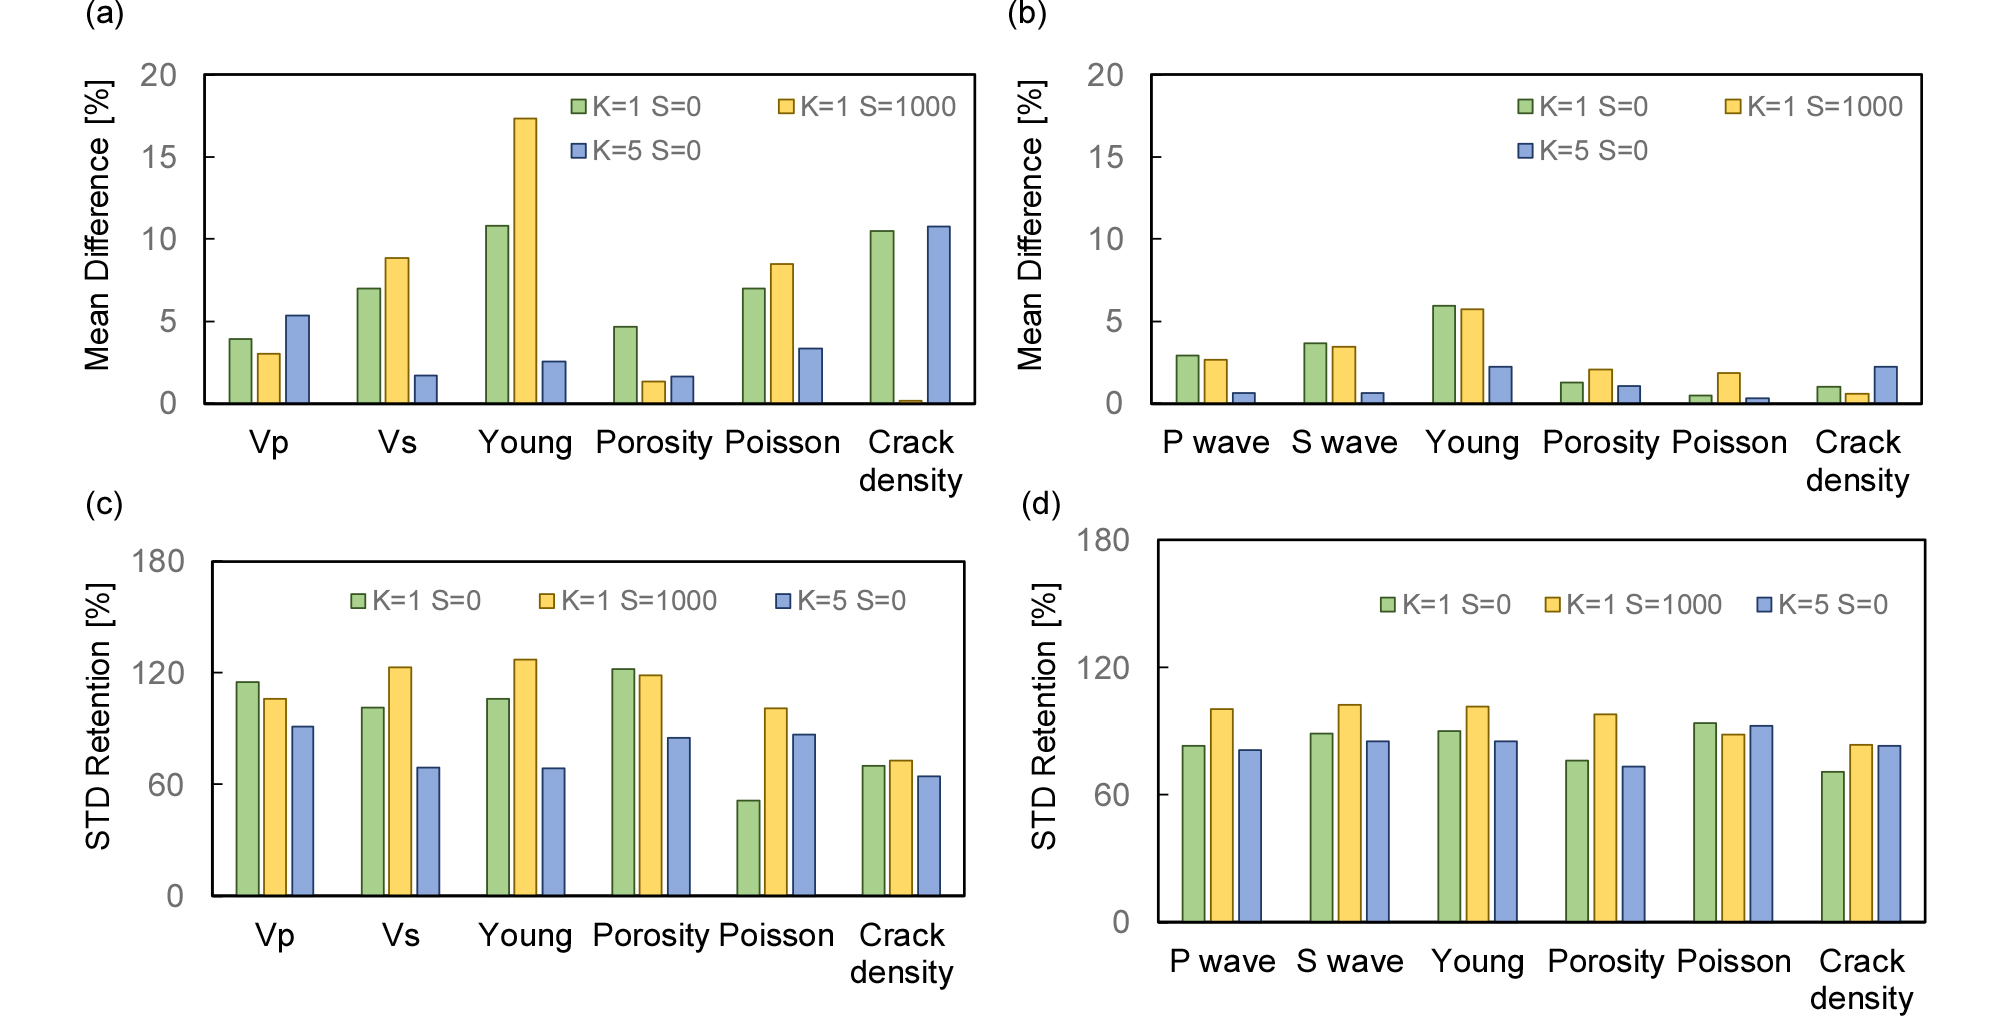
결과적으로 Mean Difference 관점에서는 K=5, S=0 조건이 가장 우수한 경향을 나타냈으며, 특히 Class 3에서 원본 데이터 평균을 효과적으로 재현하는 것으로 확인되었다. 반면 Standard Deviation Retention 관점에서는 K=1, S=1000 조건이 상대적으로 높은 유지율을 나타내어 원본 데이터의 변동성을 가장 잘 보존하는 것으로 분석되었다. 또한 변수별 분석 결과, 간극률과 포아송 비는 비교적 안정적으로 재현된 반면, Young’s modulus와 균열밀도는 하이퍼파라미터 변화에 따른 영향이 크게 나타났다. 이는 데이터 증폭 과정에서 모든 물리량이 동일한 수준으로 재현되는 것이 아니라 변수의 분포 특성과 구조적 복잡성에 따라 재현 정도가 달라질 수 있음을 의미한다. 따라서 제안된 Group-Based Oversampling 기법의 성능을 평가할 때에는 단순히 전체 데이터의 통계적 특성뿐만 아니라 개별 물리량 수준에서의 평균 및 분산 보존 특성을 함께 고려할 필요가 있는 것으로 판단된다.
6. 결 론
본 연구에서는 데이터 불균형 문제를 해결하기 위해 널리 활용되고 있는 SMOTE 기반 데이터 증폭 기법의 한계를 개선하고자 Distance Correlation 기반 Group-Based Oversampling 기법을 제안하였다. 기존 Oversampling 기법은 모든 변수를 하나의 특징 공간에서 동시에 처리하기 때문에 변수 간 상관구조가 충분히 고려되지 않을 수 있다. 이에 본 연구에서는 변수 간 비선형 의존성을 Distance Correlation을 이용하여 정량화하고, 계층적 군집분석을 통해 유사한 특성을 갖는 변수들을 그룹화한 후 그룹 단위로 데이터를 생성하는 방법을 제안하였으며, 세부적인 결과는 다음과 같다.
(1) 생성 데이터는 대부분의 물리량에서 원본 데이터의 주요 분포 영역을 유지하는 것으로 나타났다. 특히 Mean Difference 분석 결과 K=5, S=0 조건에서 가장 낮은 평균 오차를 나타내어 원본 데이터의 중심 경향을 가장 효과적으로 재현하는 것으로 확인되었다. 반면 Standard Deviation Retention 분석에서는 K=1, S=1000 조건이 가장 높은 값을 나타내어 원본 데이터의 변동성을 상대적으로 잘 보존하는 것으로 나타났다. 이러한 결과는 평균 특성 보존과 분산 특성 보존 사이에 일정 수준의 상충 관계가 존재함을 보여준다.
(2) 또한 하이퍼파라미터 영향 분석 결과, 난수 시드(S)의 변화는 생성 데이터의 전체적인 분포 특성에 제한적인 영향을 미친 반면, 최근접 이웃 수(K)의 변화는 평균 차이율과 표준편차 유지율 모두에 상대적으로 큰 영향을 미치는 것으로 확인되었다. 이는 생성 데이터의 구조적 특성이 시드 값보다는 최근접 이웃 설정에 의해 결정됨을 의미한다.
(3) 개별 물리량 분석 결과에서는 변수별 재현성에 차이가 존재하였다. 간극률과 포아송 비는 비교적 안정적으로 재현되었으나, Young’s modulus와 균열밀도는 하이퍼파라미터 변화에 따라 상대적으로 큰 변동을 나타냈다. 특히 균열밀도는 모든 조건에서 원본 데이터 대비 분포 폭이 감소하는 경향을 보여 데이터 증폭 과정에서 재현이 어려운 변수로 확인되었다.
본 연구에서 제안한 Group-Based Oversampling 기법은 단순히 데이터 개수를 증가시키는 기존 Oversampling 기법과 달리 변수 간 구조적 관계를 고려하여 데이터를 생성한다는 점에서 차별성을 가진다. 또한 생성 데이터의 평균 및 분산 특성을 정량적으로 평가함으로써 제안 기법의 신뢰성을 검증하였다. 향후 연구에서는 Pearson Correlation, Distance Correlation, 공분산 행렬 및 PCA 기반 분석 등을 활용하여 변수 간 구조 보존 능력을 보다 정량적으로 평가할 필요가 있다. 또한 다양한 지반공학 및 재료공학 데이터셋에 제안 기법을 적용하여 일반화 가능성을 검증하고, 데이터 증폭 이후 인공지능 모델의 예측 성능 향상 효과를 추가적으로 분석할 필요가 있을 것으로 판단된다.