

1. 서 론
2. 연구 데이터
2.1 JIS GPR 영상
2.2 JIS 굴착 기록
3. 연구 방법
3.1 단독 탐지 모델
3.2 현장 단위 후기 융합과 평가 지표
4. 결과 및 분석
4.1 단독 모델의 영상 단위 성능
4.2 후기 융합의 탐지율과 오탐
5. 결 론
1. 서 론
도심지의 지하공동은 지반침하와 지반함몰로 이어질 수 있는 주요 위험요인이다. 지하안전정보시스템(JIS, Underground Safety Information System)에는 지반침하 사고가 지속적으로 집계되고 있으며(MOLIT, 2026), 「지하안전관리에 관한 특별법」은 지하의 안전한 개발·이용과 지반침하 예방을 위한 관리체계를 규정하고 있다(MOLEG, 2016). 따라서 지하공동을 비파괴적으로 선별하고 조사 우선순위를 합리적으로 설정하는 기술은 지하안전관리의 핵심 기반이다.
지표투과레이더(Ground-Penetrating Radar, GPR)는 전자파의 반사 특성을 이용하여 지하 구조를 영상화하는 대표적인 비파괴 탐사기법이다. GPR 자료는 탐사 진행 방향의 깊이 단면인 B-scan과 특정 깊이의 수평 단면인 C-scan으로 표현할 수 있다. 딥러닝 기반 GPR 자동 해석 연구는 주로 B-scan 영상에서 공동 반사 신호를 탐지하는 방향으로 발전해 왔으며, 국내에서도 도심 도로와 터널을 대상으로 적용 사례가 축적되고 있다(Bae et al., 2023; Choi et al., 2022; Hwang and Lee, 2024; Lee et al., 2025). 국외에서는 Faster R-CNN(region-based convolutional neural network)을 이용한 도로 하부 이상 신호 탐지(Gao et al., 2020), 현장 GPR 자료 기반 공동 및 균열 탐지(Li et al., 2022), Swin Transformer를 결합한 YOLOv5(You Only Look Once version 5) 기반 공동 실시간 탐지(Zhang et al., 2024) 등이 보고되었다.
한편, B-scan과 C-scan을 함께 활용하려는 연구도 진행되어 왔다. C-scan은 공동의 수평적 범위와 연속성 정보를 제공하므로 B-scan의 깊이 단면 정보와 상호 보완적이다. 3차원 GPR 자료의 B-scan과 C-scan을 격자 영상으로 구성하여 CNN(convolutional neural network)에 입력하는 방법이 제안되었고(Kang et al., 2020), C-scan에서 공동 후보를 선별한 뒤 대응하는 B-scan으로 확인하는 순차 판정 절차도 제시되었다(Luo and Lai, 2020). 또한 3차원 반사 패턴을 3D-CNN(three-dimensional convolutional neural network)으로 직접 학습하여 2차원 모델보다 높은 성능을 보인 사례가 보고되었다(Yamaguchi et al., 2022). 공동의 위치와 규모를 해석자에게 공개하지 않은 블라인드 시험에서는 탐지 성능을 실물 기준자료로 검증할 필요성도 제시되었다(Lai et al., 2018). 그러나 이들 연구는 두 영상을 입력 단계에서 결합하거나 3차원 특징을 직접 학습하는 방식에 주로 초점을 두었다.
후기 융합(late fusion)은 이와 달리 영상별로 독립 학습한 탐지기의 판정 결과를 최종 의사결정 단계에서 결합하는 방법으로, 개별 모델을 다시 학습하지 않고도 두 영상의 상호 보완성을 활용할 수 있다. Kittler et al.(1998)은 분류기 결합에 관한 이론적 틀을 정립하였으며, 비파괴검사 결함 판정에서도 오탐 감소 효과가 확인되었다(Heideklang and Shokouhi, 2016). OR 규칙은 어느 한 탐지기라도 공동을 탐지하면 공동 후보로 판정하므로 미탐 감소에 유리하며, AND 규칙은 두 탐지기가 모두 공동을 탐지한 경우에만 공동 후보로 판정하므로 오탐 억제에 유리하다. 개별 탐지 증거를 하나의 결합 신뢰도로 통합하는 noisy-OR 규칙도 다중 인스턴스 분류에서 검토된 바 있다(Alpaydın et al., 2015). 그러나 동일 현장의 B-scan과 C-scan에 대해 독립적으로 학습한 탐지기의 출력을 현장 단위로 후기 융합하고, 그 성능을 실굴착 기록으로 검증한 연구는 제한적이다.
따라서 본 연구에서는 JIS GPR 영상을 이용하여 B-scan과 C-scan용 YOLOv8s 탐지기를 각각 학습하고, 두 탐지 결과를 현장 단위에서 OR, noisy-OR, AND 규칙으로 결합하는 후기 융합 절차를 구축하였다. 실굴착으로 공동이 확인된 기록을 이용하여 탐지율을 평가하고, 공동 라벨이 없는 시험 현장을 대상으로 오탐 특성을 분석하였다. 또한 공동 체적에 따른 크기 등급별 탐지 결과를 비교하여 두 스캔의 상호 보완 양상을 분석하였다. 평가는 학습에 포함되지 않은 시험셋에 대한 영상 단위 성능 평가와 실굴착으로 공동이 확인된 기록에 대한 현장 단위 검증의 두 단계로 수행하였으며, 주요 평가 결과에는 95% 신뢰구간을 함께 제시하였다.
2. 연구 데이터
2.1 JIS GPR 영상
원자료는 2019~2021년 JIS 탐사 영상 중 B-scan 또는 C-scan을 보유한 41개 현장의 영상 1,224장으로 구성되며, 이 중 B-scan은 927장, C-scan은 297장이다. YOLO 라벨에는 총 1,251개의 바운딩 박스가 포함되어 있고, 클래스(class)별로 공동 570개, 맨홀 624개, 배관 57개이다. 이 중 B-scan과 C-scan을 모두 보유한 현장은 36개였으며, B-scan만 보유한 현장은 4개, C-scan만 보유한 현장은 1개였다. 본 연구에서는 두 스캔을 모두 이용할 수 있는 36개 현장을 분석 대상으로 선정하였다.
분석 대상 36개 현장에서 B-scan은 846장이며 공동 423개와 맨홀 450개의 라벨을 포함한다. C-scan은 291장이며 공동 102개, 맨홀 138개, 배관 51개의 라벨을 포함한다(Table 1). 따라서 B-scan 모델은 공동·맨홀의 2-클래스 체계로, C-scan 모델은 공동, 맨홀, 배관의 3-클래스 체계로 구성하였다. 분석 대상 영상은 B-scan과 C-scan을 합하여 총 1,137장이며, 본 논문에서는 하부 공동 탐지 성능 평가를 목표로 하므로 맨홀과 배관에 대한 분석을 제외하였다.
Table 1.
Overview of the JIS data
| Category | Site | Image | Cavity | Manhole | Pipe |
| B-scan | 36 | 846 | 423 | 450 | - |
| C-scan | 36 | 291 | 102 | 138 | 51 |
JIS 원자료에서 B-scan 영상은 256×256 화소, C-scan 영상은 80×80 화소의 해상도를 가진다(Fig. 1). C-scan은 3차원 GPR 자료에서 특정 깊이의 수평 단면을 추출한 것으로, 해상도가 낮은 것은 수평면의 표본 밀도가 진행 방향 단면의 표본 밀도에 비해 상대적으로 낮기 때문이다. Fig. 1에서 C-scan이 상대적으로 거칠게 보이는 것은 이러한 원 해상도 차이에 따른 것이며, 학습·검증·시험의 모든 단계에서는 두 영상을 YOLOv8의 표준 입력 크기인 640×640으로 확대하여 사용하였다.
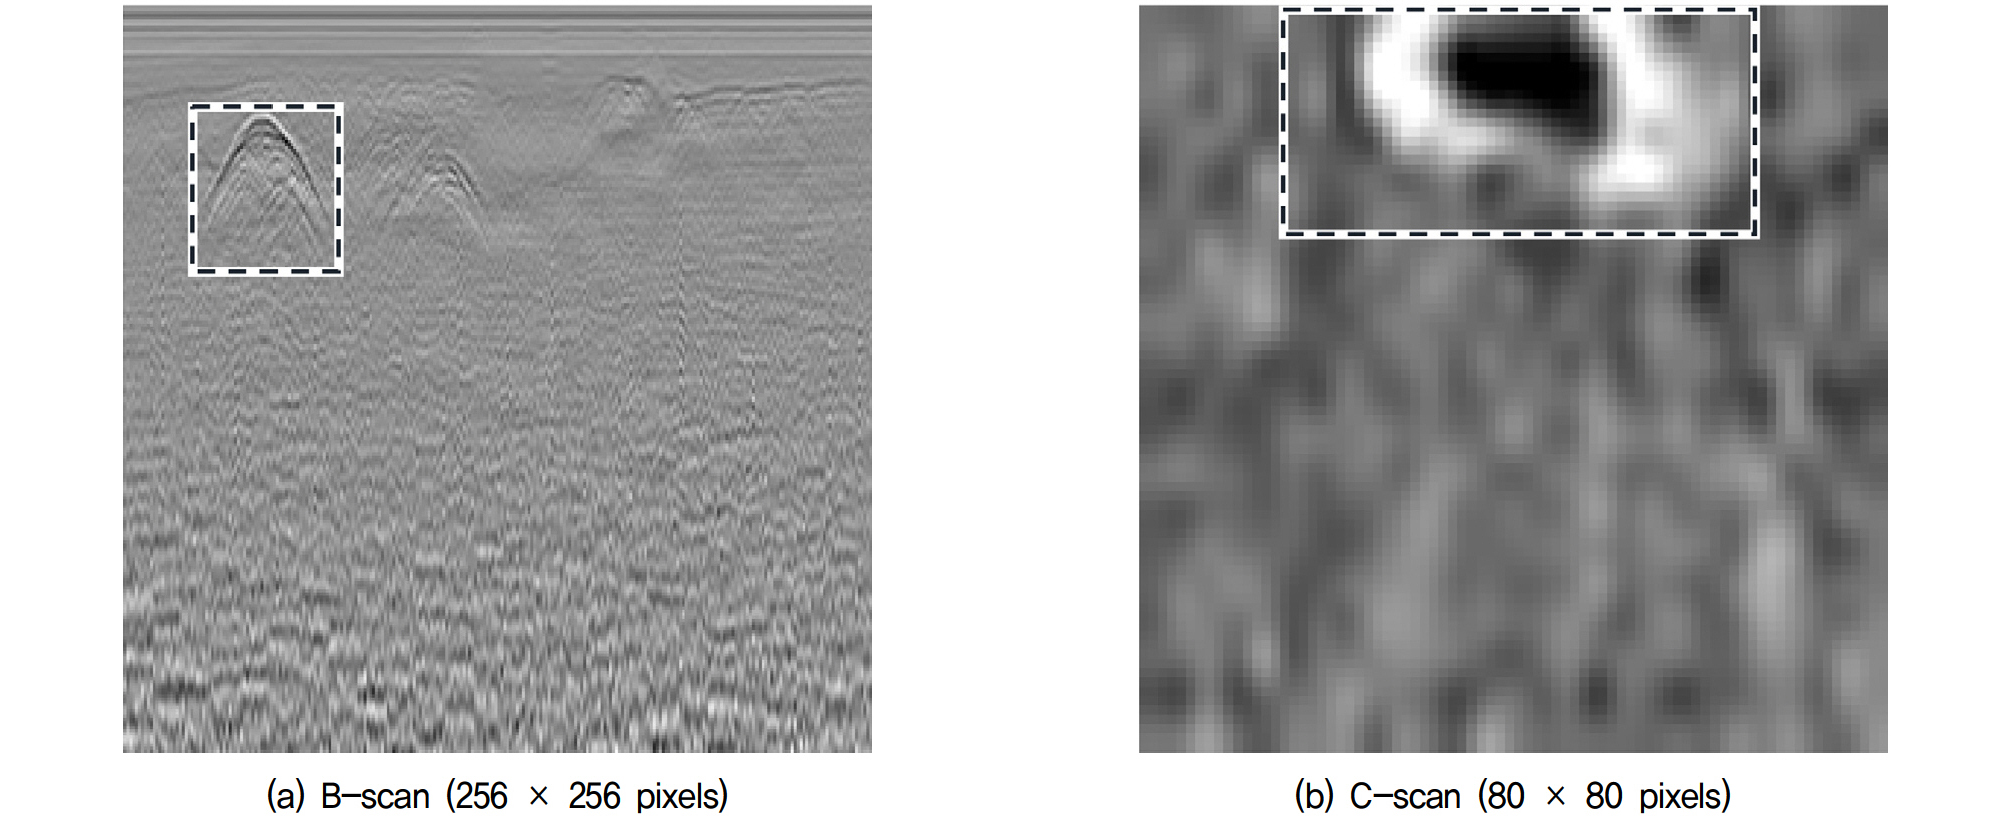
분석 대상 현장은 2019년 11개, 2020년 1개, 2021년 24개 현장으로, 지반침하 안전점검 보고서에 따르면 도시부 아스팔트 포장 도로에서 차량 탑재형 3차원 GPR로 탐사한 구간이다. B-scan은 다채널 배열 안테나의 채널별 종단면이고 C-scan은 깊이별 수평 단면으로, 두 영상 모두 같은 3차원 탐사 자료에서 추출되었다.
2.2 JIS 굴착 기록
JIS의 굴착 자료는 총 24개의 굴착 기록으로 구성된다. 이 중 B-scan과 C-scan 자료를 모두 이용할 수 있는 21개 기록을 탐지 성능 검증에 활용하였다. 나머지 3개 굴착 기록은 두 스캔 자료를 모두 이용할 수 없어 탐지 성능 검증에서 제외하였다. 검증에 사용한 21개 굴착 기록은 총 19개 현장에서 획득되었으며, 이 중 2개 현장에는 각각 2개의 굴착 기록이 있다. 오탐 평가는 공동 라벨과 굴착 기록이 모두 없는 3개 현장을 대상으로 수행하였다.
공동 크기 구분 기준은 현장 단위 탐지 성능 검증에 사용한 21개 기록이 아니라 전체 굴착 기록 24개의 체적 자료를 이용하여 설정하였다. 24개의 체적 자료에서 하위 25%와 상위 25%의 경계는 각각 0.266 m3와 0.549 m3이며, 이를 기준으로 소형(<0.266 m3), 중형(0.266~0.549 m3), 대형(>0.549 m3)으로 구분하였다. 전체 24개 기록은 소형 6개, 중형 12개, 대형 6개이며, 탐지 성능 검증에 사용한 21개 기록은 소형 5개, 중형 10개, 대형 6개로 구성된다.
JIS의 GPR 탐사는 조사 구간 전반에서 수행되며, 굴착은 공동이 의심되는 지점에서 선별적으로 이루어지는 확인 절차이다. 따라서 굴착 기록이 있는 현장은 전체 조사 현장의 일부이며, GPR 현장 수와 굴착 기록 수는 집계 기준이 서로 다르다.
3. 연구 방법
본 연구의 평가는 두 개의 실험으로 구성된다. 첫 번째 실험(3.1절)에서는 고정 분할로 학습한 모델의 영상 단위 성능을 평가하고, 두 번째 실험(3.2절)에서는 현장 그룹 교차검증으로 굴착 기록의 현장 단위 탐지 성능을 평가한다.
3.1 단독 탐지 모델
본 연구에서는 COCO(Common Objects in Context) 데이터셋으로 사전 학습된 YOLOv8s(파라미터 약 11.2M)를 스캔별로 미세조정하였다(Jocher et al., 2023; Terven et al., 2023). 모델은 Fig. 2와 같이 영상 특징을 추출하는 백본, 다중 규모 특징을 결합하는 넥, 바운딩 박스·클래스·신뢰도를 출력하는 탐지 헤드로 구성된다. 모델 구현 및 학습은 Ultralytics 8.4.48(Jocher et al., 2023)과 PyTorch 2.11.0(Paszke et al., 2019) 환경에서 수행하였다.
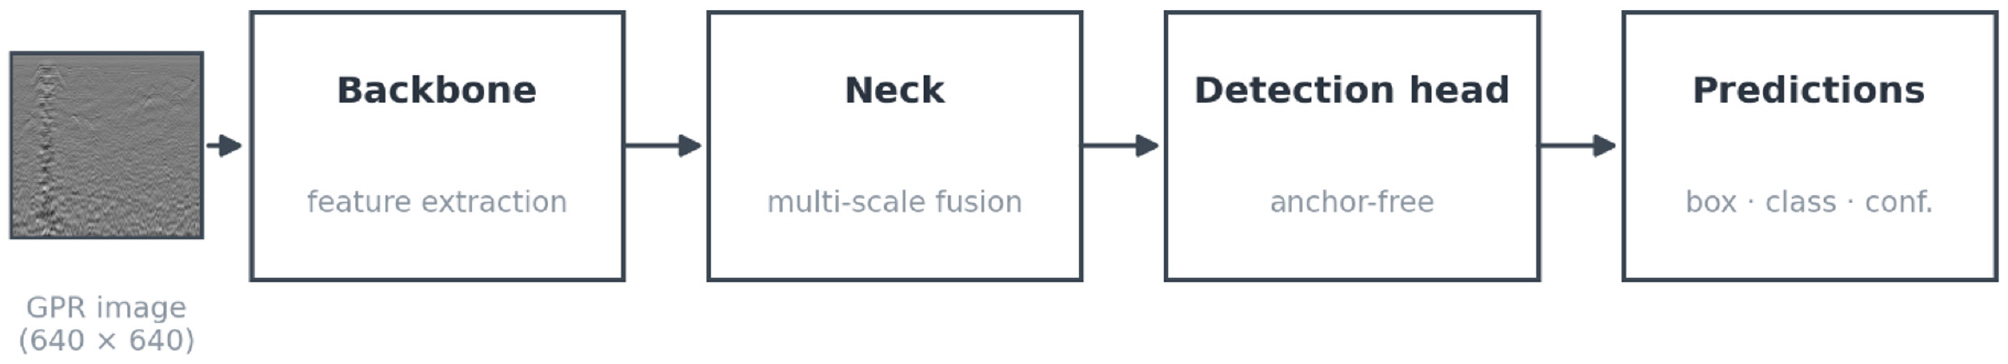
B-scan 및 C-scan 모델의 학습에는 동일한 하이퍼파라미터를 적용하였다. 입력 영상 크기는 640×640 화소, 배치 크기는 16, 최대 학습 횟수는 100 epochs로 설정하였으며, 검증 성능이 20 epochs 동안 향상되지 않을 경우 학습을 조기에 종료하였다. 이외의 학습 조건에는 Ultralytics의 기본 설정을 적용하였다.
실험 1에서는 36개 현장을 현장 단위로 학습 26개 현장, 검증 5개 현장, 시험 5개 현장으로 분할하였다. 학습셋은 777장(B-scan 576장, C-scan 201장), 검증셋은 213장(B-scan 162장, C-scan 51장), 시험셋은 147장(B-scan 108장, C-scan 39장)이다.
단독 탐지 모델의 성능은 시험셋의 각 영상에서 공동의 유무를 올바르게 판정했는지에 따라 평가하였다. YOLOv8은 영상에서 공동으로 보이는 위치마다 바운딩 박스를 출력하며, 각 박스에는 그 예측이 실제 공동일 가능성에 대한 모델의 확신 정도가 0~1의 값으로 함께 출력된다. 이 값이 신뢰도(confidence)이다. YOLOv8은 신뢰도가 기본값인 0.25보다 낮은 예측을 걸러내고 남은 예측만 출력하며, 본 연구에서는 이 기본 설정을 그대로 사용하여 공동 예측의 출력 여부를 판정 기준으로 삼았다. 이 값은 Ultralytics의 추론 기본값이며(Jocher et al., 2023), 이를 별도로 조정하지 않고 단독 모델과 융합 규칙에 공통으로 적용하였다.
본 연구의 과업은 바운딩 박스의 위치 정밀도가 아니라 공동의 유무 판정이므로, 평가 지표도 유무 기준으로 정의하였다. 공동 라벨이 있는 영상에서 공동 예측이 출력되면 정탐(true positive, TP), 공동 라벨이 없는 영상에서 공동 예측이 출력되면 오탐(false positive, FP), 공동 라벨이 있는 영상에서 공동 예측이 출력되지 않으면 미탐(false negative, FN), 공동 라벨이 없는 영상에서 공동 예측이 출력되지 않으면 진음성(true negative, TN)으로 정의하였다. 영상 단위 성능은 정밀도(Precision), 재현율(Recall) 및 영상 단위 오탐률(False-alarm rate)의 세 지표로 평가하였으며, 각각 Eq. (1)~Eq. (3)으로 산정한다. 정밀도는 공동이라고 판정한 영상 가운데 실제로 공동이 있는 비율, 재현율은 공동이 있는 영상 가운데 공동으로 판정된 비율, 영상 단위 오탐률은 공동 라벨이 없는 영상 가운데 공동으로 잘못 판정된 비율이다.
이때, TP, FP, FN, TN은 시험셋 영상 가운데 각각 정탐, 오탐, 미탐, 진음성으로 판정된 영상의 수이다.
3.2 현장 단위 후기 융합과 평가 지표
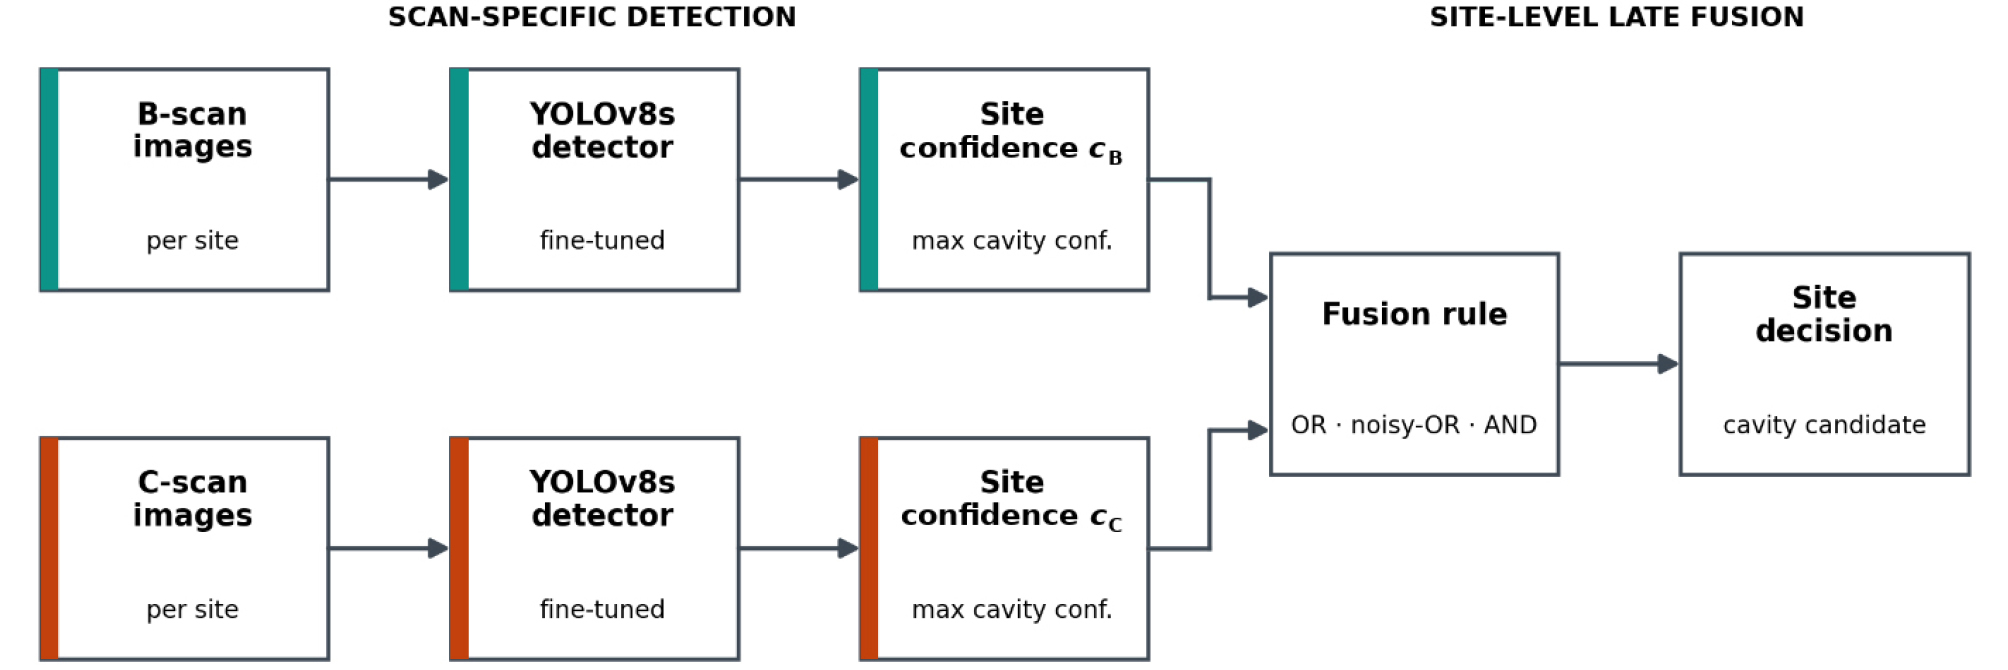
한 현장에서는 여러 장의 영상이 취득되므로 현장 단위 판정에는 이를 종합할 값이 필요하다. 공동은 국소적 이상이어서 현장의 한두 장의 영상에만 나타나므로, 평균을 취하면 소수의 뚜렷한 신호가 다수의 무신호 영상에 희석된다. 이에 본 연구에서는 현장에서 출력된 공동 예측 신뢰도의 최댓값을 현장 신뢰도 cB(B-scan)와 cC(C-scan)로 정의하였다. 각 스캔의 현장 신뢰도가 0.25 이상인 경우 해당 스캔이 공동을 탐지한 것으로 판정하였다. 세 융합 규칙 모두 두 현장 신뢰도를 하나의 결합 신뢰도로 만든 뒤 동일한 기준 0.25를 적용한다. OR 규칙(논리합)의 결합 신뢰도는 두 값 중 큰 값이고(Eq. (4)), AND 규칙(논리곱)의 결합 신뢰도는 두 값 중 작은 값이며(Eq. (5)), noisy-OR 규칙의 결합 신뢰도는 두 값을 확률형으로 결합한 값 cnOR이다(Eq. (6)). 결합 신뢰도가 0.25 이상이면 그 현장을 공동 후보로 판정한다. 본 연구의 판정 단위는 현장이므로, 각 굴착 기록의 탐지 여부는 그 기록이 속한 현장의 판정 결과에 따라 결정한다.
현장 단위 후기 융합에서는 신뢰도 0.001 이상인 예측값을 모두 저장하고, 각 스캔에서 가장 높은 예측값을 현장 신뢰도로 사용하였다. 이후 두 스캔의 현장 신뢰도를 융합하고, 결합된 신뢰도가 0.25 이상인 경우 공동 후보로 판정하였다.
연구 절차는 Fig. 3과 같이 스캔별 탐지, 현장별 신뢰도 집계, 융합 규칙 적용, 현장 판정의 순서로 구성된다. 탐지율 Rd는 공동이 확인된 굴착 기록 가운데 해당 기록이 속한 현장이 공동 후보로 판정된 비율로 Eq. (7)과 같고, 현장 단위 오탐률 Rf는 공동 라벨이 없는 현장 가운데 공동 후보로 잘못 판정된 비율로 Eq. (8)과 같다. 본 연구에서는 영상 단위 평가의 재현율과 구분하기 위하여 현장 기록을 대상으로 한 지표를 탐지율로 표기하였다.
Npos와 Nneg는 각각 양성 현장(기록)과 음성 현장의 수이고, Ndet와 Nfa는 각 대상 중 공동 후보로 판정된 수이다. 즉, 동일한 판정 비율을 양성 집합과 음성 집합에 각각 적용하여 탐지율과 오탐률을 산정하였다. 본 연구에서 탐지율이 높을수록 실제 공동이 굴착 확인 대상에서 누락될 위험이 작고, 오탐률이 높을수록 공동 라벨이 없는 현장이 공동 후보에 포함되어 불필요한 조사 비용이 발생할 가능성이 크다. 영상이 많은 현장일수록 우연히 높은 신뢰도가 나올 가능성이 커진다. 이에 따른 오탐의 영향은 4.2절에서 확인한다.
굴착 기록의 탐지율은 현장 그룹 5-fold 교차검증으로 평가하였다. 후기 융합 자체는 어느 현장에나 적용할 수 있으나, 성능 검증은 굴착으로 공동의 존재가 확인된 현장에서만 가능하므로 굴착 기록이 있는 19개 현장을 바탕으로 수행하였다. 굴착 기록이 있는 19개 현장을 다섯 조(4·4·4·4·3개 현장)로 나누었다. 각 fold에서는 한 조를 시험 현장으로 사용하고, 이를 제외한 32~33개 현장을 학습·검증용으로 사용하였다. 이 중 4개 현장을 내부 검증용으로, 나머지 28~29개 현장을 학습용으로 사용하였다. 5회 반복을 통해 19개 현장 모두 한 번씩 학습에 포함되지 않은 상태에서 평가되었으며, 3.1절과 동일한 조기 종료 기준을 적용하였다.
현장 단위 탐지율과 오탐률에는 Wilson 방법(Wilson, 1927)에 따른 95% 신뢰구간을 함께 제시하였으며, 동일한 방법을 제4장의 영상 단위 및 현장 단위 평가에 적용하였다.
4. 결과 및 분석
4.1 단독 모델의 영상 단위 성능
B-scan 영상을 바탕으로 학습 및 시험을 수행하였을 때, 공동 탐지의 정밀도는 0.717로, 재현율은 0.956으로 나타났다. C-scan 모델의 정밀도는 1.000, 재현율은 0.583으로 나타났다(Table 2).
Table 2.
Image-level cavity detection performance of the single-scan models on the test set
| Model | TP | FP | FN | TN | Precision | Recall | False-alarm rate |
| B-scan | 43 | 17 | 2 | 46 | 0.717 | 0.956 | 0.270 |
| C-scan | 7 | 0 | 5 | 27 | 1.000 | 0.583 | 0.000 |
두 모델의 학습 과정 및 영상 단위 평가 결과를 Fig. 4에 제시하였다. Fig. 4(a)는 B-scan 및 C-scan 모델의 학습 및 검증 과정에서 나타난 바운딩 박스 회귀 손실(Bounding box regression loss) 변화를 나타낸다. 두 모델 모두 학습 손실은 전반적으로 감소하였으며, 조기 종료 기준에 따라 B-scan 모델은 26 epochs, C-scan 모델은 87 epochs에서 학습이 종료되었다. 시험셋 147장에 대한 정탐, 미탐, 오탐 및 진음성 결과는 Table 2에 제시하였으며, 정밀도, 재현율, 영상 단위 오탐률 및 95% 신뢰구간은 Fig. 4(b)에 나타내었다.
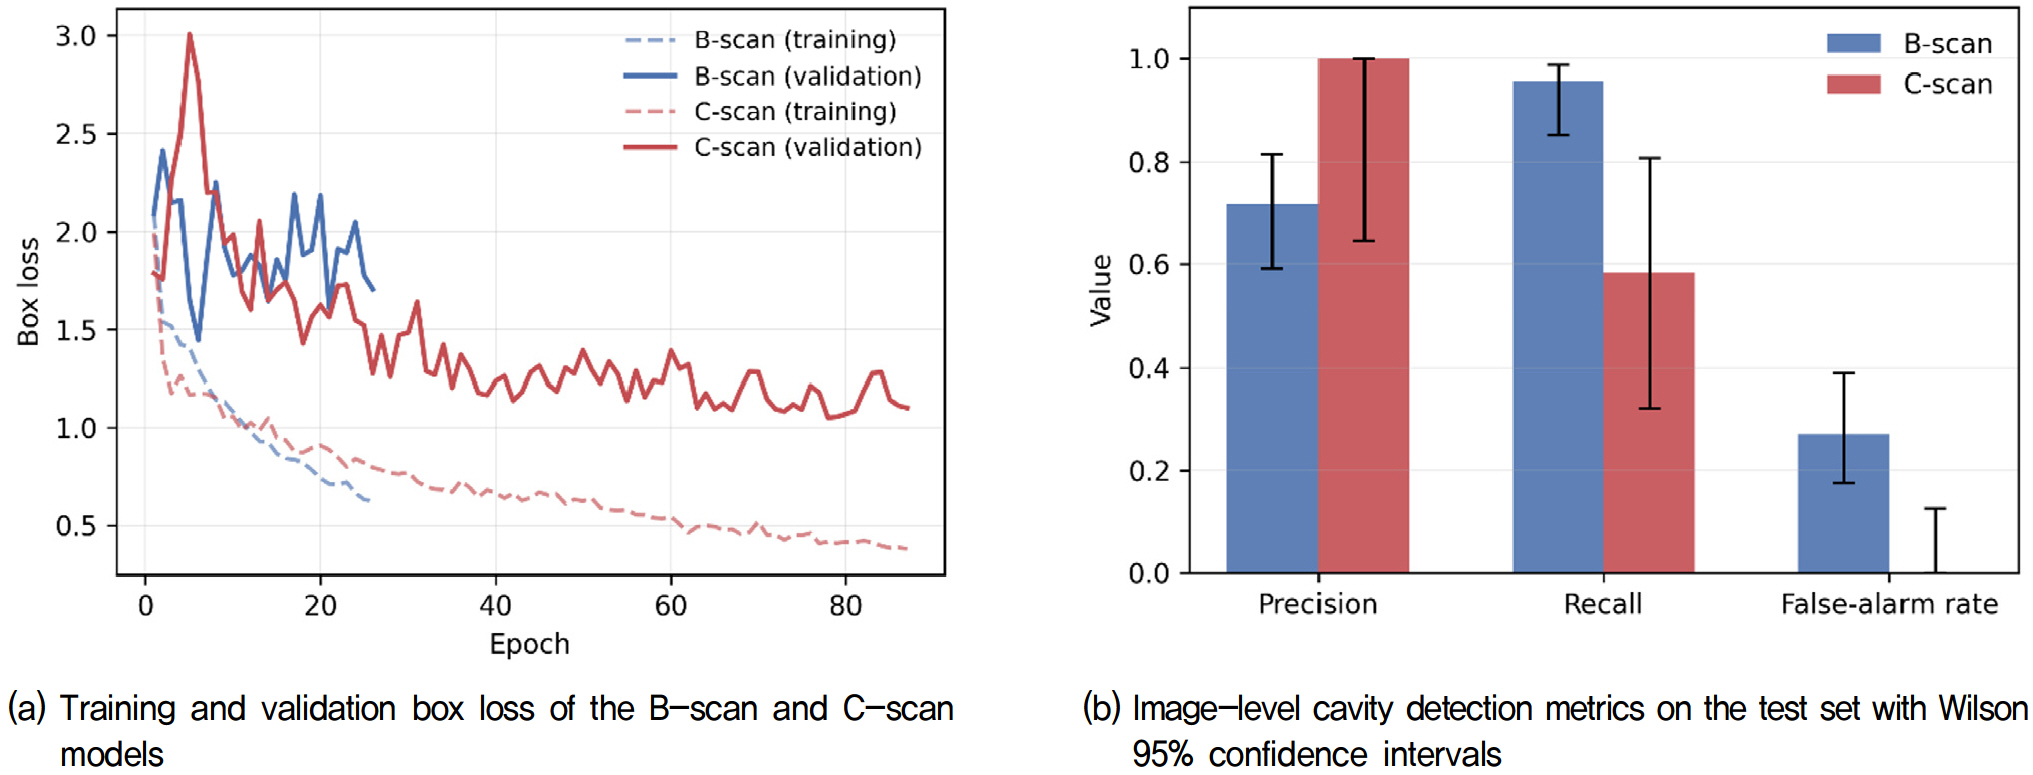
B-scan 모델은 공동 라벨이 있는 영상 45장 중 43장을 탐지하여 재현율이 95.6%(95% 신뢰구간 85.2~98.8%)였으며, 공동 라벨이 없는 영상 63장 중 17장을 공동으로 잘못 판정하여 오탐률은 27.0%(95% 신뢰구간 17.6~39.0%)였다. C-scan 모델은 공동 라벨이 있는 영상 12장 중 7장을 탐지하여 재현율이 58.3%(95% 신뢰구간 32.0~80.7%)였고, 공동 라벨이 없는 영상에서는 오탐이 발생하지 않았다.
B-scan 모델은 공동 탐지에 유리하지만 일부 오탐이 발생하고, C-scan 모델은 오탐이 적지만 미탐이 발생한다. 따라서 두 스캔의 장점을 함께 활용하고 각 모델의 한계를 보완하기 위하여 후기 융합을 수행하였다.
4.2 후기 융합의 탐지율과 오탐
실굴착으로 공동이 확인된 21개 기록의 융합 규칙별 탐지율을 Table 3에 제시하였다. 이 21개 기록은 실굴착을 통해 공동의 존재가 확인된 자료로서, 탐지 성능 검증의 기준자료로 활용되었다. 표의 n/m은 대상 기록 m개 중 공동 후보로 판정된 기록이 n개임을 의미한다. B-scan과 C-scan 단독 모델은 각각 21개 중 18개(85.7%, 95% 신뢰구간 65.4~95.0%)를 탐지했지만, 미탐 기록의 구성은 서로 달랐다. 두 스캔이 모두 탐지한 기록은 15개(71.4%), B-scan만 탐지한 기록은 3개(14.3%), C-scan만 탐지한 기록은 3개(14.3%)였고, 두 스캔에서 모두 미탐지된 기록은 없었다. Fig. 5의 각 점은 굴착 기록 하나를 나타내며, 두 스캔에서 모두 미탐지된 기록이 없음을 확인할 수 있다. 이에 따라 두 스캔 중 하나라도 공동을 탐지하면 후보로 판정하는 OR 규칙은 21개 기록 모두(100.0%, 95% 신뢰구간 84.5~100.0%)를 탐지하였다. 21개의 굴착 기록이 분포한 19개 현장을 기준으로 재산정한 결과, 두 단독 모델은 각각 19개 현장 중 16개(84.2%)를 탐지하였고, OR 규칙과 noisy-OR 규칙은 19개 현장 모두를 탐지하였으며, AND 규칙은 13개 현장을 탐지하여 기록 단위 결과와 동일한 경향을 보였다.
Table 3.
Detection rates by method and cavity size grade and false-alarm rates at sites without cavity annotations
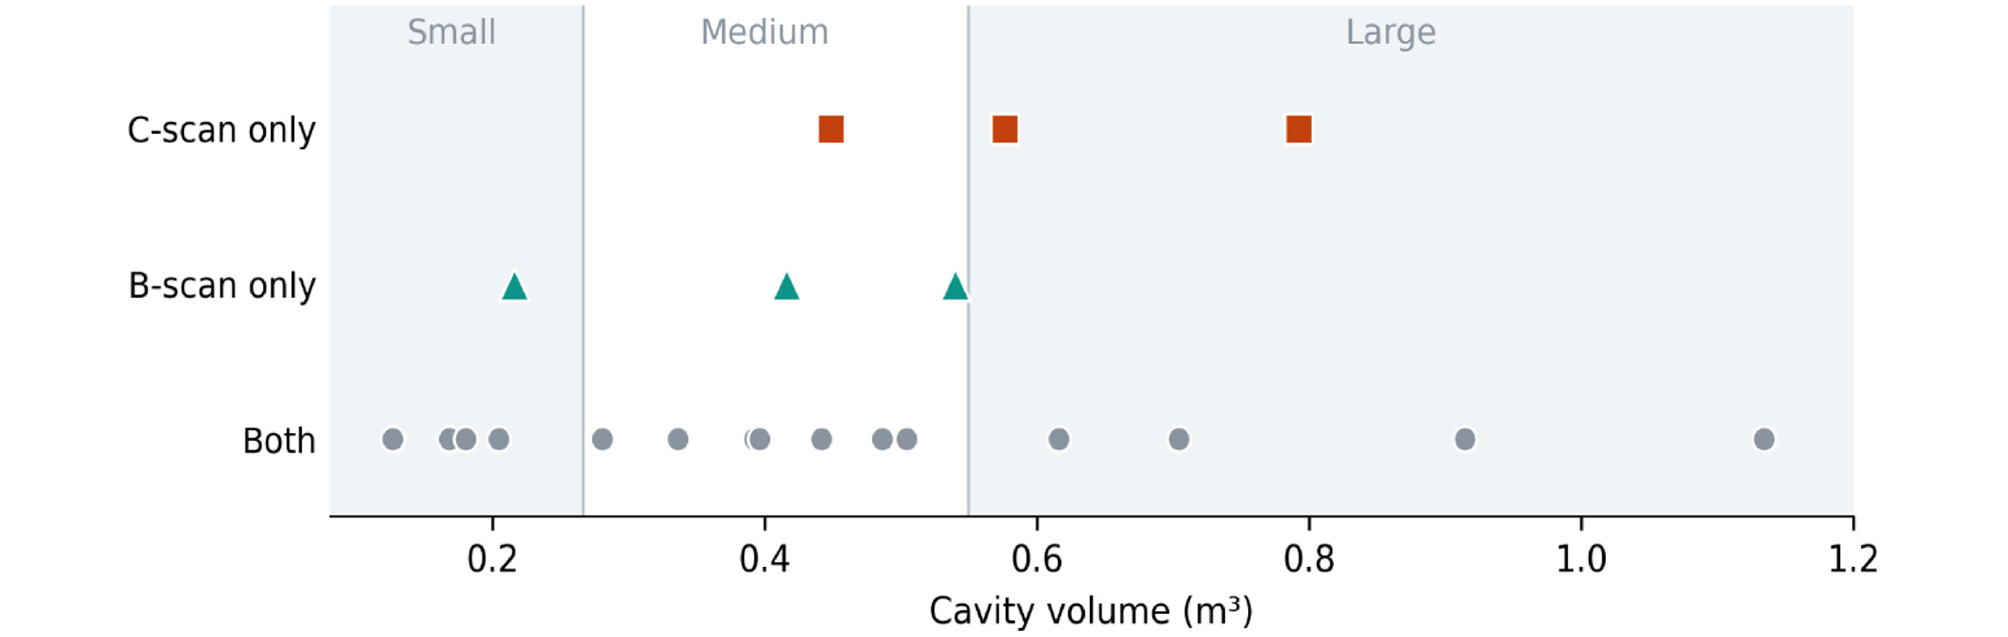
공동 크기 등급별 결과에서도 두 스캔의 보완 양상이 확인되었다. 소형에서는 B-scan이 5개 중 5개를 모두 탐지한 반면 C-scan은 4개를 탐지하여, B-scan이 C-scan의 미탐을 보완하였다. 중형에서는 B-scan이 10개 중 9개, C-scan이 8개를 탐지했고, OR 규칙으로 결합하면 10개 모두가 탐지되었다. 대형에서는 B-scan이 6개 중 4개를 탐지한 반면 C-scan은 6개 모두를 탐지하여 B-scan의 미탐 2건을 보완하였다. 즉, 본 자료에서는 깊이 단면을 제공하는 B-scan이 소형·중형 공동 탐지에 상대적으로 유리했고, 수평 단면을 제공하는 C-scan은 대형 공동 탐지에 상대적으로 유리했다. 이러한 상호 보완 효과는 특정 크기 등급에 국한되지 않았다. OR 규칙은 각 등급에서 단독 모델의 미탐을 상호 보완하였으며, 특히 중형에서는 두 단독 모델보다 높은 탐지율을 보였다. noisy-OR 규칙은 전체 기록과 모든 크기 등급에서 OR 규칙과 동일한 탐지 결과를 보였다. 이 결과는 본 자료에서 탐지율 향상의 주된 원인이 신뢰도 결합식의 형태보다 상호 보완적인 두 영상을 함께 사용한 데 있음을 시사한다. 따라서 동일한 판정 결과가 유지되는 조건에서는 구현이 단순한 OR 규칙을 우선 고려할 수 있다. 반면 두 스캔이 모두 공동을 탐지한 경우에만 후보로 판정하는 AND 규칙은 21개 중 15개(71.4%, 95% 신뢰구간 50.0~86.2%)를 탐지하여 가장 낮은 탐지율을 보였고, 등급별 탐지 결과는 소형 4/5(80.0%), 중형 7/10(70.0%), 대형 4/6(66.7%)이었다.
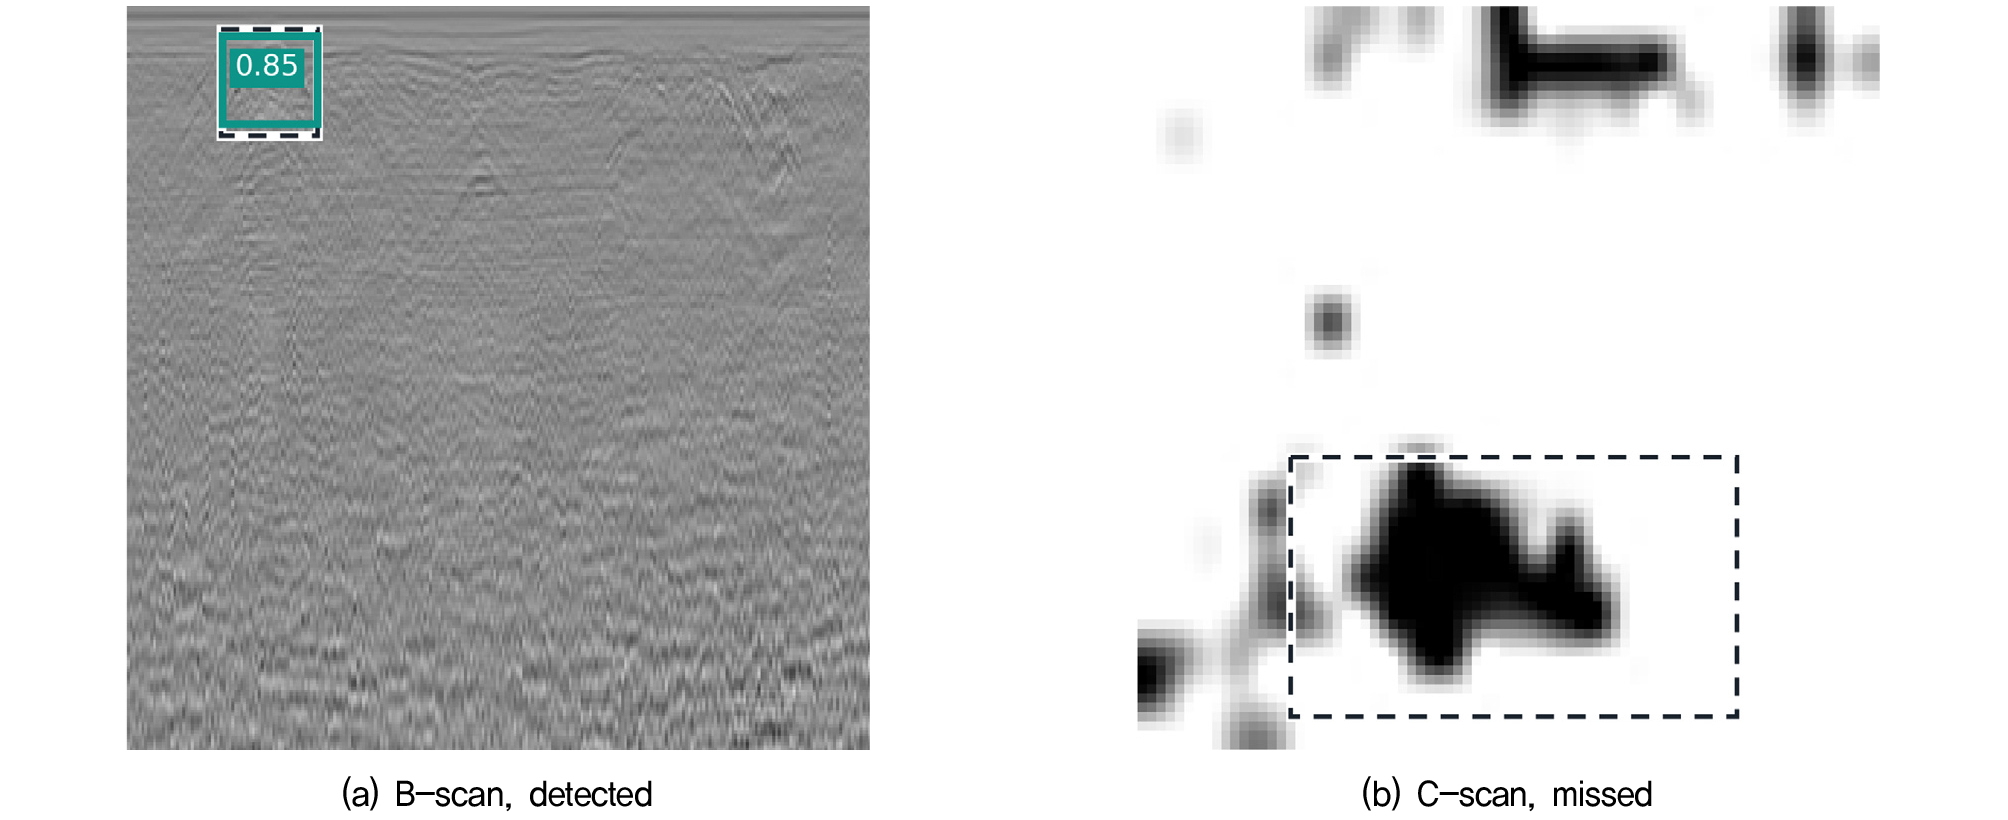
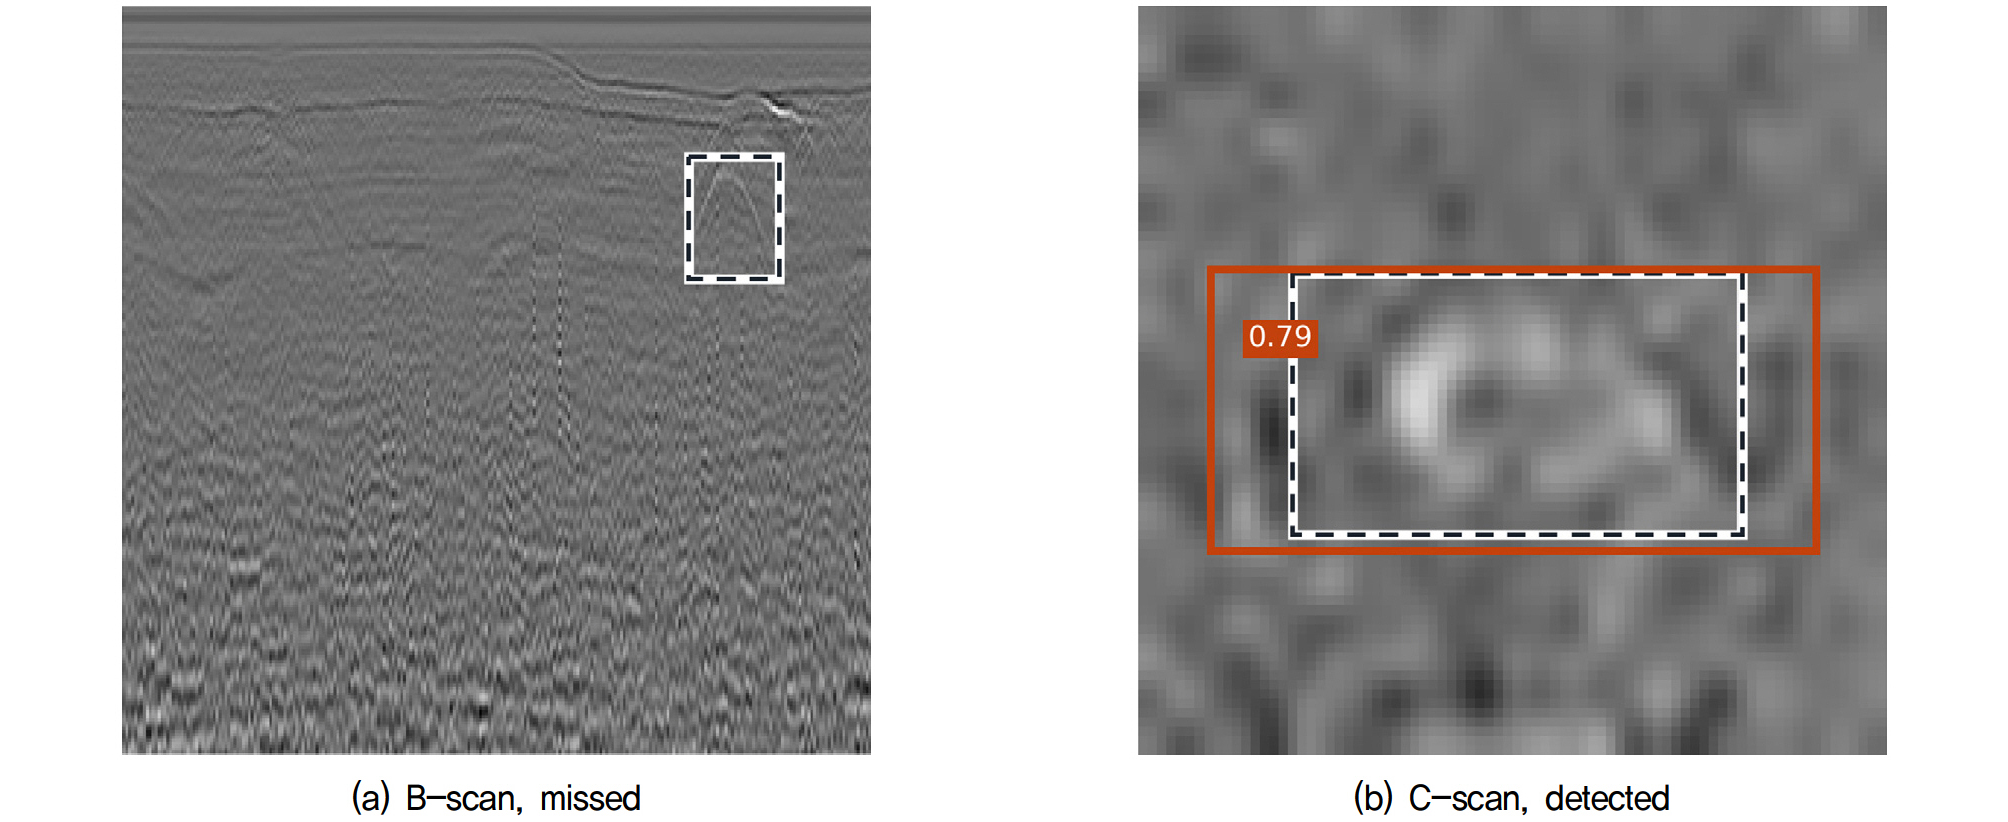
Fig. 6은 B-scan 모델에서만 탐지된 중형 공동의 사례이며, Fig. 7은 C-scan 모델에서만 탐지된 대형 공동의 사례이다.
오탐 특성은 3.1절의 5개 시험 현장 중 공동 라벨 및 굴착 기록이 없는 3개 현장을 대상으로 평가하였다. 공동 라벨이 없는 현장을 공동 후보로 잘못 판정한 경우를 오탐으로 정의하였다. 오탐률은 실험 1에서 학습한 모델을 이용하여 평가하였으며, 탐지율은 현장 그룹 5-fold 교차검증을 통하여 평가하였다. 따라서 오탐률과 탐지율은 서로 다른 모델을 이용하여 평가하였다. B-scan 단독 모델은 3개 현장 중 2개 현장을 공동 후보로 잘못 판정하여 오탐률이 66.7%(2/3, 95% 신뢰구간 20.8~93.9%)이었으며, C-scan 단독 모델은 오탐이 없었다. OR 규칙과 noisy-OR 규칙은 한쪽 스캔의 판정만으로도 현장을 후보로 판정할 수 있으므로 B-scan의 오탐을 그대로 포함하여 2개 현장을 잘못 판정하였다. 반면 AND 규칙은 C-scan의 동시 판정을 요구하므로 오탐이 발생하지 않았고(0/3, 95% 신뢰구간 상한 56.1%), 공동 라벨이 있는 나머지 2개 시험 현장도 모두 탐지하였다. 이러한 현장 단위 오탐 특성은 4.1절의 영상 단위 분석에서 나타난 B-scan 27.0%와 C-scan 0.0%의 오탐률과 일관된 경향을 보였다.
B-scan의 오탐은 3.1절의 단독 모델 성능과 현장 신뢰도 집계 방식의 영향을 함께 받은 것으로 해석할 수 있다. 기본 추론 설정에서 B-scan 모델이 공동 라벨이 없는 영상에서도 공동을 예측한 오탐 영상은 17장이었다(정밀도 0.717). 또한 현장 신뢰도는 현장 내 모든 영상의 최대 신뢰도이므로, 오탐 바운딩 박스가 하나만 존재해도 해당 현장 전체가 공동 후보로 판정될 수 있다. 반면 C-scan은 공동 라벨이 없는 3개 현장에서 공동 신뢰도가 모두 낮아 오탐이 없었고, AND 규칙은 두 스캔의 동시 판정을 요구함으로써 B-scan의 오탐을 걸러냈다. 다만 공동 라벨이 없는 현장이 3개에 불과하므로, 이러한 오탐 억제 효과는 제한된 시험 조건에서 관찰된 결과로 해석해야 한다.
5. 결 론
본 연구에서는 JIS의 B-scan과 C-scan을 이용하여 스캔별 YOLOv8s 모델을 학습하고, 시험셋을 이용한 영상 단위 평가와 실굴착 기록을 이용한 현장 단위 검증을 수행하였다. 이후 두 스캔의 서로 다른 탐지 특성을 함께 활용하기 위해 현장 단위 후기 융합을 적용하였다. 주요 결론은 다음과 같다.
(1) 영상 단위 평가에서 B-scan은 높은 재현율을 보였으나 일부 오탐이 발생하였고, C-scan은 오탐이 발생하지 않았으나 재현율이 낮았다. 현장 단위 평가에서도 B-scan에서는 오탐이 발생한 반면 C-scan에서는 오탐이 발생하지 않아 두 스캔의 서로 다른 탐지 특성이 확인되었다.
(2) 후기 융합에서는 OR 규칙과 noisy-OR 규칙이 모든 굴착 기록을 탐지하여 가장 높은 탐지율을 보였다. 반면 AND 규칙은 탐지율이 낮았으나 공동 라벨이 없는 시험 현장에서 오탐이 발생하지 않았다. 이에 따라 미탐 최소화가 중요한 1차 선별 단계에는 OR 규칙을, 오탐 최소화가 중요한 확인 단계에는 AND 규칙을 적용하는 방안을 고려할 수 있다.
(3) 공동 크기별로는 소형 및 중형 공동에서 B-scan이, 대형 공동에서 C-scan이 상대적으로 높은 탐지 성능을 보여 공동 크기에 따라서도 두 스캔의 상호 보완성이 확인되었다.
(4) 평가 결과의 신뢰성을 보완하기 위해 영상 단위 평가와 현장 그룹 5-fold 교차검증을 병행하고, 주요 탐지율과 오탐률에 Wilson 방법의 95% 신뢰구간을 함께 제시하였다.
다만 현장 단위 탐지율은 두 스캔 자료를 모두 갖춘 21개 굴착 기록(19개 현장)으로 평가하였으며, 표본 수가 적어 신뢰구간이 넓고, 장비 제원과 지반 조건이 다른 현장에 대한 일반화는 검증하지 못하였다.
본 연구에서는 현장별 최대 신뢰도에 기반한 B-scan과 C-scan의 후기 융합 절차를 구축하고, 실굴착 기록으로 두 스캔의 상호 보완성을 검증하였으며, 이를 바탕으로 선별 단계와 확인 단계에 서로 다른 융합 규칙을 적용하는 운용 방안을 제시하였다. 결과의 일반화를 위해서는 향후 추가적인 현장 검증을 바탕으로 한 연구가 요구된다.