

1. 서 론
최근 이상기후 및 집중호우의 증가로 인해 국내외에서 산사태 발생 빈도와 피해 규모가 지속적으로 증가하고 있다. 산사태는 인명 피해뿐만 아니라 도로, 철도 및 주요 기반시설의 붕괴와 같은 대규모 사회·경제적 피해를 유발할 수 있기 때문에, 산사태 위험성을 정량적으로 평가하고 예측하기 위한 연구의 중요성이 더욱 커지고 있다. 특히 산지에 조성된 임도와 배수·사면보호 등의 임도 구조물은 집중호우와 지반 약화에 직접적으로 노출되어 있어, 사면 붕괴, 노면 유실 및 구조물 손상 위험이 크다. 따라서 자연재해로 인한 피해뿐만 아니라 시설물의 결함과 노후화에 효과적으로 대응하기 위해서는 임도 손상 위험을 사전에 진단하고, 위험 수준에 따른 유지관리 및 복구 기술을 개발할 필요가 있다. 사면의 안정성은 지반의 전단강도 특성과 밀접한 관련이 있으며, 전단강도는 산사태 발생 가능성을 평가하는 핵심 인자 중 하나로 알려져 있다(Kwon and Kim, 2014; Lee et al., 2023). 일반적으로 지반의 전단강도는 soil cohesion, friction angle 및 soil density와 같은 지반 물성치에 의해 결정되며, 이러한 물성치는 사면 안정해석 및 산사태 위험도 평가 과정에서 중요한 입력 변수로 활용된다(Lim et al., 2024; Oh et al., 2024). 최근에는 인공지능 및 데이터 기반 해석 기법이 다양한 공학 분야에 적용되면서, 지반공학 분야에서도 이를 활용한 연구가 활발히 수행되고 있다(Kim et al., 2025; Kim and Kim, 2025). 특히 제한된 현장 조사 및 실내 시험 결과를 활용하여 전단강도 또는 사면 안정성을 예측하기 위한 인공지능 기반 접근 방법이 증가하고 있다. 그러나 지반공학 분야에서는 현장 조사와 실내 시험에 많은 시간과 비용이 소요되며, 대상 지역의 불균질성 또한 매우 크기 때문에 충분한 양의 데이터를 확보하는 데 현실적인 한계가 존재한다(Lee et al., 2025; Shams et al., 2025). 이러한 제한된 데이터 조건에서는 특정 범위의 데이터에 편향된 학습이 수행될 가능성이 있으며, 이는 인공지능 모델의 일반화 성능 저하 및 예측 신뢰성 감소로 이어질 수 있다(De Hond et al., 2022; Rochet et al., 2023). 이와 같은 문제를 보완하기 위해 최근 다양한 데이터 증폭(data augmentation) 기법이 활용되고 있다. 대표적으로 Synthetic Minority Oversampling Technique(SMOTE) 및 Adaptive Synthetic Sampling(ADASYN)은 기존 데이터 간의 관계를 기반으로 새로운 데이터를 생성하는 대표적인 오버샘플링 기법으로 알려져 있다. 또한 Kriging은 공간적 보간 기법을 이용하여 연속적인 데이터 분포를 추정할 수 있으며, 다양한 공학 분야에서 제한된 계측 데이터를 보완하기 위한 방법으로 활용되고 있다. 최근에는 확률 기반 탐색과 최적화 과정을 결합한 Monte Carlo–Genetic Algorithm(MC-GA) 기반 데이터 생성 기법 역시 적용 가능성이 검토되고 있다.
그러나 대부분의 기존 알고리즘인 SMOTE, ADASYN 등에 관련된 연구는 데이터 수 증가 또는 예측 정확도 향상에 초점을 두고 있으며, 데이터 증폭 과정에서 생성되는 데이터의 구조적 특성 변화에 대한 분석은 상대적으로 부족한 실정이다. 특히 지반공학 데이터의 경우 변수 간 상관관계와 분포 특성이 매우 중요하기 때문에, 단순한 데이터 수 증가만으로는 실제 지반 특성을 충분히 반영하기 어려울 수 있다. 또한 데이터 증폭 과정에서 원시 데이터의 구조적 특성이 과도하게 왜곡될 경우, 생성된 데이터를 기반으로 구축된 예측 모델의 신뢰성 역시 영향을 받을 가능성이 존재한다. 이에 본 연구에서는 산사태 위험성과 밀접한 관련이 있는 전단강도 특성에 주목하였으며, 전단강도 산정에 중요한 변수로 활용되는 soil cohesion, friction angle 및 soil density를 대상으로 데이터 증폭 기법의 구조적 특성을 비교 분석하였다. 이를 위해 SMOTE, ADASYN, Kriging 및 MC-GA 기법을 적용하여 증폭 데이터를 생성하였으며, 확률밀도함수, 평균값 비교, Pearson correlation 및 Principal Component Analysis(PCA)를 통해 각 기법에 따른 데이터 분포 및 구조적 특성 변화를 분석하였다. 본 연구를 통해 제한된 지반 데이터 조건에서 데이터 증폭 기법이 생성 데이터의 구조적 특성에 미치는 영향을 분석하고, 향후 산사태 위험성 평가 및 전단강도 기반 예측 연구에 활용 가능한 기초 자료를 제공하고자 하였다.
2. 배경이론
2.1 SMOTE
Synthetic Minority Oversampling Technique(SMOTE)는 데이터 불균형 문제를 해결하기 위해 제안된 대표적인 오버샘플링 기법이다(Yoon, 2023). SMOTE는 기존 데이터와 인접한 k-nearest neighbor(k-NN) 데이터를 활용하여 두 데이터 사이의 선형 보간을 수행함으로써 새로운 데이터를 생성한다. 생성 과정은 다음 식과 같이 표현할 수 있다.
여기서, Xnew는 새롭게 생성된 데이터, Xi는 기존 데이터, Xnn은 Xi와 가장 인접한 k-nearest neighbor 데이터 중 하나를 의미한다. 또한 λ는 0과 1 사이의 난수(random value)로, 두 데이터 사이에서 생성 위치를 결정하는 계수이다. 즉, 기존 데이터 주변에서 새로운 샘플을 생성하기 때문에 원시 데이터의 국부적 분포 특성을 비교적 안정적으로 유지할 수 있는 장점을 가진다. 또한 단순 복제 방식과 달리 새로운 데이터를 생성하기 때문에 과적합 문제를 일부 완화할 수 있다. 본 연구에서는 제한된 지반 물성치 데이터를 확장하기 위한 방법으로 SMOTE 기법을 적용하였다.
2.2 ADASYN
Adaptive Synthetic Sampling(ADASYN)은 SMOTE를 기반으로 개발된 적응형 오버샘플링 기법이다. ADASYN은 데이터 밀도가 낮은 영역 또는 학습이 어려운 영역에 더 많은 데이터를 생성하는 특징을 가진다. 이는 다음 식과 같이 표현할 수 있다.
여기서, Gi는 i번째 데이터 주변에 생성되는 synthetic data의 개수, ri는 해당 데이터의 학습 난이도를 나타내는 비율, 그리고 G는 전체 생성 데이터 수를 의미한다. 일반적으로 ri값이 클수록 해당 데이터 주변은 데이터 밀도가 낮거나 분류가 어려운 영역으로 판단되며, 이에 따라 더 많은 synthetic data가 생성된다. 이를 통해 데이터 분포의 불균형 문제를 보다 효과적으로 보완할 수 있으며, 복잡한 데이터 구조를 반영하는 데 유리한 특성을 가진다. 그러나 특정 영역에 데이터가 과도하게 생성될 경우 분포 특성이 일부 왜곡될 가능성도 존재한다. 본 연구에서는 제한된 지반 데이터 조건에서 ADASYN이 생성하는 데이터의 분포 특성과 구조적 특성을 분석하였다.
2.3 Kriging
Kriging은 공간적 상관성을 기반으로 미지의 값을 추정하는 대표적인 공간 보간 기법이다. 주변 데이터 간의 거리 및 상관구조를 고려하여 연속적인 값을 예측할 수 있으며, 지반공학 및 지형 분석 분야에서 널리 활용되고 있다. 수학적 모델을 식 (3)과 같다.
여기서, Z(x0)는 예측하고자 하는 위치 x0에서의 추정값, Z(xi)는 주변 위치 xi에서의 기존 데이터 값, 그리고 ϕi는 각 데이터에 부여되는 가중치(weight)를 의미한다. 또한 n은 보간에 사용되는 주변 데이터의 개수를 나타낸다. Kriging은 제한된 계측 데이터로부터 연속적인 데이터 분포를 생성할 수 있는 장점이 있으나, 데이터 분포 특성에 따라 특정 방향의 구조가 강화될 가능성이 존재한다. 본 연구에서는 Kriging 기법을 이용하여 제한된 지반 물성치 데이터를 보간 기반으로 증폭하고, 생성된 데이터의 구조적 특성을 분석하였다.
2.4 MC-GA
Monte Carlo–Genetic Algorithm(MC-GA)는 확률 기반 데이터 생성 기법인 Monte Carlo simulation과 최적화 기법인 Genetic Algorithm을 결합한 방법이다.
여기서, Xnew는 새롭게 생성된 데이터, μ는 평균, σ는 표준편차, 그리고 Z는 표준정규분포를 따르는 난수를 의미한다. 즉, Monte Carlo simulation은 기존 데이터의 통계적 특성을 기반으로 다양한 데이터를 확률적으로 생성하는 특징을 가진다. Monte Carlo simulation은 확률분포를 기반으로 다양한 데이터를 생성할 수 있으며, Genetic Algorithm은 적합도(fitness function)를 기반으로 최적의 해를 탐색하는 알고리즘이다. 본 연구에서는 Monte Carlo simulation을 통해 다양한 지반 물성치 데이터를 생성하고, Genetic Algorithm을 이용하여 데이터 분포 특성을 최적화하였다. 이를 통해 기존 데이터 범위를 보다 넓게 탐색할 수 있으며, 데이터 다양성을 증가시키는 효과를 기대할 수 있다. 그러나 데이터 분포 범위가 과도하게 확장될 경우 원시 데이터의 구조적 특성과 차이가 발생할 가능성도 존재한다.
3. 입력 데이터 특성
해당 연구에서 활용한 입력 데이터는 세종시 인근에 위치한 자연 사면에서 실험을 진행하여 획득하였다. 공학적 물성치 중 soil density는 들밀도 실험을 통해 도출하였으며, 나머지 soil cohesion과 friction angle은 현장에서 시료를 채취 후 직접전단시험을 통해 예측하였다. 실험이 진행된 지역은 접근성 및 시료 채취의 용이성 등을 고려하여 총 23지역에서 대표적으로 실시되었으며, 해당 데이터를 통해 전체 사면의 특징을 평가하기 위하여 데이터 증폭 기법을 사용하고자 하였다. 자연 사면의 상태 및 구체적인 실험 방법에 대한 내용은 Park and Yoon(2025)에 상세히 기술되어 있으므로 이를 참고하기 바란다.
Figure 1은 측정된 지반 물성치인 soil cohesion, friction angle 및 soil density의 확률밀도함수를 나타낸 것이다. Soil cohesion은 약 1400–1860 Pa 범위에서 분포하였으며, 평균값은 약 1603 Pa로 나타났다. 또한 대부분의 데이터가 1500–1800 Pa 구간에 집중되어 있어 상대적으로 제한된 분포 범위를 가지는 것으로 확인되었다. Friction angle은 약 24.3–41.6° 범위에서 분포하였으며 평균값은 약 33.3°로 나타났다. 다른 물성치와 비교할 때 상대적으로 넓은 분포 범위를 보였으나, 주요 데이터는 28–38° 구간에 집중되는 경향을 나타내었다. Soil density는 약 1700–1950 kg/m3 범위에서 분포하였으며 평균값은 약 1840 kg/m3로 분석되었다. 전체적으로 soil density 역시 평균값 주변에 데이터가 집중되어 있었으며, 일부 값만이 상대적으로 높은 밀도 영역에 존재하였다.
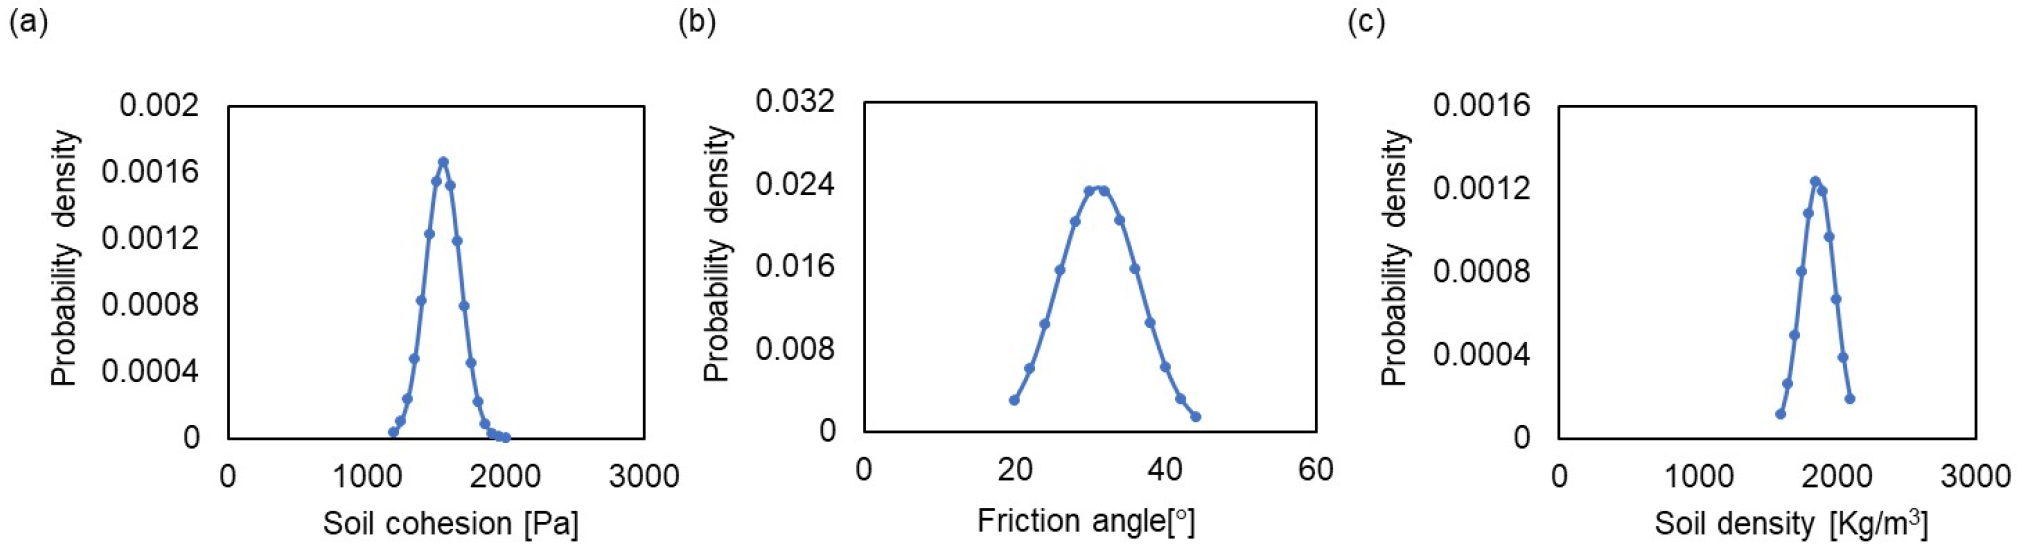
확률밀도함수 결과를 종합적으로 분석하면, 원시 데이터는 전체 물성 범위를 충분히 대표하기보다는 특정 구간에 집중된 형태를 나타내고 있음을 확인할 수 있다. 특히 soil cohesion과 soil density는 평균값 주변에서 높은 확률밀도를 나타내는 반면, 양 극단 영역에서는 데이터 수가 매우 제한적인 것으로 나타났다. 이는 제한된 데이터 수로 인해 다양한 지반 조건이 충분히 반영되지 못했음을 의미하며, 인공지능 기반 예측 모델 학습 시 특정 영역에 대한 편향이 발생할 가능성을 시사한다. 또한 friction angle 역시 상대적으로 넓은 범위를 가지지만, 실제 데이터 분포는 중앙 영역에 집중되어 있어 고각 또는 저각 조건에 대한 학습 데이터가 부족한 것으로 판단된다. 따라서 이러한 제한된 분포 특성을 보완하고 데이터 다양성을 확보하기 위해 데이터 증폭 기법의 적용이 필요한 것으로 판단된다.
4. 결 과
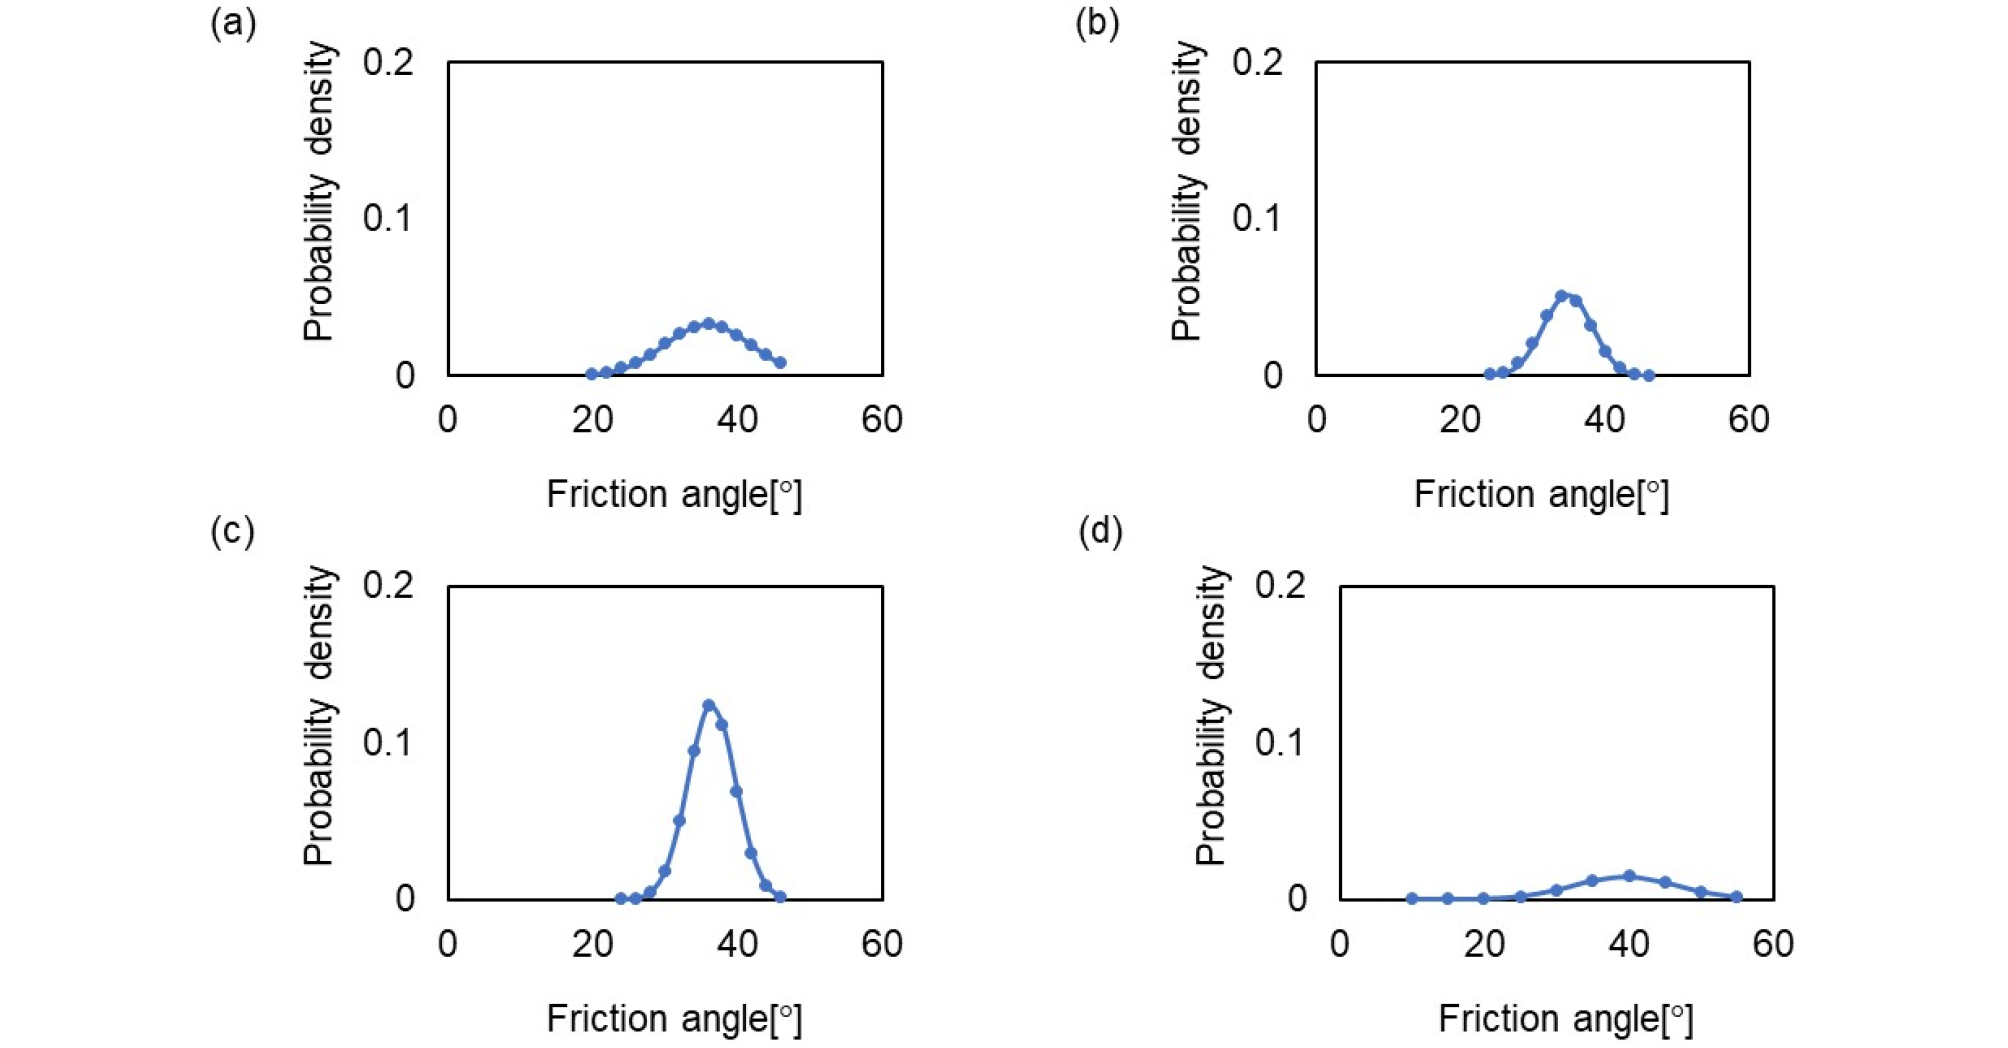
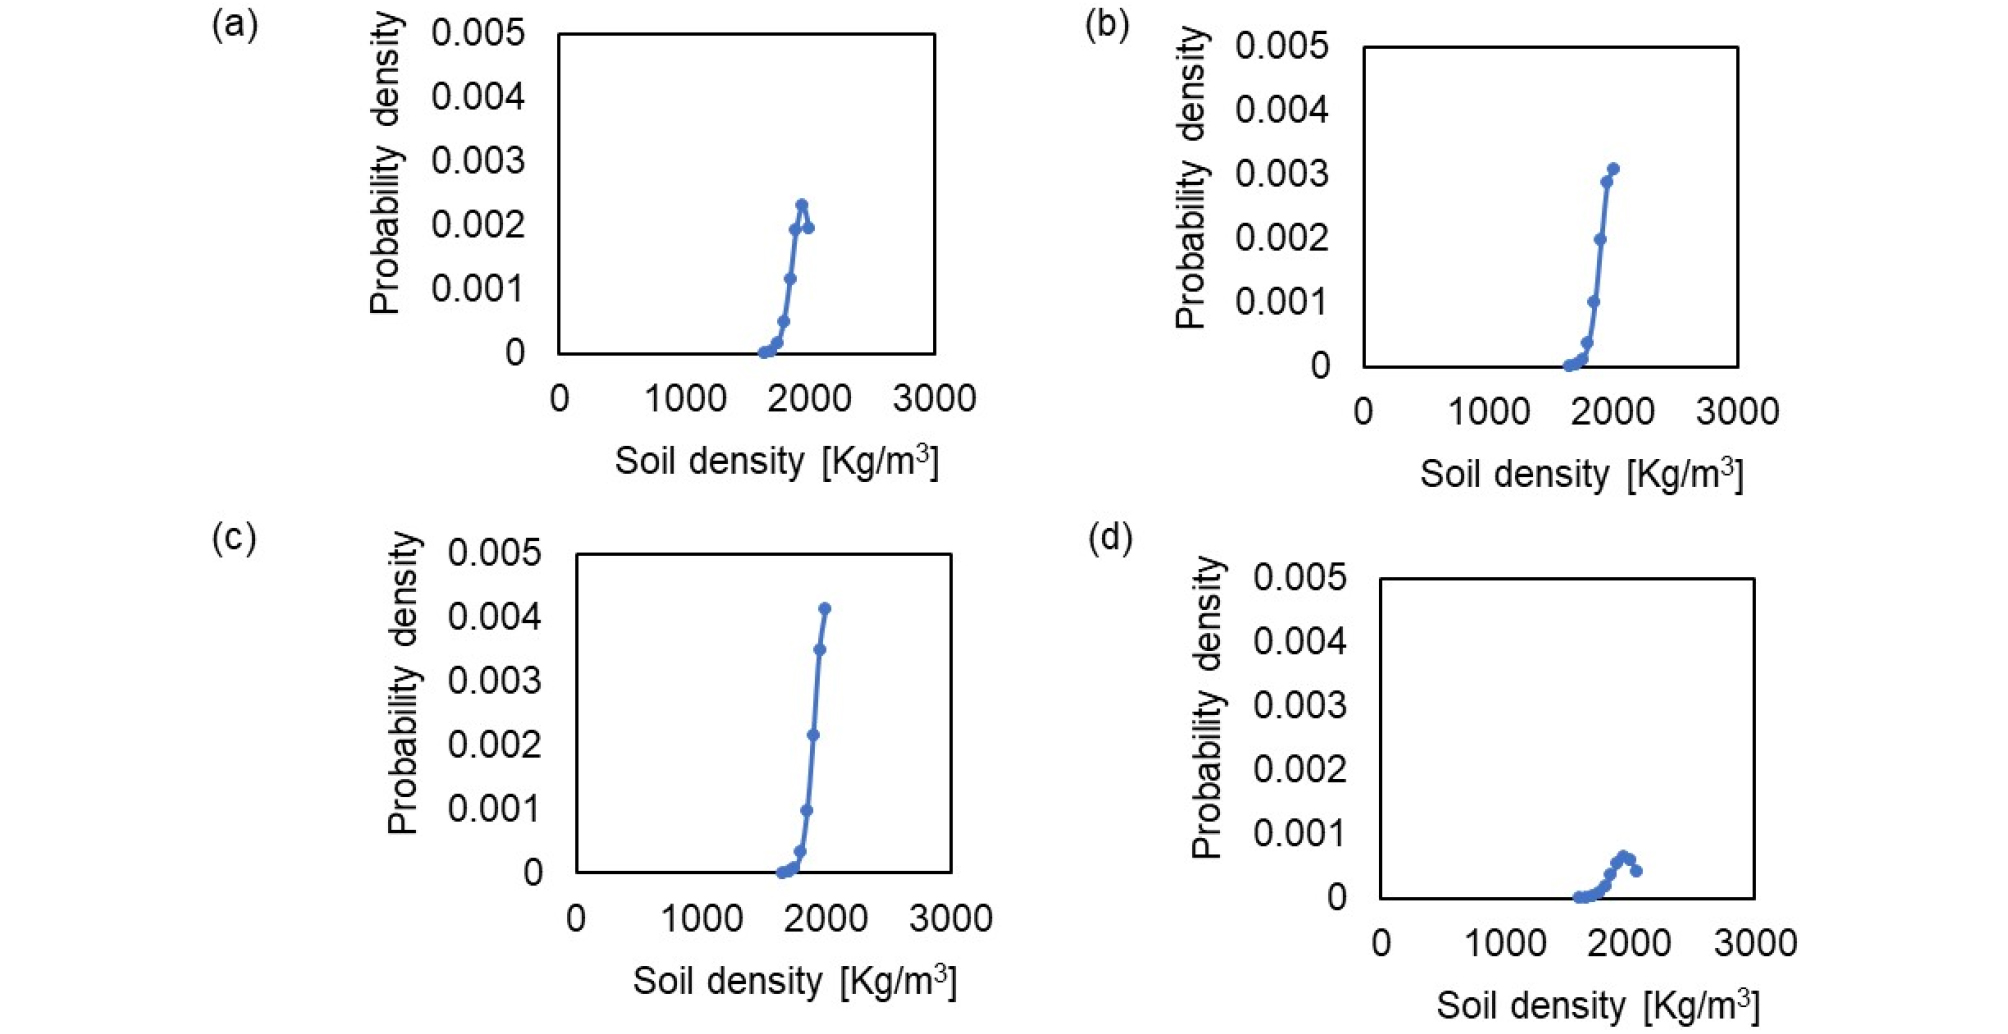
Figure 2~4는 soil cohesion, friction angle 및 soil density에 대하여 SMOTE, ADASYN, Kriging 및 MC-GA 기법을 적용하여 생성된 증폭 데이터의 확률밀도함수를 나타낸 것이다. 전체적으로 모든 증폭 기법은 원시 데이터의 평균 범위를 크게 벗어나지 않는 경향을 보였으나, 데이터의 분포 범위와 확률밀도 형상에서는 차이를 나타내었다. Figure 2의 soil cohesion 결과를 살펴보면, SMOTE와 ADASYN은 원시 데이터가 주로 분포하던 약 1500–1800 Pa 구간에서 높은 확률밀도를 유지하는 경향을 나타내었다. 특히 SMOTE는 기존 데이터 주변에서 비교적 안정적인 분포를 형성하였으며, ADASYN은 일부 구간에서 상대적으로 넓은 분포를 나타내었으나 전체적인 분포 특성은 원시 데이터와 유사하게 유지되었다. Kriging의 경우 약 1600–1900 Pa 구간에 데이터가 집중되는 경향을 나타내었으며, 특정 범위에서 상대적으로 높은 확률밀도를 보였다. 반면 MC-GA는 약 1000–2500 Pa 범위까지 데이터가 분포하는 경향을 나타내어, 다른 기법과 비교할 때 가장 넓은 분포 범위를 형성하였다. Figure 3은 friction angle에 대한 증폭 결과를 나타낸 것이다. 원시 데이터는 약 24.3–41.6° 범위에 분포하였으며, SMOTE와 ADASYN은 주로 28–40° 범위에서 높은 확률밀도를 유지하였다. Kriging의 경우 약 32–42° 범위에서 데이터가 상대적으로 집중되는 경향을 보였으며, 특정 구간의 확률밀도가 증가하는 특성을 나타내었다. MC-GA는 약 15–50° 범위까지 분포 영역이 확장되는 경향을 나타내었으며, 다른 기법과 비교하여 보다 넓은 범위의 데이터를 생성하는 특성을 보였다. 증폭된 soil density는 Figure 4에 도시하였으며, 원시 데이터는 약 1700–1950 kg/m3 범위에서 분포하였고 SMOTE와 ADASYN은 약 1780–1900 kg/m3 구간에서 상대적으로 높은 확률밀도를 유지하였다. Kriging은 특정 구간에 데이터가 집중되는 경향을 나타내었으며, 분포 형태가 비교적 매끄럽게 형성되었다. MC-GA의 경우 약 1500–2200 kg/m3 수준까지 데이터 분포가 확장되었으며, 전체적으로 가장 넓은 분포 범위를 나타내었다.
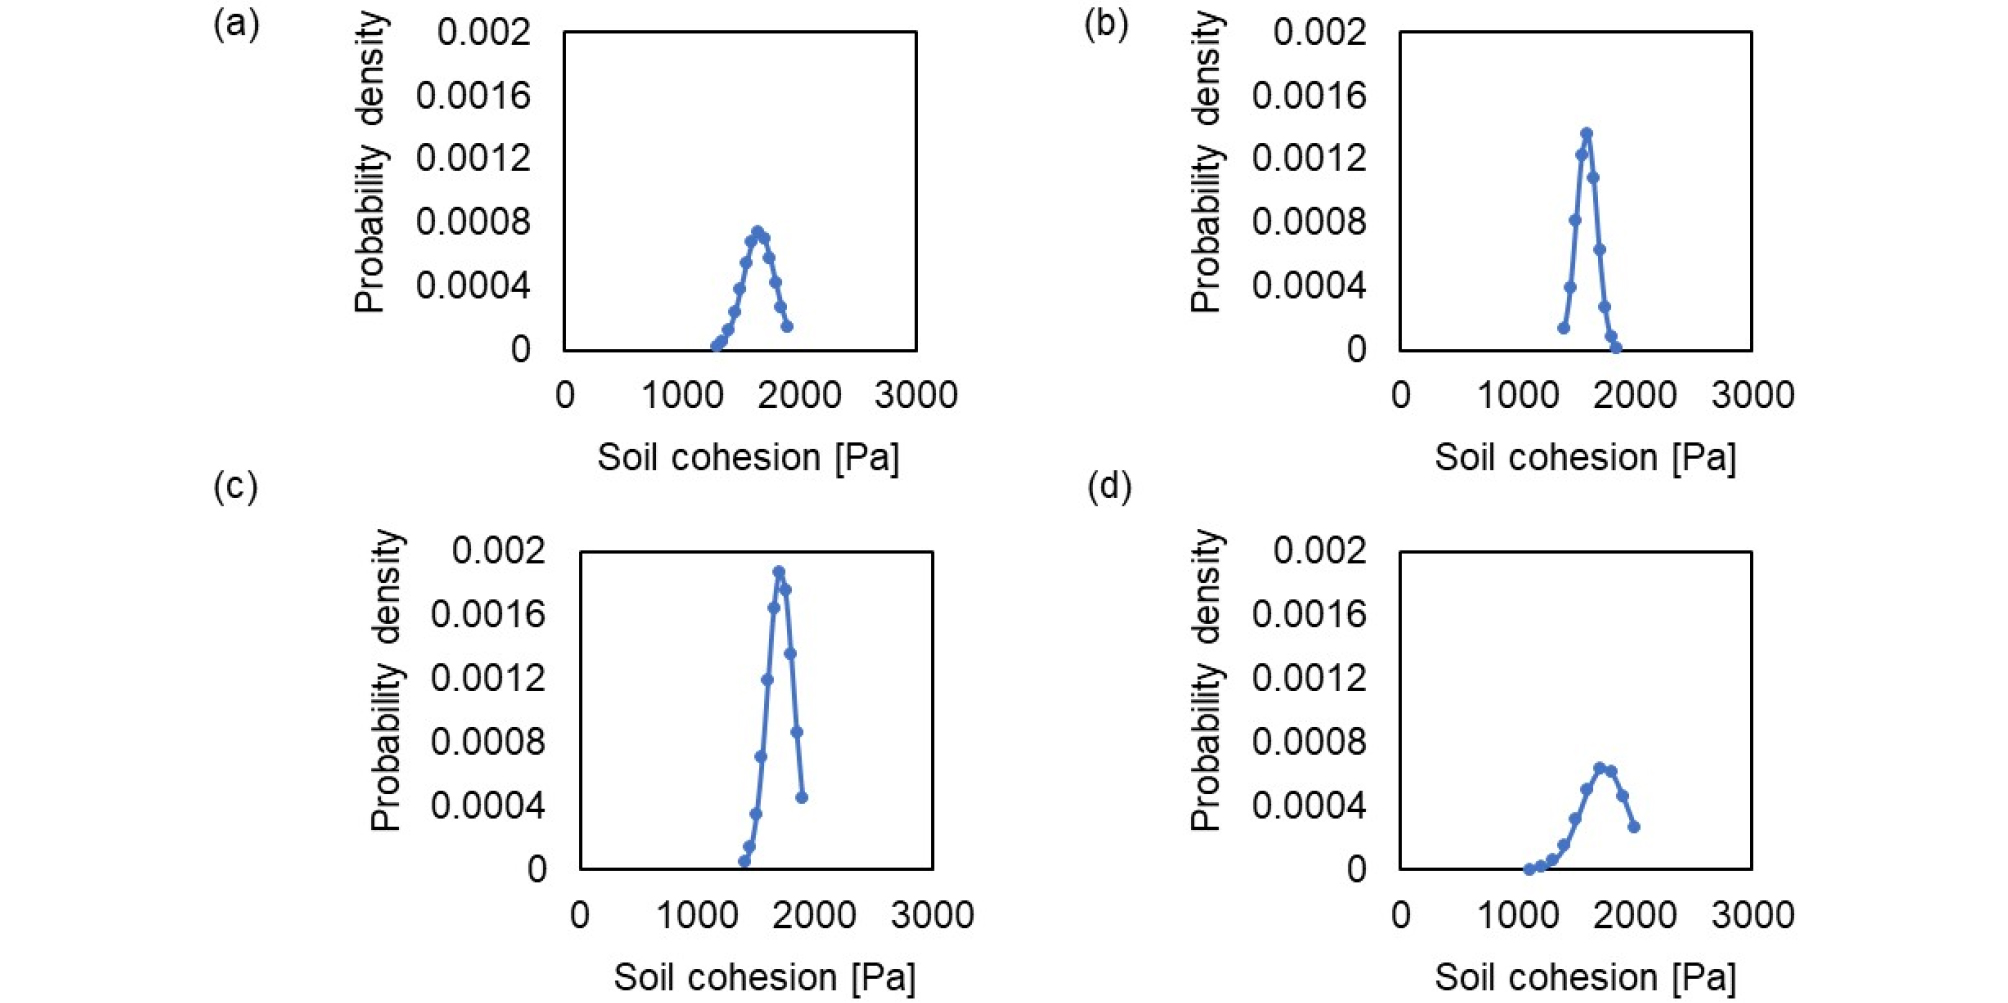
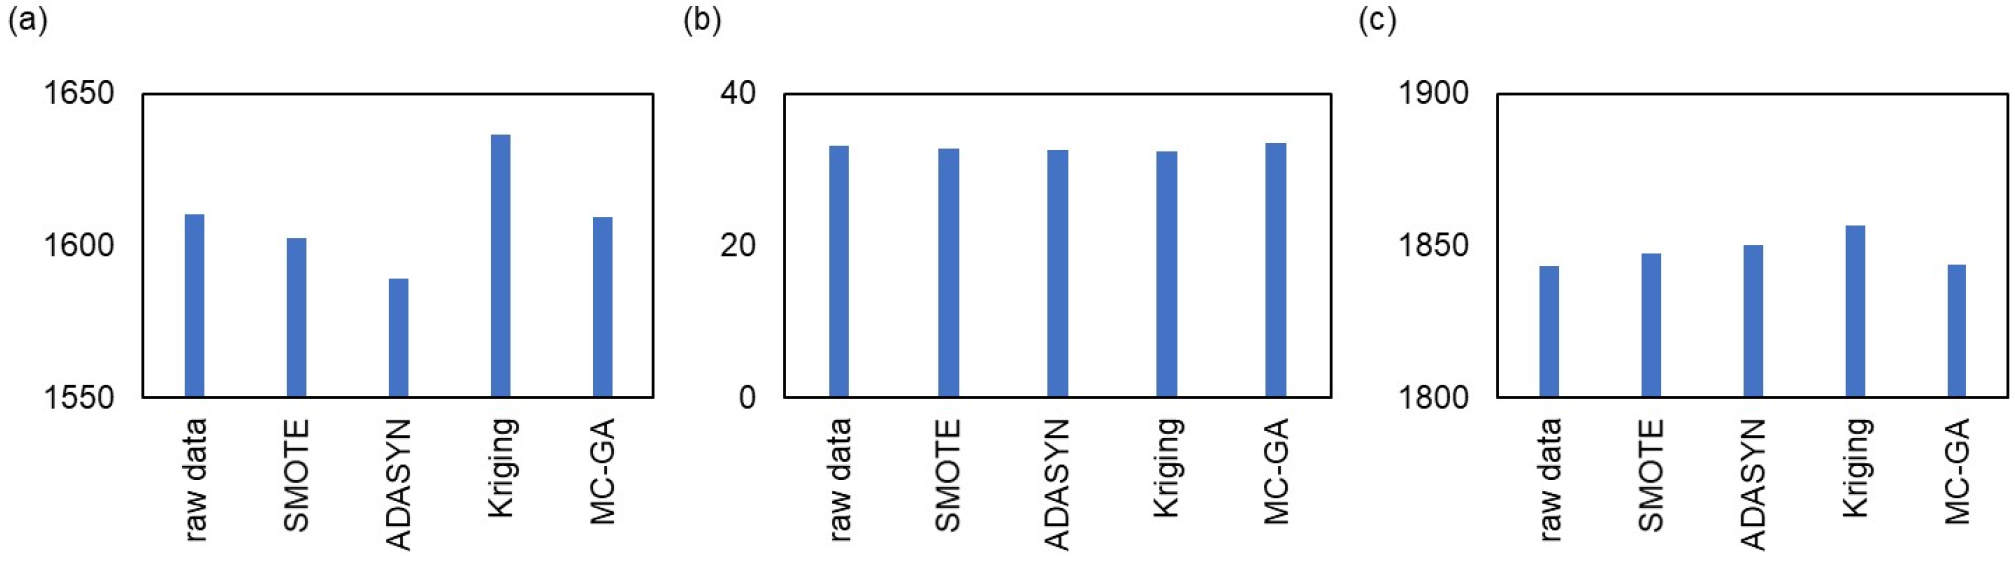
각 증폭 기법에 의해 생성된 데이터의 평균값을 전체적으로 비교하기 위해 Figure 5에 도시하였다. Soil cohesion의 평균값은 원시 데이터에서 약 1603 Pa로 나타났으며, SMOTE, ADASYN, Kriging 및 MC-GA 모두 유사한 수준의 평균값을 유지하는 것으로 분석되었다. Friction angle 역시 원시 데이터 평균값인 약 33.3°와 유사한 수준을 유지하였으며, soil density 또한 원시 데이터 평균값인 약 1840 kg/m3와 큰 차이를 나타내지 않았다. 이는 모든 증폭 기법이 평균 수준에서는 원시 데이터의 기본적인 통계 특성을 비교적 안정적으로 유지하고 있음을 의미한다. 그러나 Figure 2~4에서 확인된 바와 같이, 동일한 평균값을 유지하더라도 데이터의 분포 범위와 확률밀도 형상은 증폭 기법에 따라 상이하게 나타나는 것으로 분석되었다.
5. 토 론
해당 연구에서는 4가지 증폭 방법을 통해 지반공학 물성치의 특성이 어떻게 변화하는지 관찰하는 것이 목적이며, 결과 부분에서는 생성된 데이터를 통해 1차원적인 분석을 통해 다양성을 검토하였다. 토론 부분에서는 각각의 지반공학 물성치 간의 상관성을 통해 4가지 증폭 방법의 특징을 분석하고자 하였다(Pan et al., 2025; Sangprasat et al., 2025).
우선 원시 데이터와 각 데이터 증폭 기법에 의해 생성된 데이터의 Pearson correlation 결과를 Figure 6에 도시하였다. 원시 데이터의 경우 soil cohesion–friction angle, soil cohesion–soil density, friction angle–soil density의 상관계수는 각각 −0.03, 0.15 및 −0.09로 나타났으며, 전체적으로 변수 간 상관성이 매우 약한 것으로 분석되었다. 이는 본 연구에서 사용된 원시 데이터가 특정 변수 간의 강한 선형 관계를 가지지 않는 제한적 데이터 구조를 나타내고 있음을 의미한다. SMOTE와 ADASYN의 경우 원시 데이터의 상관구조를 비교적 유사하게 유지하는 경향을 나타내었다. SMOTE의 soil cohesion–friction angle 상관계수는 0.00 수준으로 분석되었으며, soil cohesion–soil density 및 friction angle–soil density 역시 각각 약 0.13 및 −0.08 수준으로 나타났다. ADASYN 또한 soil cohesion–friction angle 상관계수가 약 0.01 수준으로 분석되었으며, 나머지 변수 간 상관계수 역시 원시 데이터와 유사한 범위를 유지하였다. 이러한 결과는 SMOTE와 ADASYN이 기존 데이터 간의 인접 관계를 기반으로 새로운 데이터를 생성하기 때문에 원시 데이터의 구조적 특성을 비교적 안정적으로 유지한 결과로 판단된다. 반면 Kriging 기반 증폭 결과는 다른 기법과 비교하여 상관구조의 변화가 상대적으로 크게 나타났다. 특히 soil cohesion–friction angle의 상관계수는 약 0.37 수준으로 증가하였으며, 이는 원시 데이터(−0.03)와 비교할 때 상관성이 크게 강화된 결과이다. 또한 friction angle–soil density 역시 양의 상관성이 증가하는 경향을 나타내었다. 이는 Kriging이 공간적 보간을 기반으로 연속적인 데이터를 생성하는 과정에서 특정 방향의 분포 특성이 강화된 결과로 판단된다. 즉, 원시 데이터에는 존재하지 않았던 구조적 패턴이 일부 형성될 가능성이 있음을 의미한다. 따라서 Kriging은 매끄러운 데이터 분포를 생성할 수 있는 장점이 있으나, 제한된 데이터 조건에서는 인위적인 상관구조를 생성할 가능성이 존재하는 것으로 분석되었다. MC-GA의 경우 Pearson correlation 값이 대부분 −0.02~0.03 수준으로 나타나 변수 간 상관성이 거의 존재하지 않는 형태를 보였다. 이는 MC-GA가 확률 기반 탐색과 유전 알고리즘 기반 최적화 과정을 통해 상대적으로 넓은 데이터 영역을 탐색하면서 데이터 다양성을 증가시킨 결과로 판단된다. 실제로 Figure 2~4에서 MC-GA는 다른 기법 대비 가장 넓은 분포 범위를 나타내었으며, 이러한 분포 확장이 변수 간의 국부적 상관성을 상대적으로 완화시킨 것으로 해석될 수 있다. 결과적으로 MC-GA는 데이터 다양성을 증가시키는 측면에서는 효과적이었으나, 원시 데이터의 구조적 일관성을 유지하는 측면에서는 상대적으로 한계가 존재할 가능성이 있는 것으로 판단된다. 전체적으로 Figure 6의 결과는 데이터 증폭 기법에 따라 생성되는 데이터의 구조적 특성이 크게 달라질 수 있음을 보여준다. 특히 SMOTE와 ADASYN은 원시 데이터의 구조를 상대적으로 안정적으로 유지하는 반면, Kriging은 특정 상관구조를 강화하는 경향을 나타내었으며, MC-GA는 데이터 다양성을 증가시키는 대신 변수 간 상관성을 완화시키는 특성을 보였다. 따라서 제한된 지반 데이터 조건에서 데이터 증폭 기법을 적용할 경우, 단순히 데이터 개수의 증가뿐만 아니라 생성된 데이터의 구조적 특성과 상관관계 변화 역시 함께 고려할 필요가 있는 것으로 판단된다.
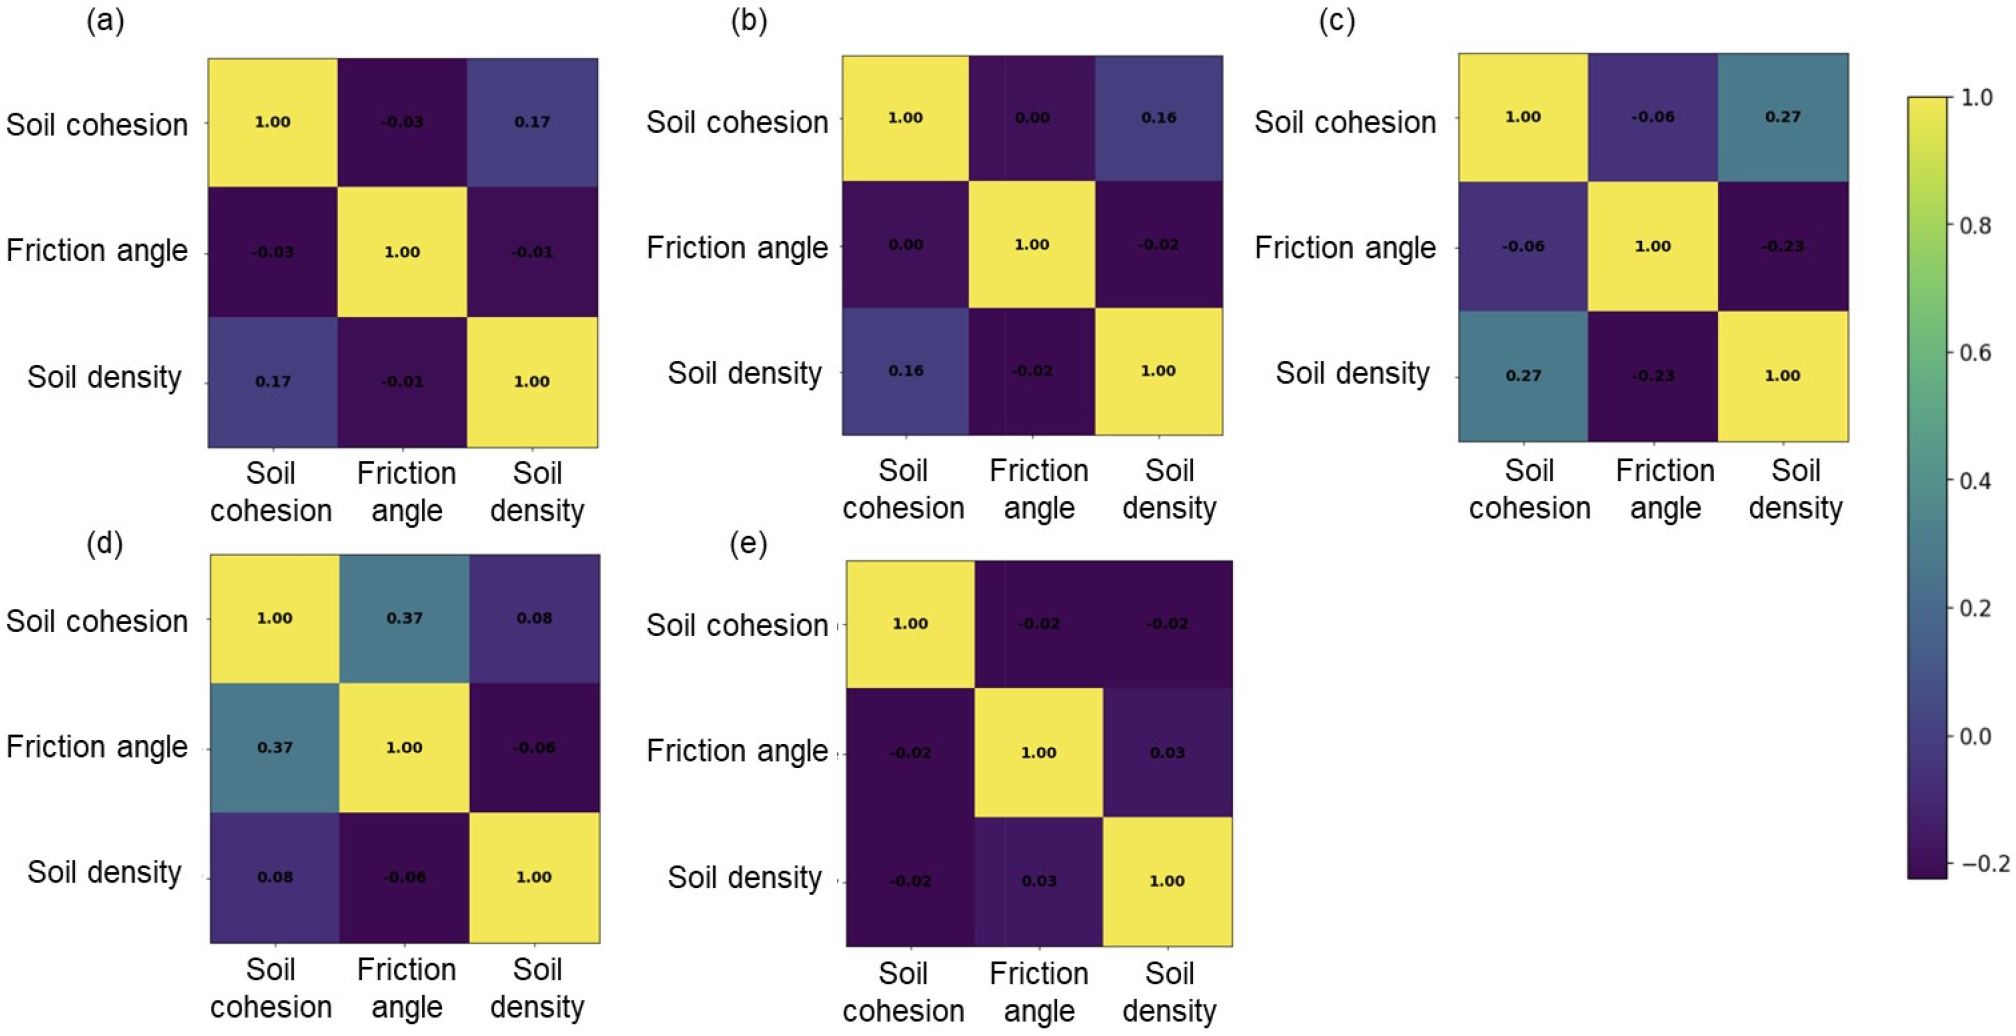
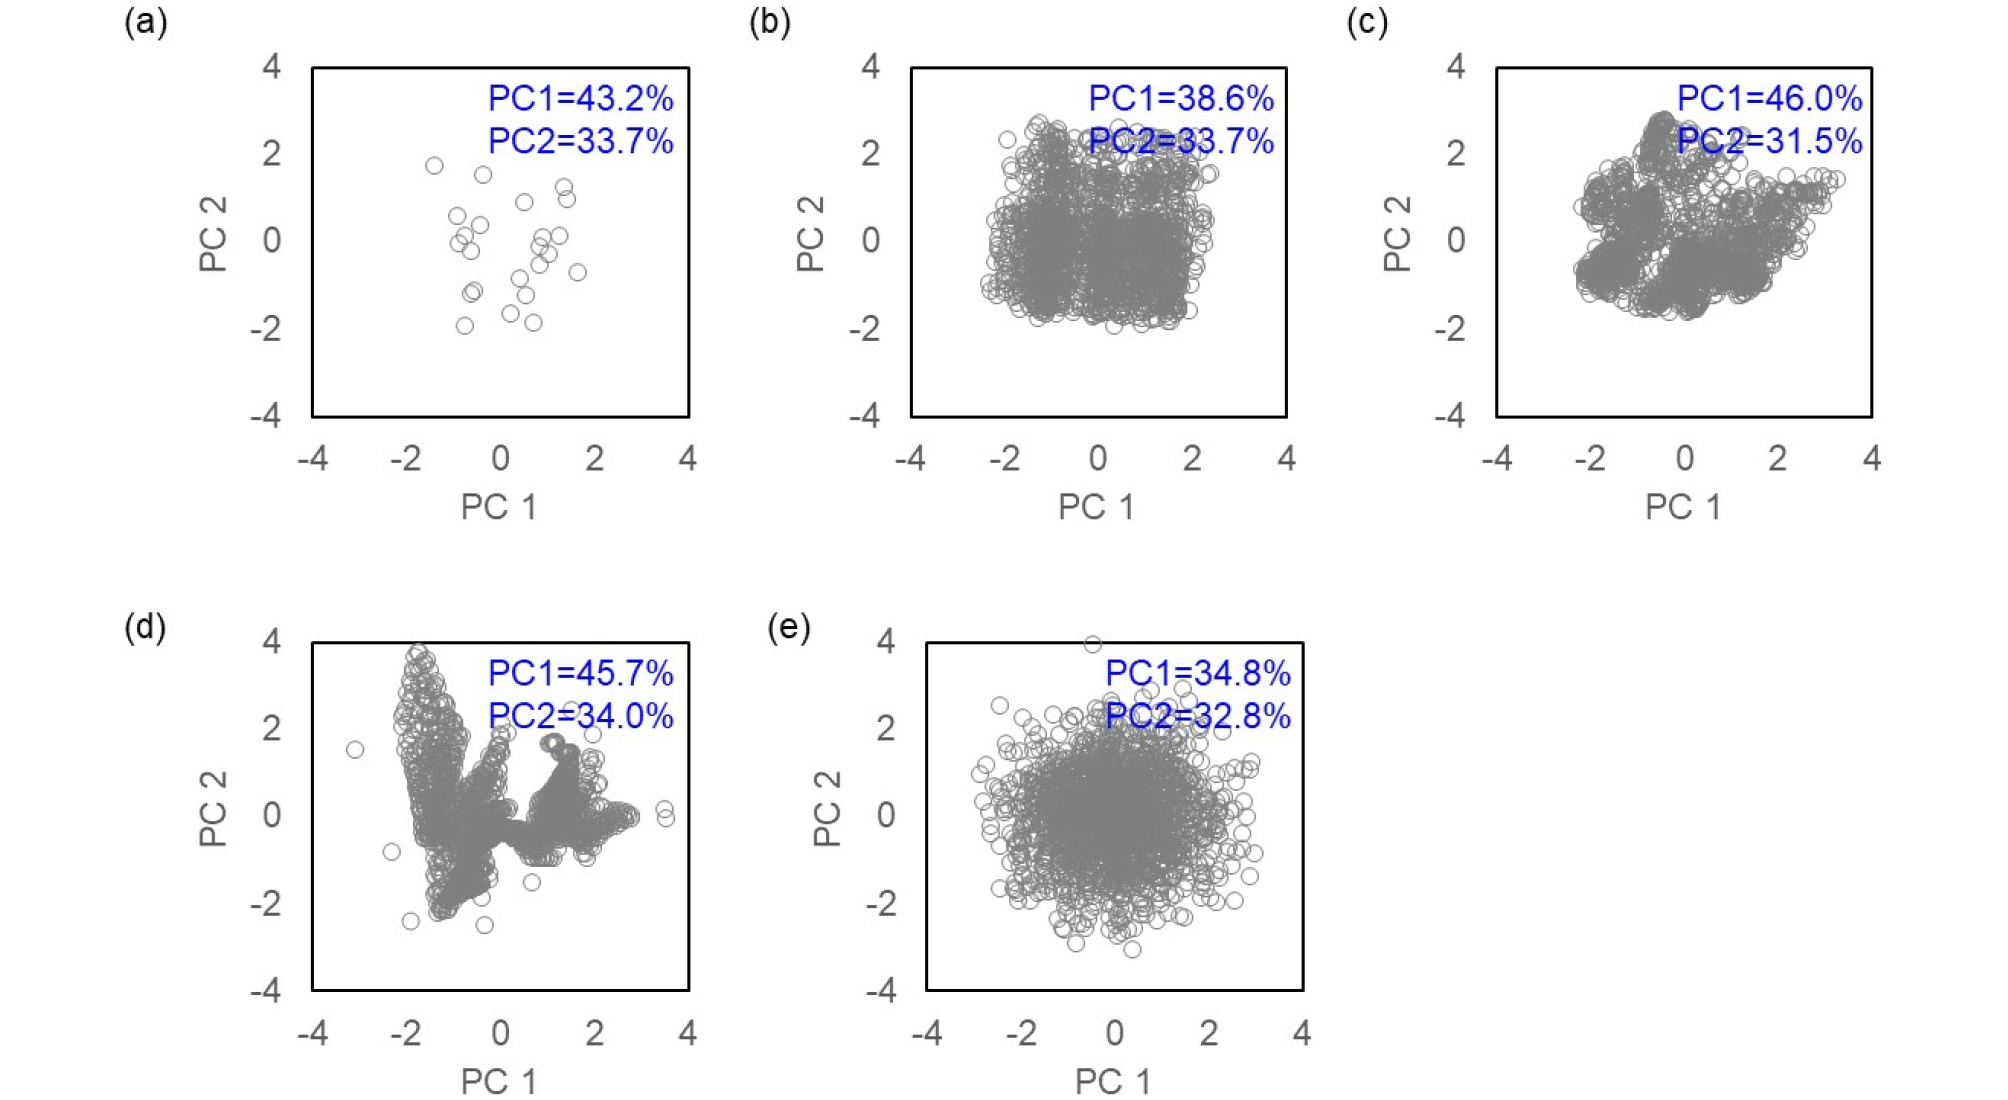
Figure 7은 원시 데이터와 각 데이터 증폭 기법에 의해 생성된 데이터의 Principal Component Analysis(PCA) 분포 결과를 나타낸 것이다. PCA는 다변량 데이터의 분산 특성을 저차원 공간으로 축소하여 데이터의 구조적 분포 특성을 분석하는 방법으로(Boumpoulis et al., 2025; Jing et al., 2025), 본 연구에서는 PC1과 PC2를 이용하여 각 증폭 기법에 따른 데이터 분포 특성을 비교하였다. 원시 데이터의 경우 PC1과 PC2의 explained variance ratio는 각각 43.2% 및 33.7%로 나타났으며, 두 주성분이 전체 데이터 분산의 약 76.9%를 설명하는 것으로 분석되었다. 또한 데이터는 PCA 공간 내에서 비교적 제한된 영역에 집중되는 경향을 나타내어, 원시 데이터의 구조적 다양성이 제한적임을 확인할 수 있었다. SMOTE의 경우 PC1과 PC2의 explained variance ratio는 각각 38.6% 및 33.7%로 나타났으며, 전체적으로 원시 데이터와 유사한 수준의 분산 설명력을 유지하였다. PCA 분포 형상 역시 원시 데이터와 유사한 군집 형태를 나타내었으며, 데이터가 특정 영역에 비교적 집중되는 경향을 보였다. 이는 SMOTE가 기존 데이터 간의 국부적 보간을 기반으로 새로운 데이터를 생성하기 때문에 원시 데이터의 구조적 특성을 상대적으로 안정적으로 유지한 결과로 판단된다. ADASYN 역시 PC1과 PC2의 explained variance ratio가 각각 46.0% 및 31.5%로 분석되었으며, 데이터 분포 형태는 원시 데이터와 유사한 경향을 나타내었다. 다만 일부 영역에서는 데이터 분포 범위가 다소 확장되는 경향이 관찰되었으며, 이는 ADASYN이 데이터 밀도가 낮은 영역을 우선적으로 증폭하는 특성에 기인한 것으로 판단된다. Kriging의 경우 PC1과 PC2의 explained variance ratio는 각각 45.7% 및 34.0%로 나타났으며, PCA 공간에서 데이터가 특정 방향으로 상대적으로 집중되는 경향을 나타내었다. 특히 일부 구간에서는 데이터 분포가 선형적으로 확장되는 형태가 관찰되었으며, 이는 Kriging 기반 공간 보간 과정에서 특정 방향의 구조적 특성이 강화된 결과로 해석될 수 있다. Figure 6의 Pearson correlation 결과와 함께 고려할 경우, Kriging은 변수 간 상관구조를 상대적으로 강화시키면서 PCA 공간에서도 특정 방향성을 가지는 데이터 구조를 형성하는 것으로 판단된다. 따라서 Kriging은 연속적이고 매끄러운 분포를 생성하는 데에는 효과적일 수 있으나, 제한된 데이터 조건에서는 원시 데이터에 존재하지 않았던 잠재적 구조 패턴을 형성할 가능성이 있는 것으로 분석되었다. 반면 MC-GA의 경우 PC1과 PC2의 explained variance ratio는 각각 34.8% 및 32.8%로 나타났으며, 다른 기법과 비교할 때 PC1의 설명력이 상대적으로 감소하는 경향을 보였다. 또한 PCA 공간에서 데이터가 전체 영역으로 넓게 분포하는 형태를 나타내었으며, 특정 군집 형태보다는 비교적 확산된 분포 특성을 보였다. 이는 MC-GA가 확률 기반 탐색과 유전 알고리즘 기반 최적화를 통해 데이터 다양성을 증가시키면서 보다 넓은 잠재 공간을 탐색한 결과로 판단된다. 실제로 Figure 2~4에서도 MC-GA는 다른 증폭 기법 대비 가장 넓은 확률밀도 분포 범위를 나타내었으며, PCA 결과 역시 이러한 특성을 반영하는 것으로 분석되었다. 그러나 데이터 분포가 과도하게 확산될 경우 원시 데이터의 구조적 일관성이 감소할 가능성이 있으므로, 데이터 다양성과 구조 유지 간의 균형이 중요할 것으로 판단된다. 결국 Figure 7의 PCA 결과는 데이터 증폭 기법에 따라 생성되는 데이터의 잠재 공간 구조가 크게 달라질 수 있음을 보여준다. SMOTE와 ADASYN은 원시 데이터의 구조적 특성을 비교적 안정적으로 유지하는 경향을 보인 반면, Kriging은 특정 방향의 구조를 강화하는 특성을 나타내었으며, MC-GA는 가장 넓은 데이터 탐색 범위를 형성하는 경향을 나타내었다. 따라서 제한된 지반 데이터 조건에서 데이터 증폭 기법을 적용할 경우, 단순한 데이터 수 증가뿐만 아니라 생성된 데이터의 구조적 특성과 잠재 공간 분포 특성 역시 함께 고려할 필요가 있는 것으로 판단된다.
6. 결 론
본 연구에서는 제한된 지반 물성치 데이터를 대상으로 SMOTE, ADASYN, Kriging 및 MC-GA 기반 데이터 증폭 기법을 적용하고, 생성된 데이터의 분포 특성 및 구조적 특성을 비교 분석하였다. 이를 위해 soil cohesion, friction angle 및 soil density를 대상으로 확률밀도함수, 평균값 비교, Pearson correlation 및 PCA 분석을 수행하였으며, 구체적인 결론은 다음과 같이 정리된다.
(1) 모든 데이터 증폭 기법은 원시 데이터의 평균값을 비교적 유사하게 유지하는 것으로 나타났다. 그러나 데이터의 분포 범위와 구조적 특성에서는 증폭 기법에 따라 차이가 발생하였다. SMOTE와 ADASYN은 원시 데이터 주변에서 새로운 데이터를 생성하는 경향을 나타내었으며, 평균값과 상관구조를 비교적 안정적으로 유지하는 특성을 보였다.
(2) 반면 Kriging은 특정 구간에서 데이터가 집중되는 경향을 나타내었으며, 일부 변수 간 상관성이 증가하는 결과를 보였다. 이는 공간 보간 기반 특성에 의해 특정 방향의 구조가 강화된 결과로 판단된다. MC-GA의 경우 다른 기법과 비교하여 가장 넓은 분포 범위를 나타내었으며, PCA 결과에서도 상대적으로 넓은 잠재 공간 분포 특성을 보였다. 이는 데이터 다양성 측면에서는 효과적일 수 있으나, 원시 데이터의 구조적 일관성은 상대적으로 감소할 가능성이 있는 것으로 분석되었다.
(3) Pearson correlation 및 PCA 분석 결과를 종합적으로 고려할 때, 데이터 증폭 기법은 단순히 데이터 개수를 증가시키는 역할뿐만 아니라 생성되는 데이터의 구조적 특성에도 직접적인 영향을 미치는 것으로 나타났다. 따라서 제한된 지반 데이터 조건에서 데이터 증폭 기법을 적용할 경우, 단순한 데이터 수 증가뿐만 아니라 생성 데이터의 분포 특성, 상관관계 및 잠재 공간 구조 등을 함께 고려할 필요가 있는 것으로 판단된다.
(4) 본 연구는 제한된 지반 물성치 데이터를 대상으로 다양한 데이터 증폭 기법의 구조적 특성을 비교하였다는 점에서 의미가 있다. 다만 본 연구에서는 생성된 데이터를 활용한 실제 예측 성능 검증까지는 수행하지 못하였으며, 향후에는 사면 안정성 해석 또는 전단강도 예측과 같은 실제 지반공학 문제에 적용하여 데이터 증폭 기법에 따른 예측 성능 및 신뢰성 변화를 추가적으로 분석할 필요가 있을 것으로 판단된다.