

1. 서 론
2. 연구 지역 및 자료 수집
2.1 연구 지역
2.2 자료 수집 및 전처리
2.3 자료의 공간 구조
3. 분석 방법
3.1 공간 인코딩 기법
3.2 XGBoost 회귀 절차 및 최적화
3.3 모델 훈련(model training) 및 평가(evaluation)
3.4 공간 자기 상관 해석(spatial autocorrelation interpretation)
3.5 특징 중요도 분석
4. 결과 및 토의
4.1 최적의 공간 인코딩 매개변수
4.2 교차 검증 일반화
4.3 테스트 세트에서의 예측 성능
4.4 잔차 분포 분석
4.5 잔차 공간 자기상관
4.6 SHAP를 이용한 특징 중요도
5. 결 론
1. 서 론
매립지 건설사업에서의 압밀 침하는 주로 매립된 성토 재료의 자중에 의해 발생하며, 이러한 상재하중은 오랜 기간 동안 하부의 연약 해성 점토를 침하 시킨다. 상부 구조물에서 가해지는 하중은 압밀 과정을 더욱 복잡하게 만들어 정확한 침하 예측은 매립 지반에서 안전하고 비용적/효율적인 설계에 필수적이다(Liu and Pu, 2018). Terzaghi(1943)의 1차원 압밀 이론은 압축지수(Cc), 초기 간극비(e0), 유효 응력 증가분(Δσ′)에 따른 침하량의 관계를 확립하여 일반적으로 널리 사용되고 있다. 그러나, 넓은 부지의 압밀 침하량을 예측하기 위해서는 다수의 시추공 작업을 통한 불교란 시료의 획득 및 이를 이용한 실내실험이 필요하며, 부지 전반에 걸쳐 지반 특성의 변동성이 클 경우 적용에 어려움이 따른다. 인천 송도 신도시의 경우가 대표적이 사례이며, 두꺼운 실트질 점토층 위에 매립된 성토재가 수 km2에 걸쳐 공간적으로 가변적인 압밀을 유발하고 있다(Doğan and Akbaş, 2026; Kim et al., 2012).
최근 들어 지반 공학 분야에서 기계 학습(ML)은 실험실에서 획득한 결과를 바탕으로 한 예측 방법의 한계를 극복하기 위한 대안으로 큰 주목을 받고 있다(Shahin, 2024). Gradient boosting algorithms, random forest, deep learning architectures 등의 기계 학습 모델들은 시추공 자료에서 비선형 관계를 직접 학습하여 침하 및 지반 특성 파악 등 지반공학적 예측이 가능한 것을 보여주었다(Gajan and Kantor, 2025; Jalali et al., 2025). 또한, SHapley Additive exPlanations(SHAP)와 같은 설명 가능성 방법들은 이러한 모델의 실용적 적용을 더욱 강화하여, 실무자들이 예측과 함께 특징 기여도를 분석할 수 있도록 한다(Ma et al., 2026; Shan et al., 2025). 이러한 발전에도 불구하고, 많은 지반 공학 분야에서 기계 학습 연구들은 예측을 순전히 지반 특성값 또는 지반 정수 기반 문제로 취급하며, 이들의 공간적 분포에 대한 관심을 기울이지 않는다. Tobler(1970)의 지리학 제1법칙에 따르면 인접한 시추공은 유사한 지반 조건을 공유하는 경향이 있는데, 이러한 공간적 구조의 무시는 유의미한 정보를 적절하게 활용하지 못하게 만든다.
지리적 좌표는 기계 학습 모델에 위치를 입력하는 가장 일반적인 방법이지만, 원시 좌표(raw coordinates) 값은 종종 비선형적인 공간 관계 위에 선형적 가정을 적용한 가장 단순한 공간 인코딩만은 부여한다(Behrens et al., 2018; Hengl et al., 2018). 따라서, 원시 좌표(raw coordinates)는 지역 근접성 패턴을 포착하지 못하고 부지 경계의 기하학적 형태를 반영하지 못하여, 복잡한 공간적 변동성에 제대로 대응하지 못하게 된다. 선행 연구에 따르면, 환경 분야 및 토양 과학 응용 분야에서 종종 사용되는 Euclidean distance fields 및 polynomial coordinate expansions과 같은 더 풍부한 공간 표현 방법은 예측 성능을 상당히 향상시키는 것으로 알려져 있다(Hengl et al., 2018; Ohmer et al., 2025; Sekulić et al., 2020). 지반 공학 분야의 선행 연구에 따르면, 공간 자기 상관 모델(spatial autocorrelation modeling) 기법이 원시 좌표만을 사용하는 방식보다 이점을 보여주었으며(Kim et al., 2023), 시추공 근접장(borehole proximity field) 방법은 지반 특성의 공간적 예측을 개선하였다(Chen et al., 2024; Soleimanfar et al., 2025). 하지만 지반 침하 예측을 위한 공간 인코딩 전략 또는 기법에 대한 체계적인 평가는 아직 부족한 편이며, 인코딩 기법 선택에 대한 실질적인 지침을 제공하지 못하고 있다.
이러한 한계를 극복하기 위하여, 본 연구에서는 송도 신도시의 376개 시추공 자료를 활용하여 XGBoost 회귀 기법에서 다섯 가지 공간 인코딩 방법을 검토/적용하고 평가하였다. 인코딩 기법은 가장 기본적인 공간 표현인 원시 좌표(COOR), Euclidean distance to neighboring points(EDNP), buffer boundary distances(BUFF), polynomial coordinate features(POLY), radial basis functions(RBF)를 적용하였다. 각 인코딩 방법의 성능은 예측 정확성 지표, Moran’s I를 통한 잔류 공간 자기상관도(residual spatial autocorrelation), SHAP 기반 특징 기여도 분석을 통해 평가되었으며, 모든 인코딩 방법에 Bayesian Hyperparameter 최적화가 일관되게 적용되었다.
2. 연구 지역 및 자료 수집
2.1 연구 지역
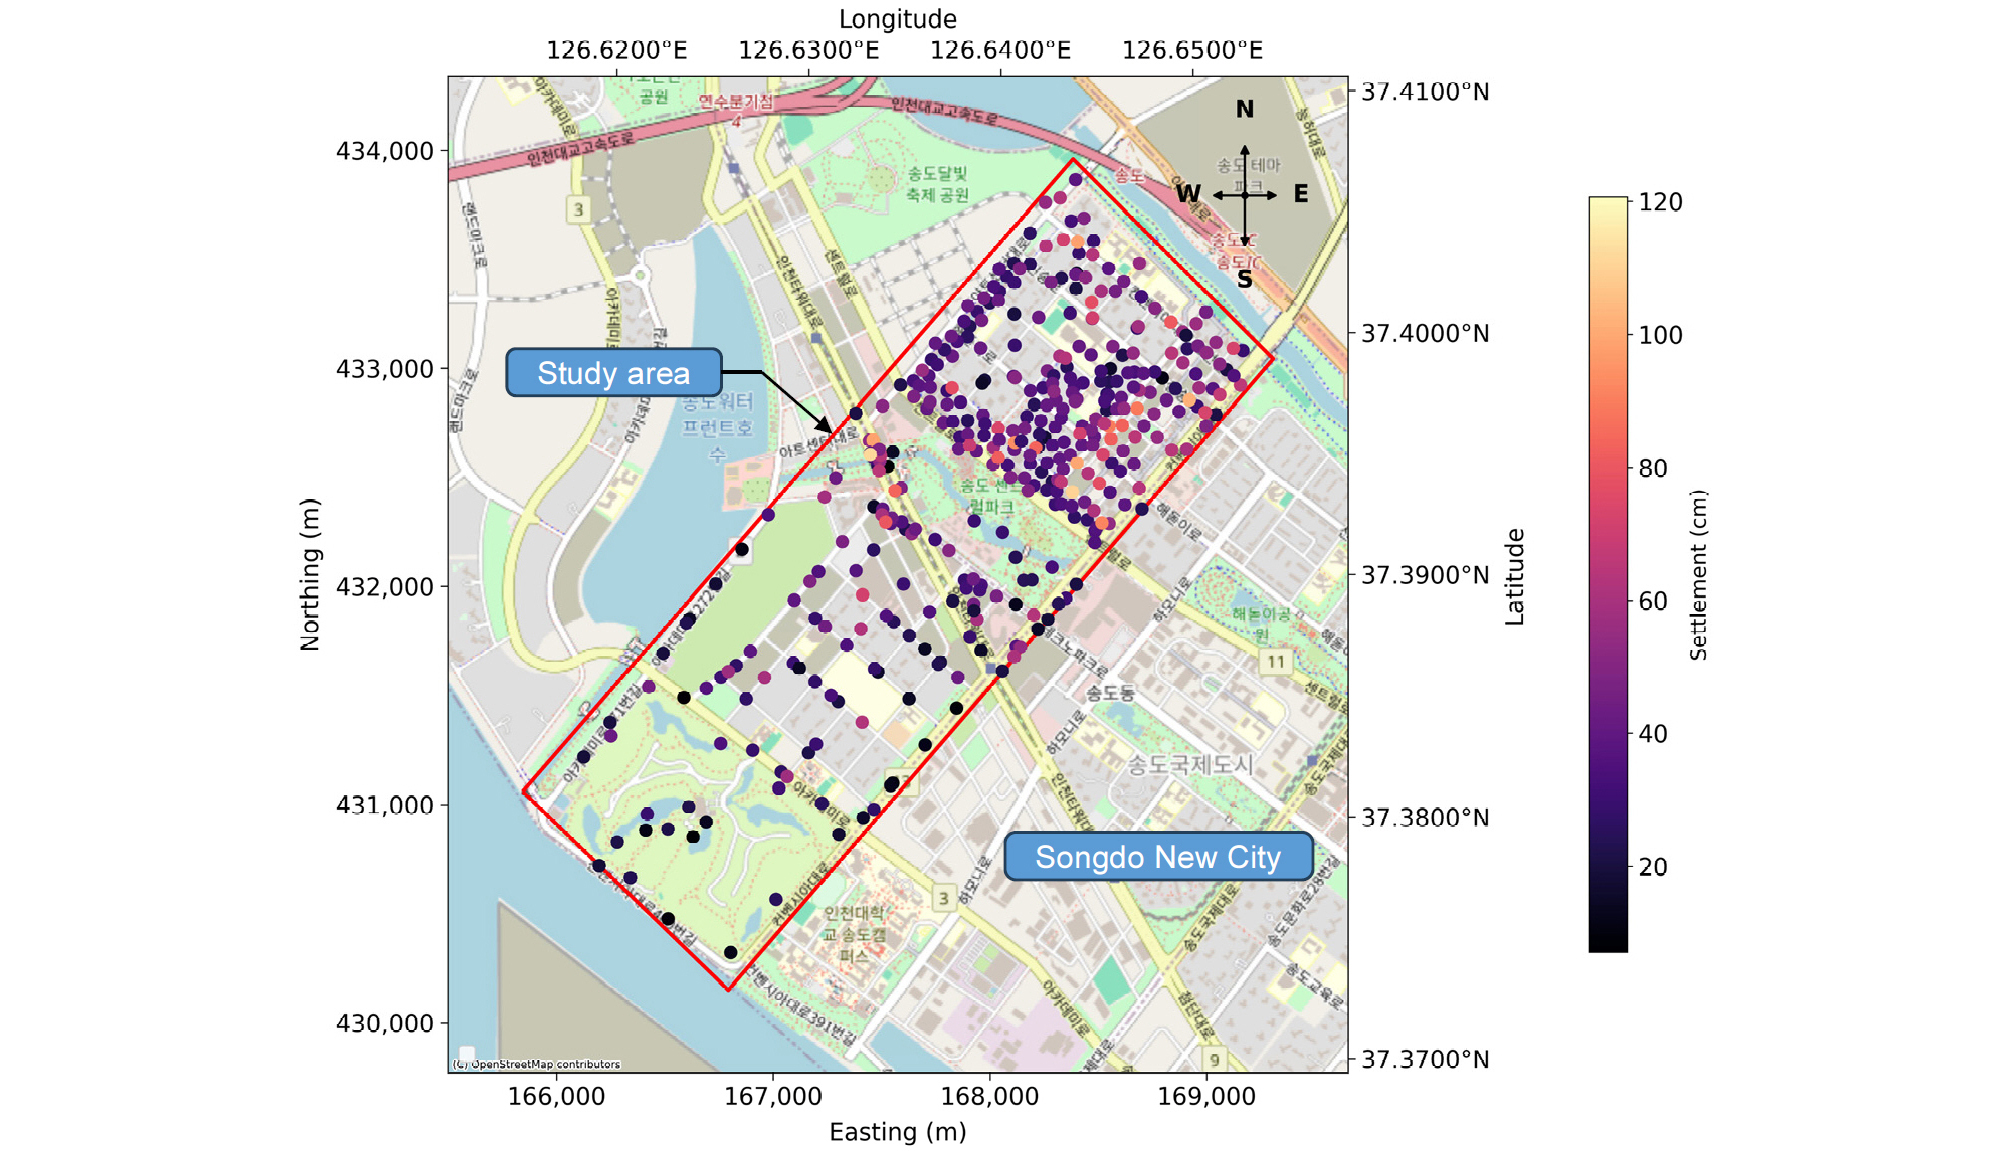
Fig. 1은 본 연구의 대상 지역인 대한민국 인천 송도 신도시의 위치, 시추공 분포 및 시추공 위치에서 계산된 1차원 압밀 침하량을 보여준다. 연구 대상 지역은 전 세계적으로 가장 광범위한 매립 사업이 진행된 지역 중 하나로, 위도 37°21′ – 37°25′ N, 경도 126°35′ – 126°41′ E 내에 약 53.4 km2의 면적을 포함한다. 송도 신도시 지역은 인접한 서해에서 채취한 실트질 모래를 사용하여 대규모 준설 및 수압식 매립을 통해 조성되었으며, 매립 지반 아래에는 두껍고 연약한 해성 실트질 점토층이 남아있다. 이러한 점토층은 압축성이 매우 높아 장기적인 압밀 침하에 취약하므로, 송도 신도시의 경우 침하 예측 절차를 평가하기에 적합한 부지로 판단된다. 지반 조사를 위한 시추공 분포를 살펴보면, 송도 신도시 전역에 걸쳐 십자형 패턴으로 시추공 네트워크가 분포되어 있으며, 본 연구에서는 적절한 모델의 훈련 및 평가를 위해 Fig. 1과 같이 충분하고 일관 시추공 밀도를 보이는 약 5.0 km2 면적의 일부 영역의 자료를 활용하였다.
2.2 자료 수집 및 전처리
연구 지역 전체에 분포된 376개 시추공에서 현장 자료 및 실내 시험 결과를 수집하였다. 수집된 자료는 압밀층에서 측정된 압축성 실트 및 점토층의 두께(H0), 함수비(ωn), 액성 한계(LL), 초기 간극비(e0), 압축층 중앙부의 수직 유효 응력(σ'v), 매립 성토 하중에 의해 유도된 수직 유효 응력 증가분(Δσ'v)의 여섯 가지 지반 매개변수 및 1차 압밀 침하량(Spc)을 포함한다. 1차 압밀 침하량(Spc)은 정규 압밀 조건 하에서 Terzaghi의 1차원 압밀 이론을 사용하여 식 (1)과 같이 계산하였다.
Fig. 1과 같이, 계산된 Spc는 7.02 cm에서 120.70 cm 범위로, 부지 전체에 걸쳐 지반 압축성의 큰 공간적 변동성을 보여준다. 수집된 자료의 통계적 분석 결과는 Table 1과 같다.
Table 1.
Descriptive statistics of predictor variables and target settlement (n = 376)
모델링에 앞서 Spc에 로그(logarithm) 변환을 적용하여 Spc값의 비대칭성을 줄이고 목표 변수의 분포 특성을 개선했다(Osborne, 2010). 80/20 훈련-테스트(train-test) 분할을 통해 299개의 훈련 표본과 77개의 테스트 표본을 생성하였으며, 한국 공식 지리좌표계를 기반한 시추공의 원시 좌표(raw coordinates)는 모든 인코딩 변환을 위한 공간적 기반으로 사용되었다.
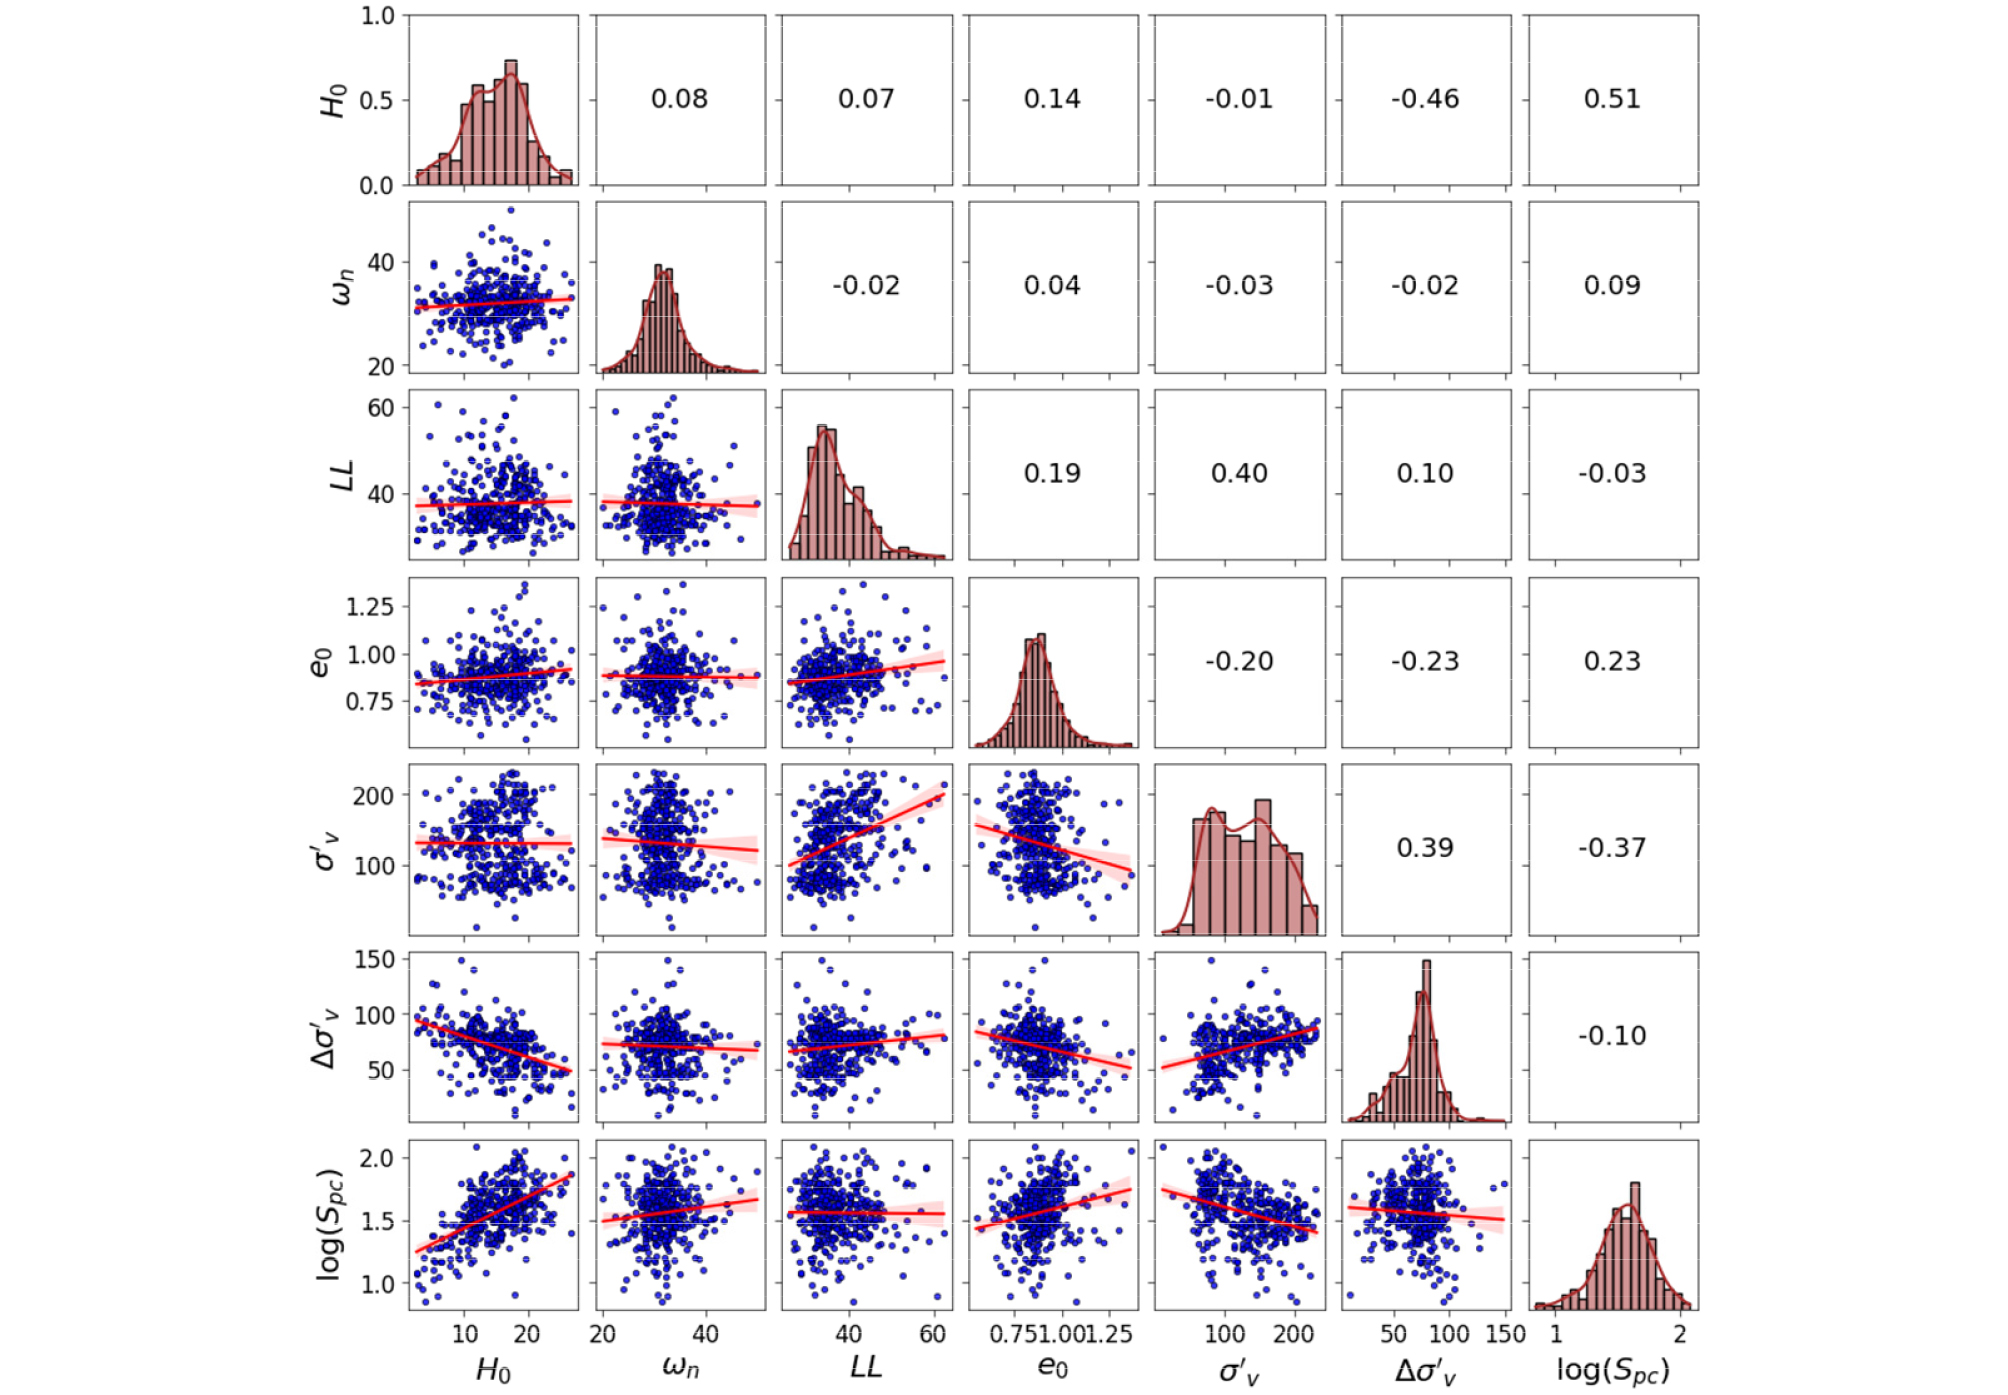
개별 입력 지반 변수 특징이 log(Spc)와 어떻게 관련되어 있는지 조사하고 예측 변수 간의 잠재적 중복성을 평가하기 위해 Spearman rank correlation 분석을 수행하였으며, 결과는 Fig. 2와 같다. Spearman 분석은 선형적 의존성을 가정하기보다는, 분포 형태와 무관하게 단조 연관성(monotonic association)을 포착하므로, 다중 스케일(mixed-scale)의 특성을 가지는 지반 변수 분석에 적합하다. 모든 변수 중에서 H0가 log(Spc)(ρ = 0.51)와 가장 높은 연관성을 보였는데, 이는 응력 상태만 단독으로 고려할 때보다 지층의 기하학적 형태가 침하량의 크기를 좌우하는데 더 직접적인 역할을 한다는 것을 보여준다. 반대로, σ'v는 보통 수준의 음의 연관성(ρ = -0.37)을 보였는데, 이는 현재의 응력 수준과 적용된 하중 증가량의 상대적 크기 사이의 반비례 관계 때문으로 판단된다. e0(ρ = 0.23), ωn(ρ = 0.09), Δσ'v(ρ = -0.10), LL(ρ = -0.03)와 같은 변수들은 점진적으로 더 낮은 연관성을 보였는데, 이는 이 변수들이 침하에 미치는 영향이 직접적 단조 경향(monotonic trend)이 아니라 다른 변수들과 상호작용을 통해 발생한다는 것을 의미한다. 예측 변수들 간의 상호상관관계는 전반적으로 낮은 수준을 보였으며(|ρ| ≤ 0.46), 이는 선택된 변수들이 예측 작업에 중복되지 않은 정보를 제공한다는 가정을 뒷받침한다.
2.3 자료의 공간 구조
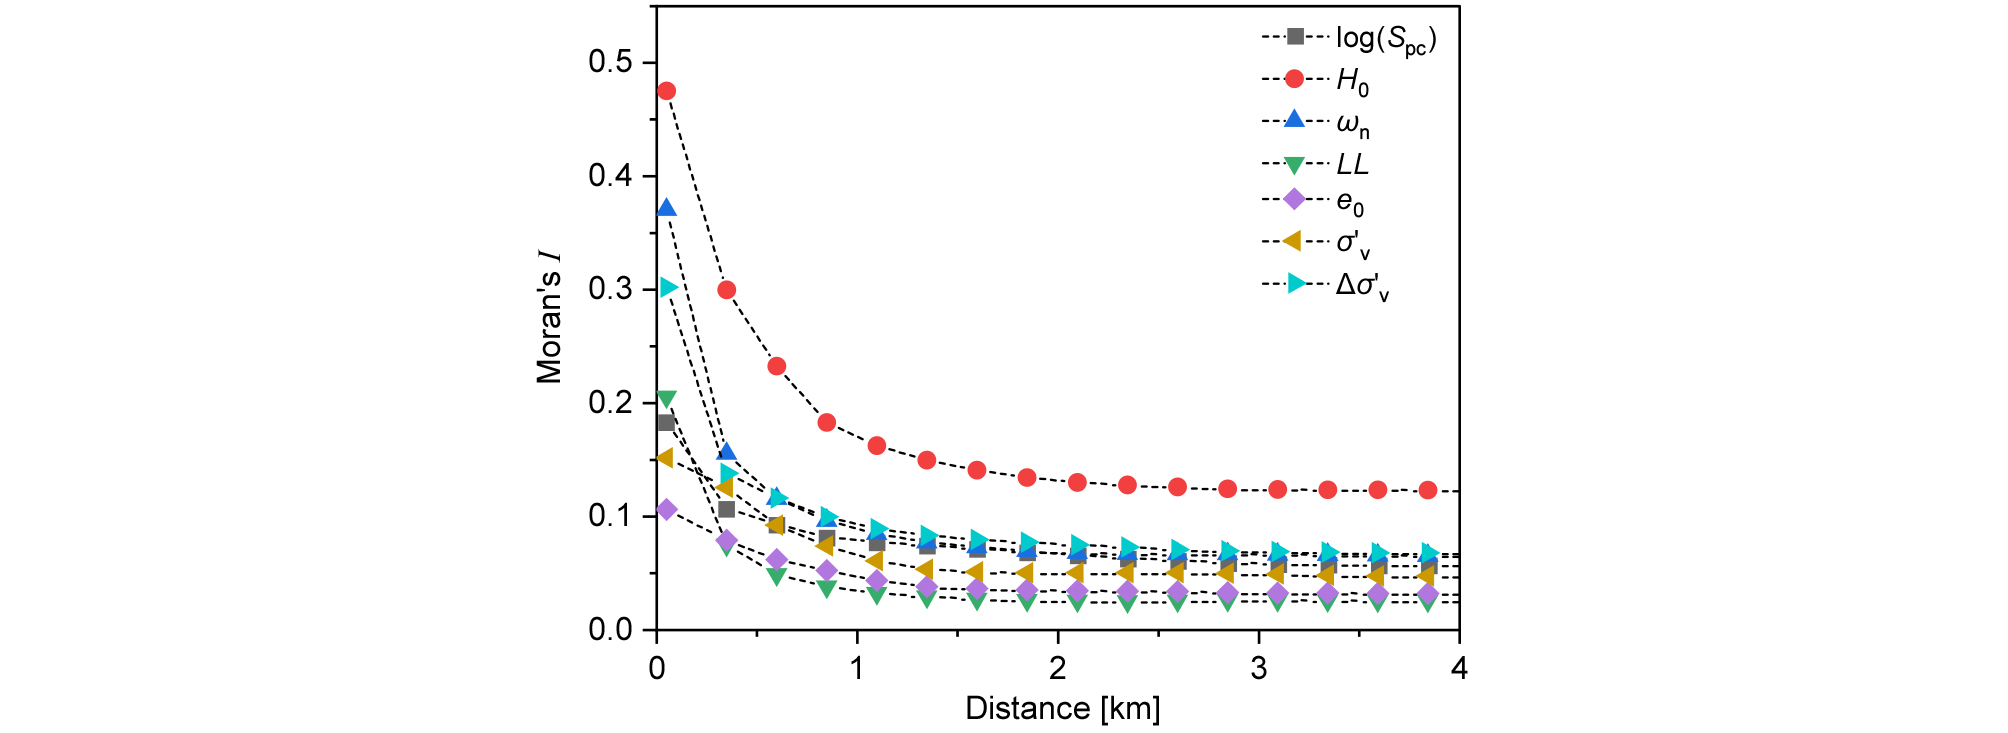
모델링을 수행하기 전에 자료 set의 현장 규모 공간 의존성(site-scale spatial dependence)을 특성화하기 위하여 6개 모든 입력 지반 변수 특징과 log(Spc)에 대해 최대 4 km까지의 거리 대역(distance band)에 걸쳐 Moran’s I를 계산하였다(Fig. 3). 모든 변수 특성들은 가장 짧은 거리 구간(~0.05 km)에서 양 (+)의 공간적 자기상관성(spatial autocorrelation)을 보였으며, H0가 가장 높은 Moran’s I(0.475) 값을 보였으며 ωn(0.370), Δσ′v(0.302), LL(0.205), log(Spc)(0.183), σ′v(0.151), e0(0.105) 순으로 나타냈다. 모든 변수의 Moran’s I 값은 처음 1 km 이내에서 급격히 감소하다 약 2 km 이상에서 안정화되는 경향을 보였으며, 이는 압밀 조건이 비교적 짧은 거리 내에서도 변화하는 매립 지반의 단거리 지질학적 변동성 특성을 잘 보여주는 것을 의미한다. 입력 변수 특징과 목표 변수 모두에서 의미 있는 공간적 자기상관성(spatial autocorrelation)이 존재한다는 것은 시추공의 위치가 지반 공학적 매개 변수만으로는 파악할 수 없는 예측 정보를 포함한다는 것을 보여주며, 이러한 공간 구조 특성을 무시하는 모델은 실제 관측값과 모델 예측값의 차이인 잔차(residual)에 활용 가능한 공간적 의존성을 방치할 가능성이 있다.
3. 분석 방법
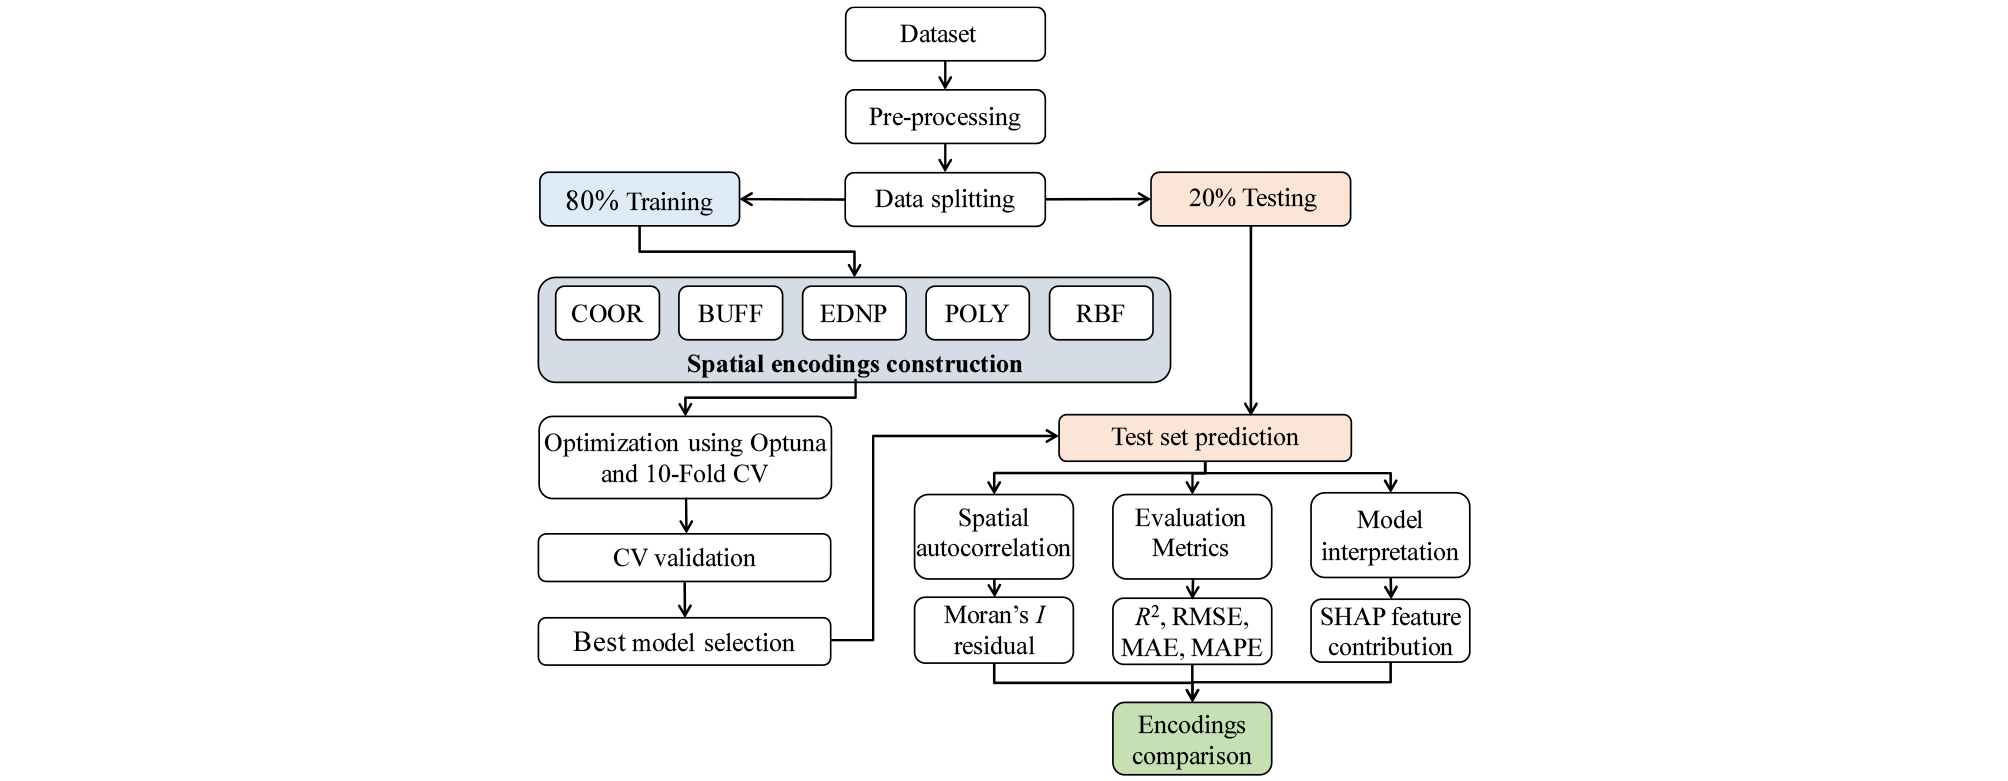
본 연구에서는 Fig. 4와 같이 5단계의 순차적인 분석을 실시하였다. 지반 조사 자료를 전처리 후, 훈련 및 테스트 set로 분할하고, 다섯 가지 공간 인코딩 기법을 적용하여 XGBoost 회귀 모델을 위한 공간적으로 확장된 자료 set를 생성하였다. 각 인코딩 기법은 Bayesian hyperparameter tuning을 적용한 10-folds 교차 검증(CV)을 통해 최적화 및 평가되었으며, 각 인코딩 별로 가장 뛰어난 성능을 보인 모델을 독립적인 테스트 set에서 추가로 평가하였다. 예측 정확도 평가 지표 외에 모델의 거동을 분석하기 위하여 잔차 공간 자기상관 및 SHAP 기반 특징 기여도 분석을 실시하였다.
3.1 공간 인코딩 기법
공간 인코딩은 시추공 좌표를 원시 좌표(raw coordinate) 값보다 더 풍부한 공간 정보를 담은 특징 표현으로 변환한다. 지리좌표계뿐만 아니라 복잡한 공간 표현이 가능한 네 가지 인코딩 기법이 체계적으로 평가되었으며, 각 인코딩은 테스트 위치 정보가 모델로 유출되는 것을 방지하기 위해 각 학습 fold 자료에만 적용되었다. 원시 좌표(COOR)는 동좌표(E)와 북좌표(N)를 모델 입력값으로 직접 적용하였으며, 다른 모든 인코딩 기법의 성능을 비교하는 기준(baseline) 역할을 했다:
여기서, Ei와 Ni는 시추공 i의 동좌표와 북좌표를 나타낸다.
Euclidean distance to neighboring points(EDNP)는 공간적 정보를 거리 기반 표현으로 인코딩하는 지반공학적 거리장 처리 절차에 개념을 두고 있으며(Behrens et al., 2018; Xie et al., 2022), 작동 방식면에서는 random forest spatial interpolation(RFSI)(Sekulić et al., 2020)의 거리 계산 원리를 따른다. 각 시추공에 대해, 학습 fold 내에서 가장 가까운 K개의 이웃까지의 거리는 다음과 같이 계산되었다.
이러한 K 거리(K distances)로부터 개별 거리, 평균, 최솟값, 최댓값 및 표준 편차를 포함한 통계적 요약값을 도출하여 EDNP 특징 벡터를 구성하였다. 이웃의 수 K는 K ∈ {5, 10, 15, 20, 25, 30} 범위 내에서 조정 가능한 매개 변수(tunable parameter)로 설정하였다.
Buffer boundary distances(BUFF)는 각 시추공에서 부지 경계를 따라 분포된 K개의 기준점까지의 유클리드 거리를 측정한 것으로, 연구 영역 내의 전체적인 공간적 정보를 인코딩한다. 각 시추공 i에 대해 k번째 경계 기준점까지의 거리는 다음과 같이 계산한다:
여기서, 는 k번째 경계 기준점을 나타내고, p는 해당 경계 세그먼트를 따라 존재하는 임의의 점을 의미한다. EDNP와 유사하게, BUFF는 공간 정보를 경계 참조 거리(boundary-referenced distances)를 통해 표현함으로써 GDF 절차와 개념적 기반을 공유한다(Behrens et al., 2018; Xie et al., 2022). BUFF 기법에서 경계 기준점의 수 K는 네 개의 모서리 지점에서 부지 경계를 따라 분포된 최대 12개 지점까지의 범위 K ∈ {4, 6, 8, 10, 12} 내에서 최적화되었다.
Polynomial coordinate features(POLY)은 정규화된 동좌표 및 북좌표를 n차 다항식 특징 세트로 확장하여 개의 특징을 생성한다. 좌표는 먼저 다음과 같이 정규화된다:
여기서, , 및 , 는 각각 훈련 fold 동좌표와 북좌표의 평균 및 표준 편차이다. 다항식 차수 n은 n ∈ {2, 3, 4} 범위 내에서 최적화되었다.
Radial basis functions(RBF)는 훈련 fold에 K-평균(K-mean) 군집화를 적용하여 선택된 M개의 앵커 포인트(anchor point)(i.e., 기준점)를 기준으로 좌표를 유사성 기반 특징(similarity-based features)으로 변환하였다. Gaussian kernel은 다음과 같이 적용하였다:
여기서, 는 위치(Ei, Ni)에 있는 시추공 i에서 앵커 포인트 cm까지의 유클리드 거리이며, ϑ는 공간적 영향의 범위를 제어하는 대역폭(bandwidth) 매개변수이다(Rahimi and Recht, 2007). 시추공 주변의 인접 규모부터 연구 대상 지역 전체의 대각선 길이에 이르는 공간적 범위를 다루기 위하여, 각 앵커 포인트에 다양한 대역폭ϑ값을 동시에 적용하여, 국지적 및 광역적 범위 모두에서 압밀 변동성을 포착할 수 있는 다중 스케일 공간 특징 세트(multi-scale spatial feature set)를 생성하였다. 앵커 포인트의 수 M은 Bayesian 최적화에서 조절 가능 변수로, M ∈ {10, 15, 20, 25, 30}범위로 처리하였다.
3.2 XGBoost 회귀 절차 및 최적화
XGBoost는 각 트리(tree)가 경사 하강 최적화(gradient descent optimization)를 통해 이전 트리의 잔차 오차를 수정하는 순차적인 의사결정 트리(sequential decision trees)의 가산 앙상블(additive ensemble)를 구축하여 예측값을 결정한다(Chen and Guestrin, 2016). 트리 복잡도 및 리프(leaf) 가중치 크기를 페널티로 부과하는 정규화 항이 목적 함수에 직접 통합되어 있어, XGBoost는 적당한 규모의 표본 크기와 복잡한 특성 상호작용을 보이는 지반공학 매개변수 자료에 매우 적합한 것으로 알려져 있다. XGBoost hyperparameter와 공간 인코딩 parameter를 동일한 최적화 과정 내에서 결합하여, Tree-structured Parzen Estimator sampler를 사용하는 Optuna 기반 Bayesian hyperparameter 최적화(Akiba et al., 2019; Bergstra et al., 2011)를 각 fold당 100회씩 수행하였다. Table 2는 XGBoost의 하이퍼파라미터 조정을 위해 정의된 검색 범위를 보여준다. 각 fold 내에서 독립적으로 최적화를 수행함으로써, 훈련 과정 내내 hyperparameter 선택이 테스트 set에 영향을 받지 않도록 하였다.
Table 2.
Optuna search ranges for XGBoost hyperparameters
3.3 모델 훈련(model training) 및 평가(evaluation)
10-fold 교차 검증(10 fold CV) 방법을 훈련 set에 적용하였다. 각 fold 마다 모델은 자료의 90%로 학습하고 나머지 10%를 이용하여 검증하였으며, 각 fold 내에서 독립적으로 Bayesian hyperparameter 최적화가 수행되었다. 모델의 선택은 교차 검증 중 가장 낮은 제곱근 오차(root mean square error, RMSE) 기준을 따랐으며, 선택된 모델은 모든 훈련 및 최적화 과정 내내 완전히 독립적인 테스트 set에서 평가되었다(Cawley and Talbot, 2010). 예측 성능은 평균 제곱근 오차(RMSE), 평균 절대 오차(MAE), 평균 절대 백분율 오차(MAPE) 및 결정 계수(R2)를 사용하여 정량화 하였다.
3.4 공간 자기 상관 해석(spatial autocorrelation interpretation)
각 공간 인코딩 기법이 자료에 존재하는 공간 구조를 적절하게 반영하였는지를 평가하기 위하여 교차검증(CV) out-of-fold 잔차를 기반으로 계산된 Moran’s I를 이용하여 잔차 공간 자기상관성을 평가하였다(Gedamu et al., 2024). Moran’s I 값은 인접한 관측치들이 얼마나 유사한 잔차 값을 공유하는지를 정량화하며, 양수 (+)값은 공간적 군집이 남아 있음을 의미하며, 0에 가깝거나 음수 (-)인 값은 위치에 따른 분산이 인코딩에 의해 적절하게 반영되었음을 나타낸다. 공간 가중치 행렬은 2.3절의 입력 특징에 적용된 동일한 거리 범위 방식을 따라, 자료 set의 공간 구조에서 도출된 거리 범위 임계값을 사용하여 구성하였다. 따라서, 성능이 우수한 공간 인코딩은 원시 좌표(raw coordinates )만으로는 설명하기 어려운 위치 의존적 분산을 점진적으로 잘 포착하기 때문에, 기준이 되는 COOR 인코딩과 비교하여 잔차의 Moran’s I 값을 0에 가깝게 감소시킬 것으로 예상된다.
3.5 특징 중요도 분석
각 인코딩 기법의 최적 모델에 대하여 SHAP 값을 계산하였다. 계산된 SHAP 값을 바탕으로 개별 입력 특성의 기여도는 전체 절대 SHAP 값 중 각 특성 그룹이 차지하는 비율로 정량화하여, 지반 특성과 공간 인코딩이 기여하는 바를 다섯 가지 인코딩 기법에 대하여 직접 비교할 수 있게 하였다(Lundberg and Lee, 2017). 일관된 교차 인코딩(cross-encoding) 비교가 가능하게 하기 위하여, 지반 특성 입력 변수들로부터 공통된 공간적 기여도만을 분리하여 각 모델의 공간 인코딩 특징들을 하나의 그룹으로 통합하였다. 따라서 공간 그룹에 기여한 비율이 높다는 것은 해당 인코딩이 모델의 예측에 위치 의존적 정보를 효과적으로 제공한 것을 의미한다.
4. 결과 및 토의
4.1 최적의 공간 인코딩 매개변수
Optuna를 통한 Bayesian 최적화(Bayesian optimization)는 각 교차 검증 fold 내에서 XGBoost hyperparameter와 함께 최적의 공간 인코딩 매개변수를 선택했으며, 얻어진 매개변수 값은 Table 3에 요약하였다. 본 연구에서는 공간 인코딩 구성을 고정된 설계 선택 방법으로 취급하기보다는, 공간 인코딩 매개 변수를 조정 가능한 변수로 취급하여, 최적화 과정을 통해 송도 지역 자료를 바탕으로 송도 지역의 압밀 침하 예측에 가장 유용한 공간 구조를 도출하도록 하였다(Akiba et al., 2019; Bergstra et al., 2011). Table 4는 Optuna가 각 공간 인코딩 방법에 대해 선정한 최적의 XGBoost 하이퍼파라미터를 보여준다. Tables 3과 Table 4를 함께 검토하면, 침하 예측 성능을 향상시키기 위하여 어떻게 최적화 과정이 공간 표현과 예측 모델 구성을 조정하였는지 파악할 수 있다.
Table 3.
Spatial encoding parameters: tested ranges and optimal values
Table 4.
Optimal XGBoost hyperparameters for each spatial encoding
EDNP의 최적 이웃 수 K = 20으로 분석되었는데 이것을 실제 시추공 네트워크를 기준으로 약 287 m의 평균 이웃 반경에 해당한다. 이러한 결과는 입력 변수의 Moran’s I 값이 1 km 이내에서 가장 빠르게 감소하는 단거리 공간 자기상관 구조와 일치하는 결과이다(Fig. 3). 이러한 거리는 유사한 지질학적 기원을 가진 연약 매립 해성 점토층에 대해 보고된 수평 공간 상관 길이와 일치하며(Wang et al., 2025), 이는 최적화 결과가 임의의 자료를 기반으로 산출된 결과가 아니라 물리적으로 의미 있는 인근 영역을 식별해 냈음을 의미한다. 또한, 약 300 m정도 규모의 구역은 공간 샘플링 네트워크의 밀도에 민감한 절충안으로, 지반공학적으로 이질적인 구역의 시추공이 포함될 위험성을 방지하면서 동시에 국부적인 지반의 연속성을 유지하게 해준다(Biau and Devroye, 2015). BUFF의 경우, 최적화는 K = 12 기준점이 최대 경계 범위로 분석되었는데, 이는 연구 대상 지역의 불규칙한 경계면 형상을 고려할 때, 조밀한 경계 샘플링이 시추공 밀도가 희박한 모서리 지역만으로 구성된 희소한 정보 표현보다 더 풍부한 전체적인 공간 정보를 제공한다는 것을 의미한다. 비선형 공간 좌표 상호작용을 잘 반영하면서도 차수가 더 높은 고차 다항식 확장이 유발되기 쉬운 다중공선성(multicollinearity)을 방지하는 것 사이의 균형을 잘 반영하여, POLY 기법은 3차 다항식(n = 3)이 최적인 것으로 나타났다(Ohmer et al., 2025). RBF의 경우, 앞서 언급한 것과 같이 시추공 주변의 인접 반경부터 연구 대상 지역의 전체 대각선 길이에 이르는 공간적 범위를 포괄하는 다양한 대역폭 값에 걸쳐 15개의 앵커 포인트(M)를 사용할 때 최적의 성능을 보이는 것으로 나타났다. 이러한 RBF의 다중 스케일 설계는 EDNP와 유사한 성능을 보였는데, 이는 다중 공간 스케일 경향을 보이는 압밀 변동성을 동시에 포착하는 것이 이웃 간 거리를 통해 국부적인 인접 패턴을 계산하는 것만큼 효과적이라는 것을 의미한다.
4.2 교차 검증 일반화
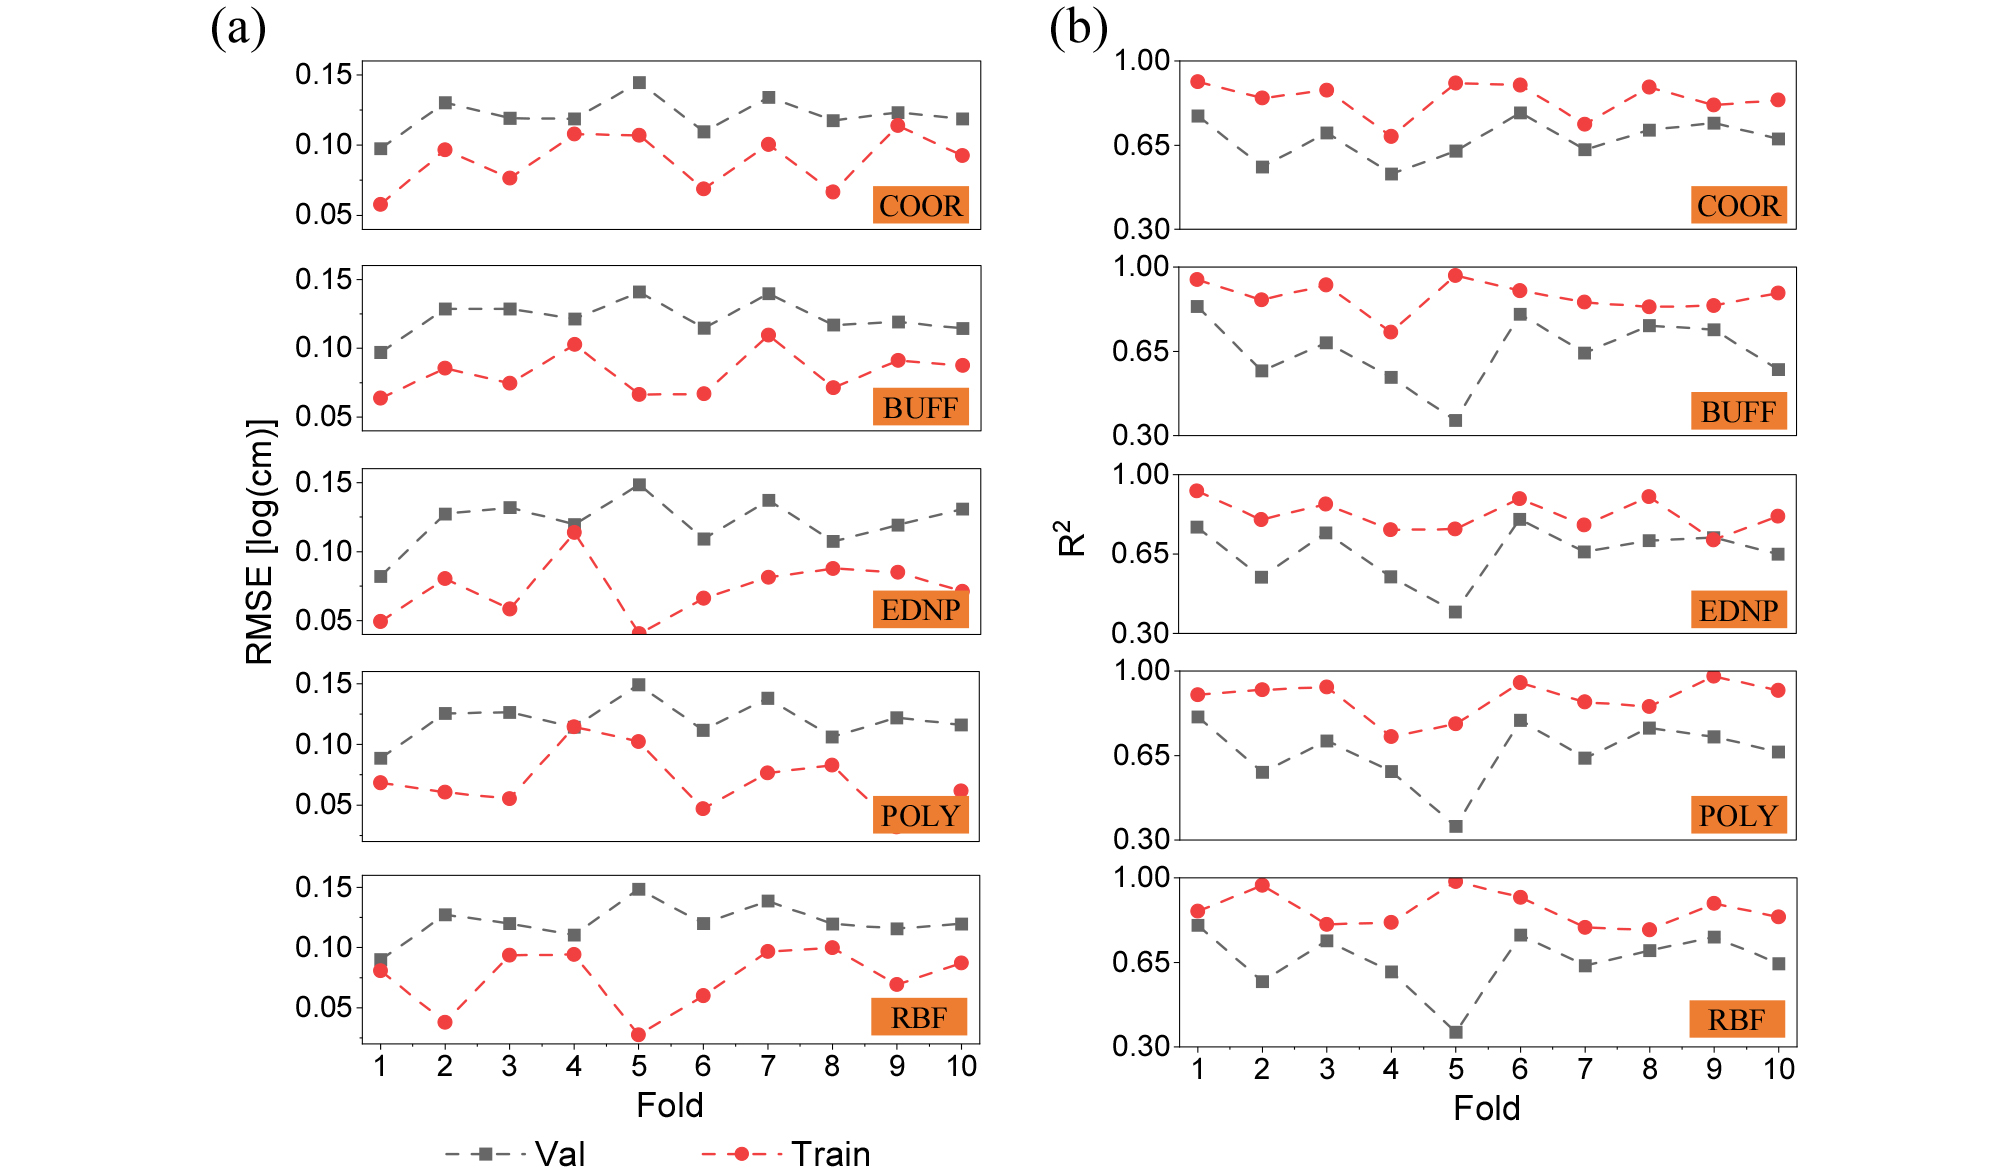
Fig. 5는 각 인코딩별 훈련 및 검증 시의 RMSE 및 R2 값을 보여준다. 훈련 시 R2값은 0.823(COOR)에서 0.883(POLY)까지 범위를 보였으며, 교차 검증 평균 R2값은 0.652(EDNP)에서 0.673(BUFF)까지 범위를 보였다. 모든 인코딩 기법에서 일관된 훈련-검증 격차(training-to-validation gap)가 관찰되었는데, 이는 모델이 과적합(overfitting)되었다는 것을 의미하기보다는, 훈련 과정에서 보지 못한 새로운 공간적 위치를 예측할 때 나타나는 일반적이고 자연스러운 성능 저하로 판단된다. 기존의 연구에서도, 본질적으로 공간적 변동성을 가진 지반공학적 data set에 대해 유사한 정도의 훈련-검증 불일치를 보인 것으로 알려져 있다(Cawley and Talbot, 2010). 인접 시추공 간의 거리를 바탕으로 한 거리에서 파생된 근접성 기반 특성들은 국지적인 압밀 조건을 정확하게 반영하기 때문에, 교차 검증 과정에서 이러한 인접 자료들을 제외하게 되면, fold 전반에 걸쳐 전체적인 공간 구조가 변화하지 않고 계속 유지되는 전역 좌표 변환(global coordinate transformation)을 제거할 때보다 예측 능력이 자연스럽게 더 크게 감소되기 때문에 EDNP의 경우 이 격차가 상대적으로 가장 큰데, 이러한 현상은 지반공학적으로 타당한 현상이다. 특히, 그림에는 도시하지 않았지만 모든 인코딩 기법에서 교차 검증 및 테스트의 R2값은 0.02 이내로 거의 일치하였는데 이는 Bayesian-optimized 모델 선택 절차가 독립적인 data에도 안정적으로 일반화되는 결과를 제공해 주는 것을 의미한다(Cawley and Talbot, 2010). 네 가지 공간 인코딩 기법 모두 전반적으로 COOR보다 우수한 성능을 보여 인코딩 기법이 예측 정확도 향상에 유의미한 기여를 한다는 것을 보여주었다. BUFF의 경계 고정(boundary-anchored) 특성이 각 fold 내 부지 경계 근처에 위치한 시추공의 공간적 분포에 민감하기 때문에 교차 검증 시 각 fold 별로 상대적으로 큰 R2값의 변동성을 보이는 반면에 EDNP는 전체적으로 일관된 R2값과 가장 높은 교차 검증 중앙값(median) R2을 보였다. 실무적인 의미를 살펴보면, COOR과 비교하여 네 가지 인코딩 기법은 모두 상대적으로 우수한 성능을 보였으나 인코딩의 복잡성 자체가 더 나은 교차 검증 안정성을 보장하지는 않으며, 공간적 변동성이 큰 압밀 침하량 예측의 경우 과적합(overfitting)을 방지하기 위하여 전역 좌표 변환(global coordinate transformation) 보다 국부적인 근접성 인코딩 기법이 지반공학적으로 타당한 정규화(regularization)를 제공하는 것으로 판단된다.
4.3 테스트 세트에서의 예측 성능
Fig. 6은 5가지 인코딩 기법의 테스트 set의 성능을 보여준다. COOR는 R2 = 0.719, RMSE = 0.102 log cm, MAPE = 5.39%로 가장 낮은 성능을 보였으며, ± 0.1 [log(cm)] 허용 오차 범위를 벗어나는 결과를 다수 보였다. 이는 원시 좌표(raw coordinates)만으로는 연구 대상 부지의 압밀 변동성을 지배하는 단거리 공간 의존성을 적절하게 반영하지 못함을 의미한다. 공간적으로 불규칙한 지반공학적 특성을 가지는 점토층을 수학적 또는 해석적으로 매끄러운 곡면으로 강제 변환하는 원시 좌표(raw coordinates) 기반의 좌표 변환과 다르게 EDNP는 인접 시추공과의 근접성을 기반으로 국부적인 압밀 상태를 더 정확하게 인코딩하기 때문에 R2 = 0.776, RMSE = 0.091 log(cm), MAE = 0.072 log(cm), 및 MAPE = .64%로 전반적으로 가장 좋은 성능을 보였으며, 대부분의 예측값이 ±0.1 [log(cm)] 허용 오차 범위 내에서 1:1 기준선 주위에 밀집되어 있다. RBF와 POLY 기법은 각각 R2 = 0.767, 0.761 및 MAPE = 4.78%, 4.89%를, BUFF는 R2 = 0.748, MAPE = 4.91%를 보였다. 모든 인코딩 기법에서 압밀 침하량이 클 경우 약간 과소 예측하는 경향을 보이는데 이는 훈련 자료(training data set)에 큰 압밀 침하량을 보이는 시추공 자료가 상대적으로 부족하기 때문으로 판단된다. 따라서, 압밀층 두께가 두꺼운 구간의 경우 주의가 요구된다.
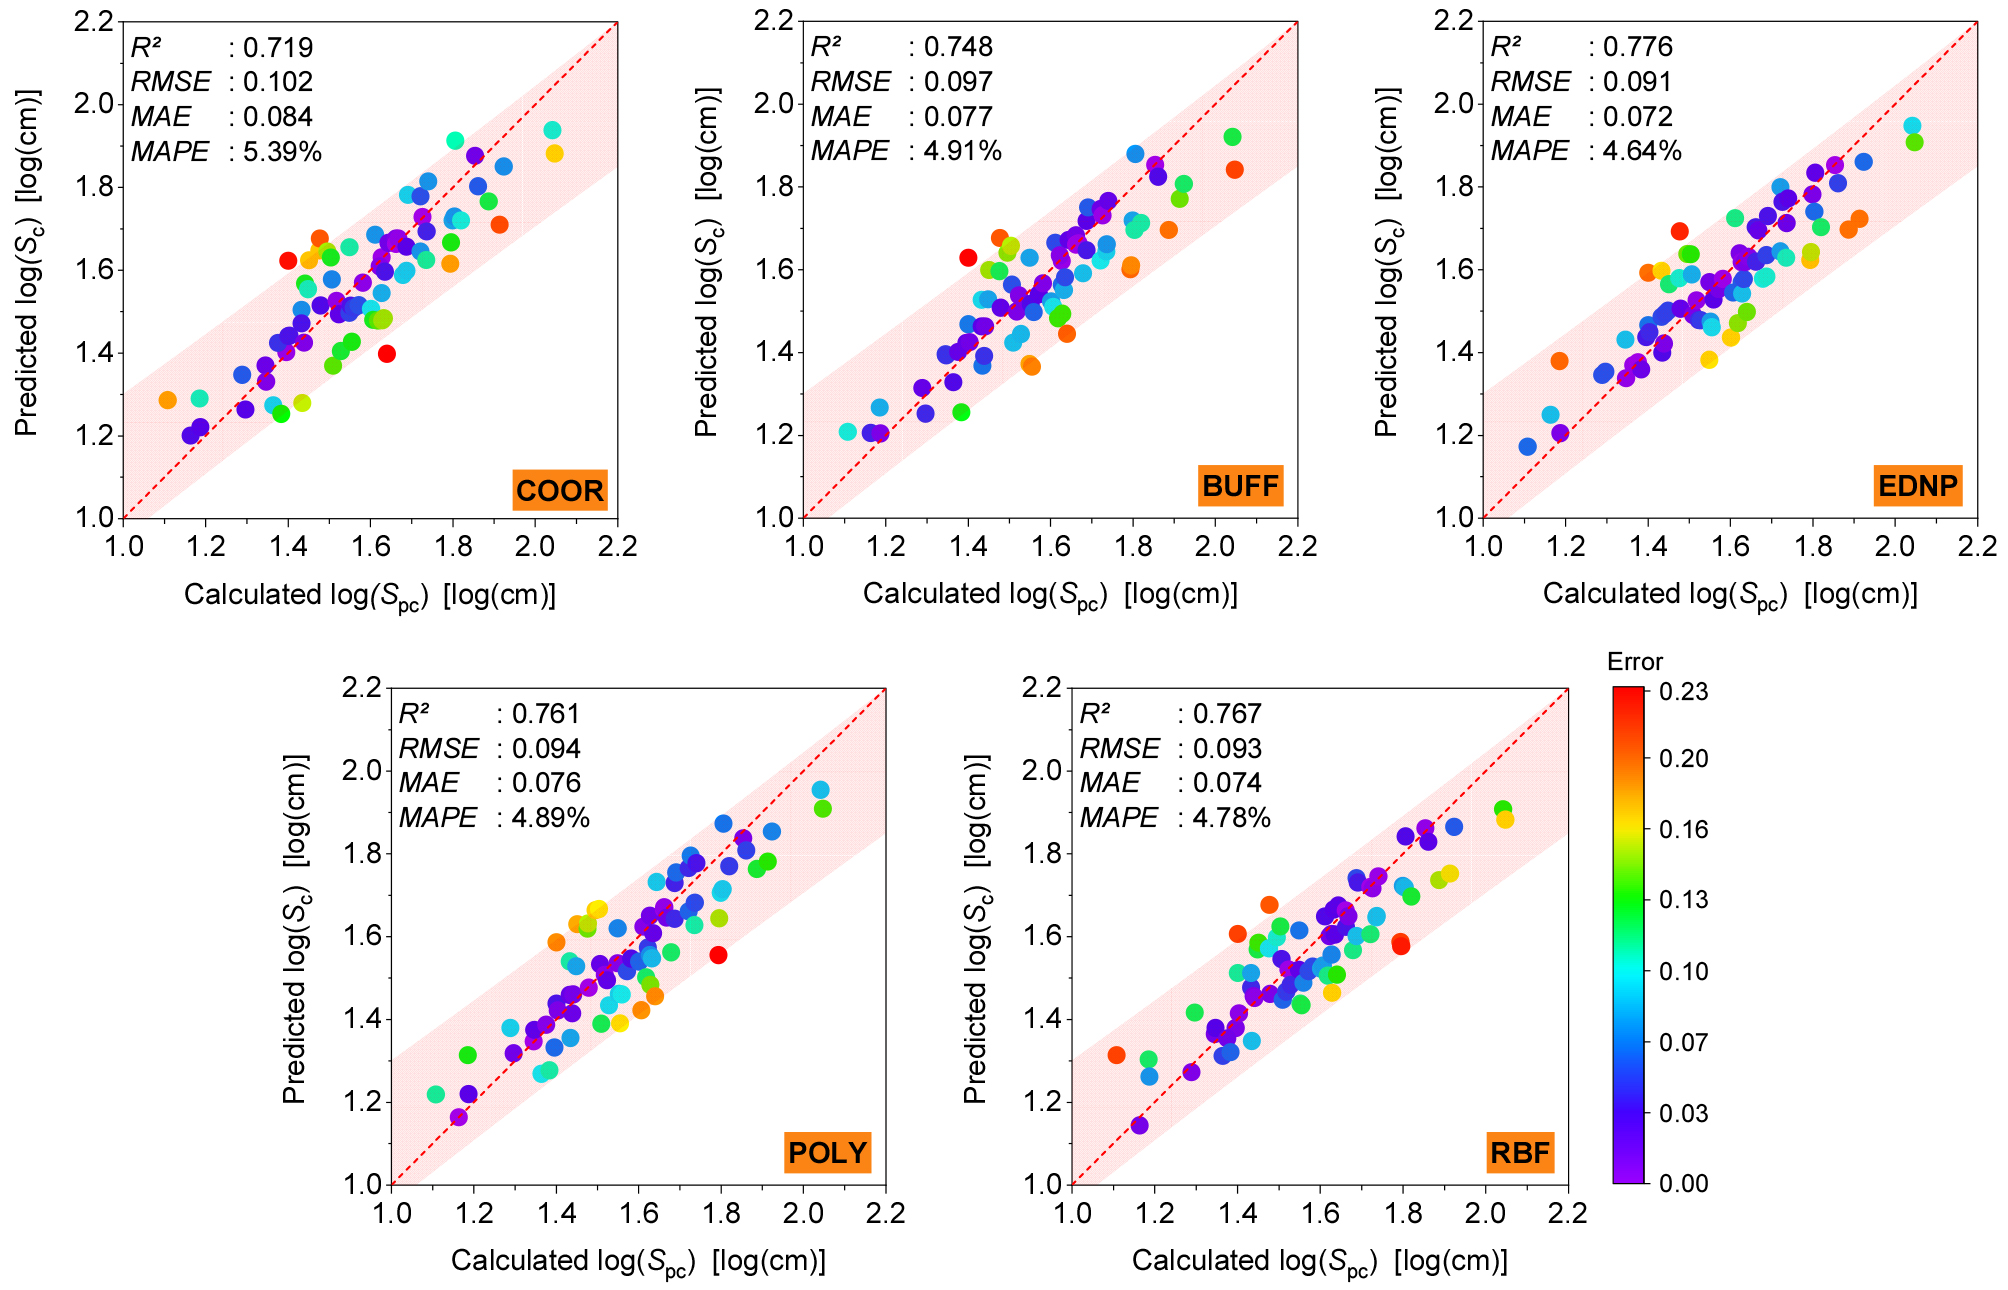
Fig. 7은 R2, RMSE, MAE, MAPE 지표를 바탕으로 5가지 공간 인코딩 기법의 성능을 방사형 차트(radar plot)를 이용하여 비교하여 보여준다. Fig. 7에 나타난 것과 같이, 원시 좌표(raw coordinates)를 직접 적용한 COOR 인코딩 방법이 모든 성능 지표의 하한값을 보여준다(Hengl et al., 2018). COOR 기법과 비교하여 공간 인코딩 기법을 활용한 것만으로 MAPE를 5.39%에서 4.64%로 낮추는 것으로 나타나, 특히 압밀 침하가 상부 구조물의 성능을 좌우하는 연약 점토 지반에서 예측 오차를 줄일 수 있어 공간 인코딩 기법의 적용은 실무적으로 의미 있는 결과로 판단된다(Kim et al., 2023; Liu and Pu, 2018).
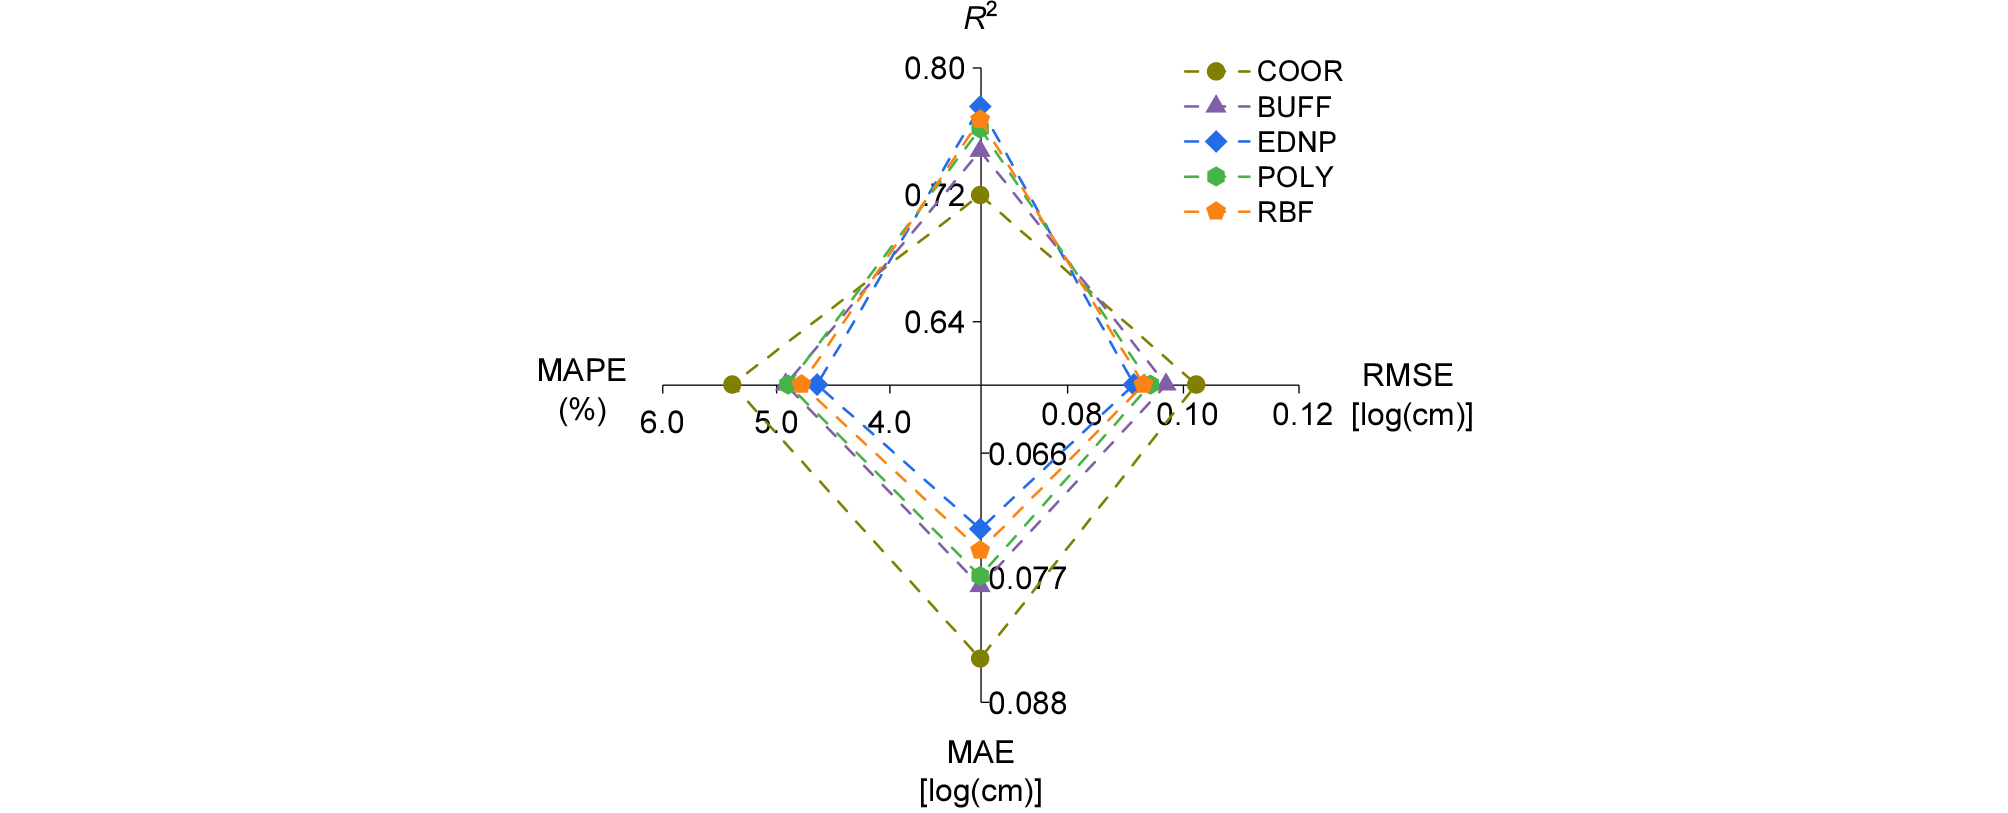
본 연구에서 획득한 최고의 예측 성능값인 EDNP의 R2 = 0.776을 증가시키려면 몇 가지를 고려해야 한다: 1) 베리오그램 기반의 조건부 시뮬레이션을 통한 Data 증강은 결과에서 확인된 침하량이 큰 시추공 자료의 부족 문제를 해결할 수 있지만, 원본 자료의 공간 자기상관성을 제대로 재현하지 못하는 합성 자료는 유용한 자료보다 오히려 자료의 노이즈를 유발할 위험이 있다; 2) 공간적 제약 조건이 아닌 깊이 경계의 POLY 최적값과 함께 Optuna를 통하여 이미 넓은 범위를 검토하였기 때문에 Hyperparameter 튜닝만으로는 예측 성능을 증가시키기는 어려울 것으로 판단된다. 따라서, 샘플링 network의 공간적인 밀도와 깊이가 침하 예측의 한계를 근본적으로 결정하기 때문에 시추공 자료의 증가가 예측 성능을 향상시키는데 여전히 가장 직접적인 해결책으로 판단된다. 이러한 시추공 자료의 증가는 본 논문에서 적용된 모든 공간 인코딩 및 알고리즘의 예측 성능 증가에 공통적으로 적용될 것으로 판단된다.
4.4 잔차 분포 분석
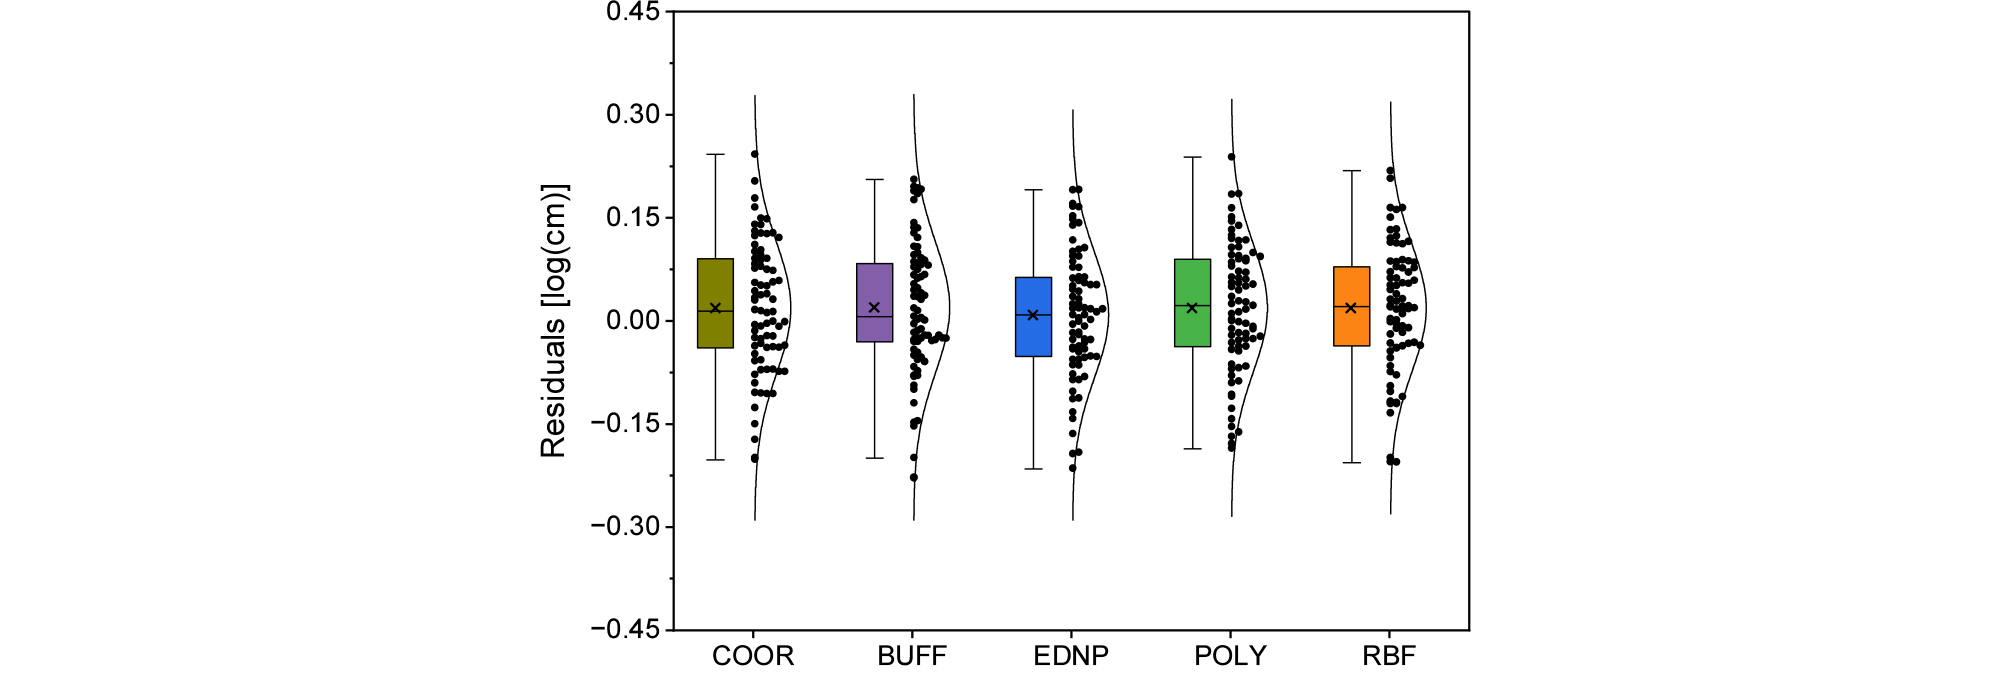
Fig. 8은 5가지 인코딩 기법의 잔차 분포를 보여준다. 모든 인코딩 기법이 ±0.01 이내의 평균 잔차(mean residual) 값을 보여, 모든 인코딩 기법이 체계적인 편향 (systematic bias)를 유발하지 않음을 보여준다. 그러나, 잔차의 분포는 각 인코딩 기법별로 분포와 형태 면에서 확연한 차이를 보인다. EDNP는 공간적으로 다양한 테스트 위치에서 안정적이고 일관된 오류 거동을 반영하여, 가장 좁은 사분위수 범위(interquartile range)와 대칭적인 분포를 보였다. 이러한 EDNP 성능은 시추공 네트워크의 공간 밀도에 맞추어 유연하게 반응하는 로컬 인코딩(local encoding) 방법을 적용하기 때문으로 판단된다. 반면, COOR은 가장 넓은 사분위수 분포와 상대적으로 두꺼운 꼬리 분포(heavy-tailed distribution)를 보여, COOR은 평균에서 멀리 떨어진 값이나 이상치가 발생할 확률이 높을 가능성이 있다. 이러한 넓은 분포는 원시 좌표(raw coordinates)가 공간적으로 일관성 없는 오차를 발생시켜 공간 예측의 일관성이 부족함을 의미한다(Hengl et al., 2018; Meyer and Pebesma, 2022). BUFF는 다른 공간 인코딩에 비해 약간의 음의 왜곡 또는 편향(negative skew)과 약간 비대칭적으로 상대적으로 두꺼운 하단(i.e., 분포의 아래쪽) 꼬리를 보인다. 이는 경계 거리 특징이 공간적 변별력을 충분히 제공하지 못하는 부지 내부 인근의 저 침하량 지역에서 간헐적인 과대평가가 경향과 일치한다. RBF와 POLY는 대칭성과 분포 측면에서 EDNP와 유사한 분포를 보였으며, 세 가지 인코딩 기법은 구조적인 차이에도 불구하고 실무적인 측면에서 볼 때 거의 구분 없이 상호 교환하여 사용이 가능하다는 4.3의 결과를 뒷받침한다. 잔차 분포를 통한 각 인코딩 기법 비교 결과, EDNP가 중 가장 공간적으로 균일한 예측 오차를 제공하며, 인코딩의 형태에 관계없이 모든 구조화된 공간 인코딩은 원시 좌표 입력보다 훨씬 더 일관된 오차를 생성하는 것으로 분석되었다. 이러한 잔차 분포 분석 결과가 중요한 이유는 RMSE 및 R2 와 같은 점(point) 단위의 평가 지표만으로는 지반공학적으로 다양한 영역에서 부지 전반의 침하 지도를 작성하는 데 매우 중요한 공간적 특성을 파악할 수 없기 때문이다.
4.5 잔차 공간 자기상관
Fig. 9는 교차 검증 잔차에서 계산된 잔차를 이용하여 최대 4 km 거리 구간까지 계산한 Moran’s I와 기준이 되는 log(Spc)의 공간 자기상관성을 함께 보여준다. Tobler(1970)의 이론에 따르면, 인접한 관측치들은 인접할수록 유사한 값을 공유하는 경향이 있는 것으로 알려져 있으며, 이 원리는 모델이 공간적 구조를 충분히 반영하지 못하였을 경우 예측 잔차에도 동일하게 적용된다. 목표 변수인 log(Spc)는 모든 거리 구간에 걸쳐 양(+)의 공간 자기상관을 유지하며, 가장 짧은 구간(~0.05 km)에서 Moran’s I는 0.183을 가지며 4 km 거리에서 0.056으로 감소하는데, 이는 공간 인코딩이 없는 모델이 잔차 군집화(residual clustering) 형태로 공간 구조를 체계적으로 계속 계승하는 것을 의미한다.
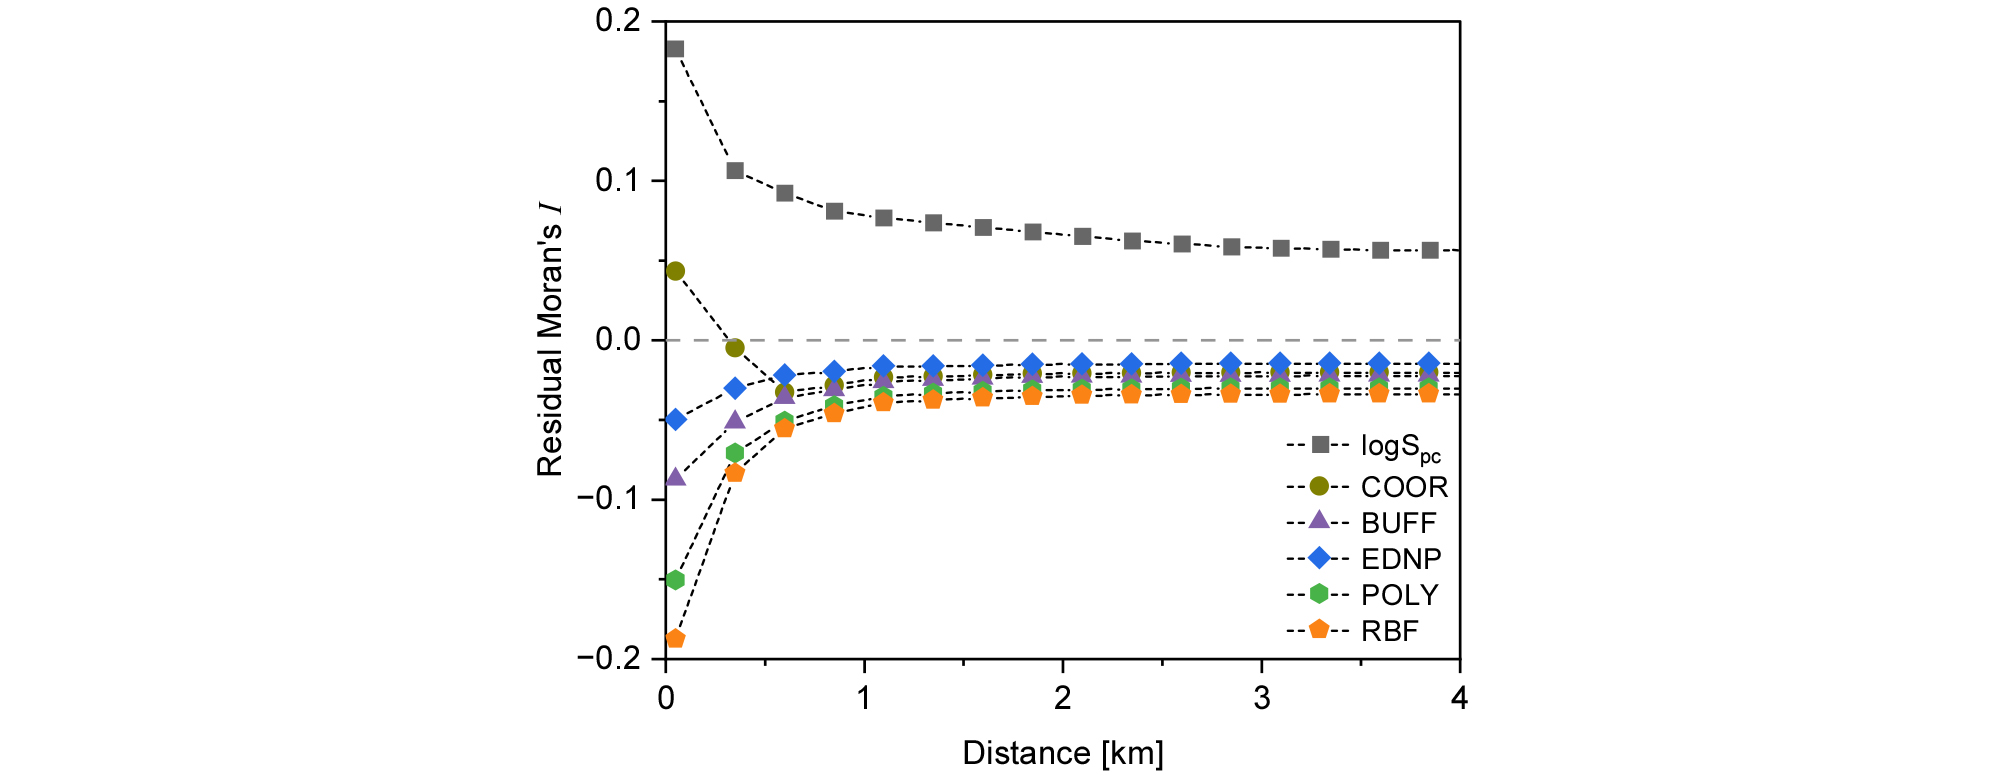
COOR은 최단 거리 대역(~0.05 km)에서 0.043 Moran’s I 값을 생성하였으며, 2 km를 넘어서는 거의 0에 가깝게 감소하여 약 -0.02로 안정화되었다. 이는 원시 좌표(raw coordinates)가 침하 자료에 존재하는 위치 의존적 분산을 완전히 포착하지 못한다는 것을 나타낸다. 반면, 네 가지 공간 인코딩 기법은 모두 전체 거리 구간에 걸쳐 잔차 Moran’s I 값이 0 미만으로 억제하여, 각 인코딩 기법이 COOR이 설명하지 못하는 공간 구조를 성공적으로 흡수했음을 보여준다. 이러한 차이는 4.3과 4.4에서 나타난 것과 같이, COOR보다 공간 인코딩이 우수한 성능을 보이는 이유가 단순한 무작위적 변동이 아니라, 구조화된 공간 오차가 실질적으로 감소했음을 보여주는 직접적인 증거이다(Lui et al., 2022; Kim et al., 2023).
네 가지 공간 인코딩 기법 중에서 EDNP가 최소 구간 거리(~0.05 km)에서 0에 가장 가까운 잔차 Moran’s I(−0.050)를 보였으며, 이어서 BUFF(−0.088), POLY(−0.151), RBF(−0.188) 순으로, 모두 1 km 이상에서 빠르게 안정화되어 4 km에서 −0.015에서 −0.040 사이의 값을 보였다. 이러한 작은 음수 값의 Moran’s I는 군집보다는 약간의 공간적 분산(spatial dispersion)을 나타내는데, 이는 공간적 특성이 예측과정에서 국소적인 smoothing을 가할 때 예상되는 결과이다(Gedamu et al., 2024). EDNP는 모든 인코딩 기법 중에서 가장 균형 잡힌 공간 오차 구조를 보여주며, 과도한 smoothing 및 잔차 군집도 남기지 않는 것으로 나타났다. 이러한 ENDP 공간 오차 거동의 일관성은 다른 모든 평가 기준에서 우수한 성능을 보인 것과 일치한다. 또한, POLY와 RBF는 가장 짧은 거리 구간(~0.05 km)에서 가장 큰 음의 Moran’s I 값을 보이는데, 이는 인접한 거리에서는 공간 구조를 약간 과보정 되는 것을 의미하나, 1 km 이상의 거리에서는 이러한 효과가 사라지는 것으로 나타났다. 종합적으로, 잔차 자기 상관 분석은 네 가지 공간 인코딩 기법 모두 모델 잔차에서 목표 변수의 공간 구조를 성공적으로 제거했음을 보여주었다.
4.6 SHAP를 이용한 특징 중요도
예측 특성을 파악하고 어떤 입력 변수가 압밀 침하량 추정치를 일관되게 좌우하는지를 파악하기 위하여 모든 다섯 가지 인코딩 기법에 대하여 SHAP 분석을 실시하였다. Fig. 10은 지반 매개 변수와 공간적 특징을 구분하여 인코딩 기법별로 그룹화된 상대적 SHAP 중요도를 보여준다. Fig. 10과 같이, 지반 매개변수는 모든 구성에서 모델 결과에 가장 큰 영향력을 미친다. H0는 모든 인코딩에서 가장 높은 상대적 중요도를 보여주며, 26.90%(RBF)에서 32.22%(BUFF) 범위를 보였다. 이어서 σ'ᵥ가 높으며 EDNP의 22.26%에서 COOR의 27.63%까지 범위를 보였다. H0는 압밀이 일어나는 압축성 재료의 총 부피를 지배하며, 유효 상재 하중은 선행압밀상태(preconsolidation state)를 결정하고 적용된 응력 증가분에 대하여 지반이 얼마나 침하하는지를 제어한다(Terzaghi, 1943). Δσ'ᵥ는 변수 중에서 세 번째로 중요한 것으로 나타났는데, RBF의 13.80%에서 COOR의 17.61%까지 범위를 보였다. 압축 특성에 간접적인 영향을 미치는 보조 매개 변수인 e0, ωn, LL는 상대적으로 낮은 중요도를 보이지만 안정적인 수준으로 압밀 침하량 추정치에 영향을 미치는 것으로 분석되었다.
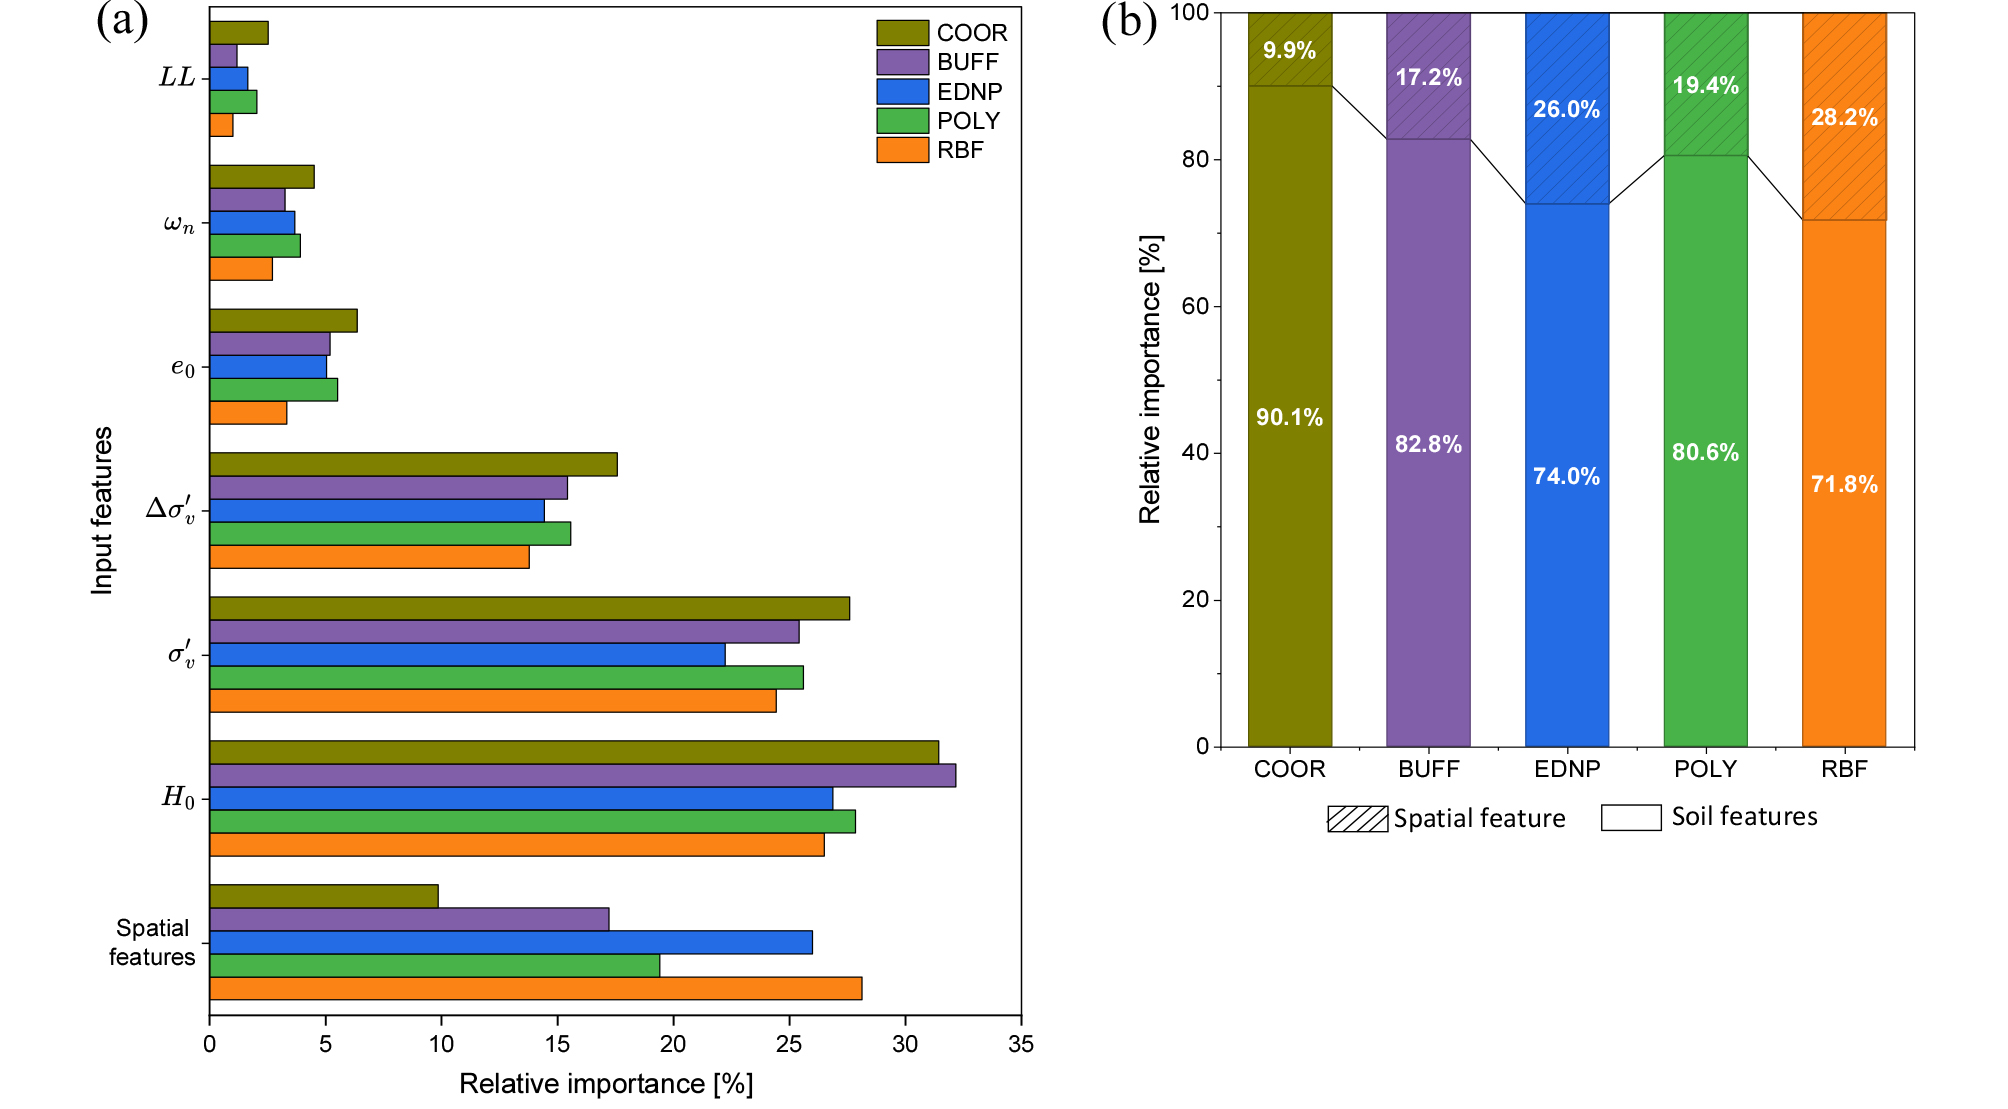
공간적 특성 중요도는 인코딩 기법에 따라 유의미하게 달라진다. RBF와 EDNP는 각각 28.16%와 26.03%로 높은 공간적 기여도를 보이는 반면, COOR은 9.87%로 가장 낮은 기여도를 보였다. 원시 좌표(raw coordinates)는 단지 일차원적인 축 정보만을 제공하므로 다양한 지반 특성이 혼재된 매립지 전체를 파악하기에는 공간 해상도가 떨어진다. 반면에 EDNP와 RBF는 각각 근접성 기반 거리와 smooth spatial kernels을 활용하여 더 세밀한 공간 패턴을 파악하여, 원시 좌표(raw coordinates)로는 표현할 수 없는 위치 의존적 정보를 추출한다(Behrens et al., 2018). BUFF와 POLY는 각각 17.25% 및 19.43%로 중간 위치를 차지했는데, 이는 4.2에서 나타난 중간 정도의 예측 성능과 일치하는 결과이다. 공간적 특징이 가장 유용한 정보를 제공하는 경우에도, EDNP 및 RBF 구성에서 지반 매개변수는 전체 모델 결과의 약 72% ~ 74%를 차지하여 인코딩 기법과 관계없이 압밀에 관계되는 물리적 변수가 여전히 전체 결과를 지배하는 것을 확인하였다. 따라서, 공간 인코딩 기법은 물리적 변수를 대체하는 것이 아니라 보완하는 역할을 하며, 모든 다섯 가지 기법에서 지반 변수들의 SHAP 상대 중요성 순위가 일관되게 나타난다는 것은 XGBoost 절차가 인코딩 기법과 관계없이 압밀 과정의 물리적으로 유의미한 표현을 학습한다는 것을 의미한다. 이러한 물리적 일관성은 지반공학분야에서 데이터 기반 침하 모델(data-driven settlement model)을 실무에 도입하기 위한 필수 선행 조건으로, 모델의 예측 결과는 해석 가능해야 하며 토질역학적 원리에 부합해야 한다(Gajan and Kantor, 2025; Lundberg and Lee, 2017).
5. 결 론
본 연구는 대한민국 인천 송도 신도시를 대상으로, 376개의 시추공 자료를 활용하여 XGBoost 기반의 압밀 침하 예측을 위하여 raw coordinates(COOR), Euclidean distance to neighboring points(EDNP), buffer boundary distances(BUFF), polynomial coordinate features(POLY), and radial basis functions(RBF)의 다섯 가지 공간 인코딩 기법을 평가한 연구이다. 인코딩 매개 변수는 Bayesian 최적화를 통해 XGBoost hyperparameter와 함께 최적화되었다. 또한, 10-fold 교차 검증, 독립 test-set 지표, Moran’s I 잔차 자기상관 분석 및 SHAP 기반 특징 중요도 분석을 통해 각 인코딩 매개 변수를 평가하였다.
네 가지 공간 인코딩 기법은 모든 평가 기준에서 COOR보다 일관되게 우수한 성능을 보였다. EDNP는 R2 = 0.776, MAPE = 4.64%로 가장 우수한 성능 지표를 보였으며, RBF, POLY 및 BUFF는 각각 MAPE = 4.78%, 4.89% 및 4.91%로 유사한 결과를 보였다. COOR은 R2 = 0.719, MAPE = 5.39%을 보였다. COOR과 다른 네 가지 공간 인코딩 간의 성능 격차는 각 인코딩 기법의 기하학적 형태의 차이보다 큰 격차를 보였다. 이는 특정 인코딩 방식을 선택/적용하는 것보다 공간 인코딩 적용 자체가 원시 좌표(raw coordinates)를 이용하는 것보다 더 큰 성능 향상이 있다는 것을 의미한다. 잔차 Moran’s I 분석은 이러한 결과를 뒷받침하는데, COOR은 모든 거리 대역에 걸쳐 지속적으로 양의 잔차 자기상관을 보인 반면, 네 가지 공간 인코딩 기법은 모든 거리 대역에서 잔차 자기상관을 0 미만으로 억제하였다. 이는 대상 부지의 압밀 변동성을 지배하는 단거리 공간 의존성(short-rage spatial dependency)을 완전히 해결하기 위해서는 구조화된 공간 변환이 필요하다는 것을 의미한다. SHAP 분석 결과, 모든 인코딩 기법에서 지반 매개 변수가 예측에 가장 큰 영향을 미치는 것으로 나타났으며, H0, σ'ᵥ 및 Δσ'ᵥ가 가장 중요한 세 가지 지반 변수로 나타났다. 반면에 공간적 특성의 기여도는 COOR의 9.9%부터 RBF의 28.2%의 범위로 나타났는데, 이는 공간 인코딩이 물리적 압밀 요인을 대체하기보다는 오히려 보완한다는 것을 의미한다.
네 가지 인코딩 기법 모두에서 약 300m ~ 400m의 공간적 규모에서 최적 인코딩 매개변수가 수렴하는 결과는 송도 지역 지반공학적 매개변수의 단거리 자기상관 구조를 보여준다. 향후 연구에서는 이러한 인코딩 기법이 지질학적 이질성(geological heterogeneity)과 시추공 자료가 부족한 지역에서의 적용가능성을 검토하고, 여러 공간 인코딩 기법을 결합한 앙상블 접근 방식이 부지 전체의 침하 지도 작성 예측 정확도를 더욱 향상시킬 수 있는지 등의 파악이 필요할 것으로 판단된다.