

1. 서 론
2. 데이터 구축 및 피처 엔지니어링
3. 방법론
3.1 입력 구조 및 모델 구성
3.2 유형 정의 및 해석 지표
4. 결과 및 분석
4.1 분류 성능 비교
4.2 유형별 출력 구조
4.3 유형별 지반공학적 해석
5. 결 론
Notation
1. 서 론
표준관입시험(Standard Penetration Test, SPT)은 시험 수행의 간편성과 경제성으로 인해 현장 지반조사에서 널리 활용되는 시험이다. SPT를 통해 획득되는 N값은 지반의 상대밀도, 강도, 변형 특성(Das and Sivakugan, 2017; Hatanaka and Uchida, 1996; Murthy, 2002) 및 전단파 속도 추정을 통한 동적 특성(Hasancebi and Ulusay, 2007; Ohta and Goto, 1978)을 간접적으로 평가하는 핵심 지표로 활용되며, 국내의 경우 대규모의 SPT 데이터가 국토지반정보포털을 통해 관리되고 있다. 그러나 SPT N값은 시험 절차, 장비 조건, 에너지 전달 효율 및 현장 수행 조건의 차이에 영향을 받으며(Skempton, 1986), 시추주상도 작성 및 데이터 입력·관리 과정에서 발생할 수 있는 기록 불확실성을 포함한 지반 자료 자체의 본질적 변동성을 내포하고 있다. 이러한 불확실성은 개별 시험 값의 신뢰도뿐 아니라 경험식 기반 지반정수 추정 및 공학적 의사결정 과정에 영향을 미친다(Phoon and Kulhawy, 1999; Christian, 2004). 따라서 대규모 SPT 데이터베이스에서는 물리적으로 불가능한 값의 제거를 넘어, SPT 반응과 현장에서 측정·관찰된 지반정보 간의 일관성이 낮은 구간을 체계적으로 검토할 필요가 있다.
일반적인 단변량 데이터 품질관리 및 전처리는 박스플롯 기반의 이상치 제거 또는 특정 확률 분포를 가정한 통계적 검정이 활용되며(Hodge and Austin, 2004), SPT 데이터의 전처리 과정에서도 이러한 방법들이 활용된 바 있다(Heo and Kwak, 2022). 다만, 박스플롯 기반의 방법은 데이터의 비대칭 분포에 대해 한계를 가지며(Hubert and Vandervieren, 2008), 통계적 검정 또한 데이터특성에 따라 적절한 확률 분포를 가정해야 하는 제약이 있다. 이때 SPT 자료는 단일 분포로 설명하기 어려운 지층별 분포 특성을 보이며, 단일 임계값을 일률적으로 적용할 경우 지층 경계부나 국부적 지반 변화와 같은 공학적으로 중요한 구간의 데이터까지 제거 대상으로 판단될 수 있다.
최근 이러한 한계점을 극복하기 위해 딥러닝 기반의 이상치 탐지 기법이 다양한 분야에서 제안되고 있다. 딥러닝 모델은 특정 모수 분포를 명시적으로 가정하는 통계적 방법에 비해, 비선형적이고 복잡한 관계를 유연하게 학습할 수 있다는 장점을 가진다(LeCun et al., 2015). Park et al.(2022)은 지반 조사 데이터의 품질관리를 위해 Fully Connected Neural Network(FCNN)을 활용한 바 있다. 하지만 FCNN의 경우 개별 데이터 포인트의 정적 특성에 기반하여 깊이에 따라 연속적으로 변화하는 지반의 구조적 특성을 반영하지 못하는 한계를 가진다. 또한 탐지된 구간에 대한 신뢰도를 평가하거나, 예측된 품질관리 대상 구간을 해석하는 연구는 제한적으로 수행되어 왔다.
제안된 방법론에서는 지층명을 실제 지반 상태의 절대적 라벨이 아니라 현장 조사 과정에서 확보 가능한 참조 라벨로 간주한다. 이때 딥러닝 모델은 대규모 자료에서 반복적으로 관찰되는 SPT 입력 특성과 참조 지층 라벨 간의 경험적 관계를 학습한다. 따라서 모델의 오분류 또는 높은 예측 불확실성은 해당 샘플이 모델이 학습한 일반적인 입력–라벨 관계로 충분히 설명되기 어려운 구간일 가능성을 시사한다(Bengio et al., 2013; Hüllermeier and Waegeman, 2021; Gawlikowski et al., 2023).
본 연구의 주요 기여는 다음과 같다. 첫째, 이산적인 데이터로 활용되던 SPT 자료를 심도 방향 시퀀스로 재구성하고, 이를 Long Short-Term Memory(LSTM) 기반 구조에 적용함으로써 심도 방향의 연속적 지반 특성을 반영할 수 있는 입력 체계를 구축하였다. 둘째, 지층 분류 대리 과제를 통해 SPT 입력자료와 지층 라벨 간의 일관성 저하 구간을 식별하는 불확실성 기반 품질관리 프레임워크를 제안하였다. 셋째, 정분류 및 오분류 여부와 예측 엔트로피를 결합한 유형화를 통해, 탐지된 품질관리 대상 구간을 단순 제거 대상이 아니라 전문가 검토 우선순위 관점에서 해석할 수 있음을 보였다.
2. 데이터 구축 및 피처 엔지니어링
본 연구에서는 국토지반정보포털에서 서울특별시 행정구역에 해당하는 시추정보, 지층정보 및 SPT 데이터를 수집하고, 고유 식별자를 기준으로 시추공 단위로 연계하였다. 시추정보와 지층 정보의 전처리는 중복 시추공, 지층 심도·두께 오류, 비표준 지층명 및 수정 USCS, SPT와 연계되지 않은 시추공·지층정보를 단계별로 제거하였다. SPT 데이터의 전처리는 KS F 2307 기준에 따라 30cm 관입 기준의 N값과 관입한계시 50회 타격 시의 관입량을 기준으로 정리하였으며, 물리적·형식적으로 부적절한 SPT 기록을 제거하였다. 이에 대한 세부 기준과 단계별 자료 수 변화는 Table 1에 제시하였다. 이 과정은 잠재적인 품질관리 대상 구간을 사전에 제거하기 위한 것이 아니라, 모델 입력자료의 최소한의 물리적·형식적 일관성을 확보하기 위해 수행되었다. 최종적으로 시추정보 19,981개소, 지층정보 57,492개 및 SPT 데이터 228,196개를 모델 학습과 평가에 활용하였다.
Table 1.
Data preprocessing criteria and changes in record counts by stage
이때 사용한 N값은 공공 데이터베이스에 기록된 원자료 기반 SPT 반응 지표이며, 에너지 효율, 유효 상재압, 장비 조건 등에 따른 별도 보정은 적용하지 않았다. 따라서 본 연구에서의 N값 해석은 보정 N값 기반의 설계정수 산정이나 절대적 지반강도 평가가 아니라, 동일 자료체계 내에서 SPT 반응과 지층 기록 간의 상대적 일관성을 검토하기 위한 목적으로 활용되었다. 원자료의 한국어 지층명은 총 10개 지층(매립토층, 퇴적토층, 붕적토층, 충적토층, 잔적토층, 풍화토층, 풍화암층, 연암층, 보통암층, 경암층)으로 구성되어 있으나, 이를 그대로 사용할 경우 유사한 물리적 특성을 갖는 지층이 과도하게 세분화되어 모델 학습과 결과 해석이 복잡해질 수 있다. 이에 본 연구에서는 지질학적 유사성과 SPT 반응 특성을 고려하여 지층을 4개의 지층군으로 재분류하였다.
기존의 지층 분류 기준과 더불어 암반을 포함한 수정 USCS는 서울특별시 지반조사편람(2006)의 현장 관찰에 따른 분류를 참고하여 4가지의 이질적 특성을 가지는 지층으로 분류하였다. 매립토층은 인공적으로 형성된 이질성을 고려하여 매립층(Fill)으로 유지하였다. 퇴적토층, 충적토층 및 붕적토층은 퇴적층(Sediment)으로 통합하였고, 풍화토층과 잔적토층은 지질학적 운반작용이 일어나지 않음을 고려해 별도의 풍화층(Weathered Soil)으로 분류하였다. 또한 풍화암층, 연암층, 보통암층 및 경암층은 공통적으로 관입 한계를 나타낸다는 점을 고려하여 암반층(Rock)으로 통합하였다.
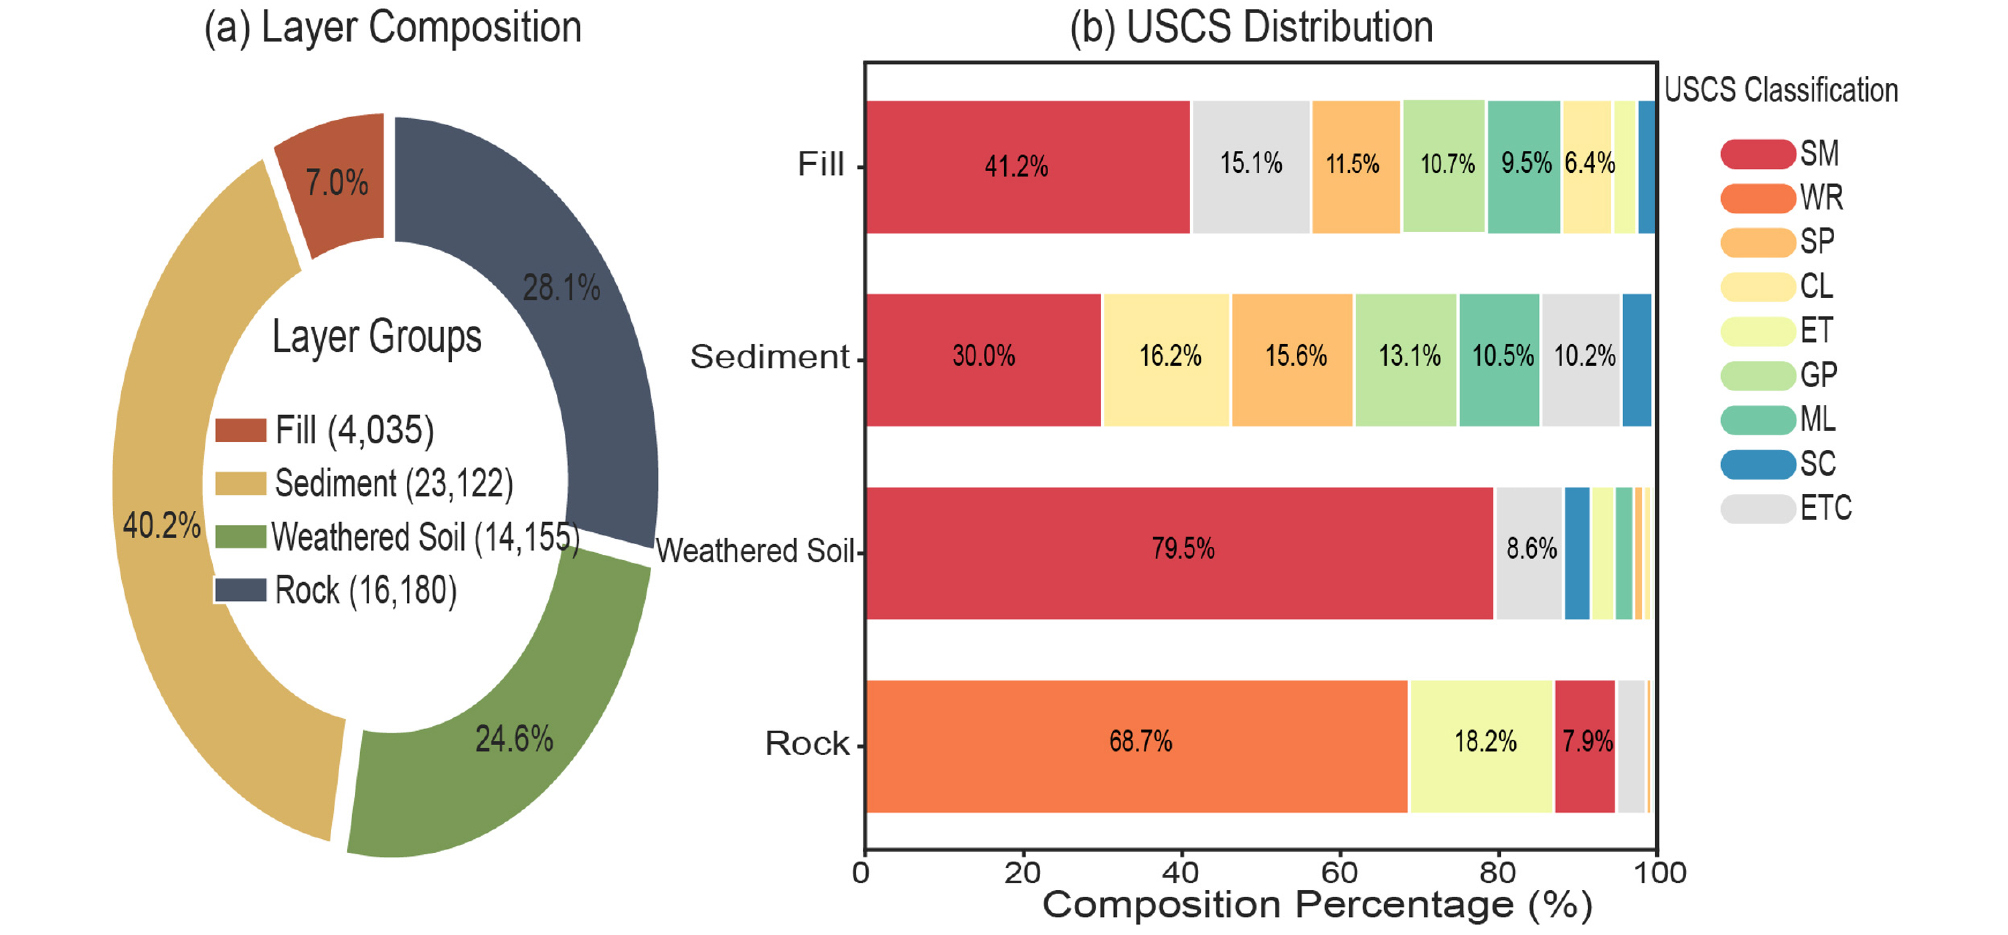
이와 같이 정의된 4개 지층군이 SPT 자료와 지층 기록 간 일관성 평가를 위한 참조 라벨로 활용될 수 있는지를 검토하기 위해, 지층군별 구성비와 수정 USCS 분포를 분석하였다. Fig. 1(a)에 따르면 전체 지층 자료 중 퇴적층은 23,122개로 40.2%를 차지하여 가장 큰 비율을 보였으며, 암반층은 16,180개로 28.1%, 풍화토층은 14,155개로 24.6%, 매립층은 4,035개로 7.0%를 차지하였다. 이는 지층군 간 자료 수의 불균형이 존재함을 의미하며, 이후 모델 학습에서 클래스 불균형을 고려할 필요가 있음을 보여준다.
Fig. 1(b)의 수정 USCS 분포에서도 지층군별 차이가 확인된다. 매립층은 SM이 가장 큰 비율을 차지하지만, SP, GP, ML, CL 및 기타 분류가 함께 나타나 재료 구성이 비교적 혼재된 양상을 보인다. 퇴적층 역시 SM을 중심으로 다양한 토질 분류가 함께 나타나며, 이는 퇴적 환경 및 운반 과정에 따른 토질 다양성을 반영한다. 반면 풍화토층은 SM 비율이 지배적으로 나타나 퇴적층 및 매립층에 비해 상대적으로 집중된 토질 구성을 보인다. 암반층은 WR이 가장 큰 비율을 차지하여 토사층과 구별되는 분포를 보인다. 이러한 결과는 4개 지층군이 완전히 독립적인 토질군으로 분리되는 것은 아니지만, 각 지층군이 서로 다른 수정 USCS 구성 특성을 가지며 참조 라벨로 활용 가능한 구분성을 갖는다는 점을 시사한다.
SPT 관입거동 측면에서도 지층군별 차이가 나타난다. Fig. 2(a)의 심도 분포를 보면 매립층은 상대적으로 얕은 심도에 집중되어 있으며, 퇴적층과 풍화토층은 그보다 깊은 구간까지 분포한다. 암반층은 네 지층군 중 가장 깊은 심도 범위를 보이며, 이는 일반적인 지층 발달 순서와 부합한다. 다만 각 지층군의 심도 분포에는 일부 중첩이 존재하므로, 심도 정보만으로 지층군을 명확히 구분하기는 어렵다.
Fig. 2(b)는 30 cm 관입이 완료된 SPT 자료를 대상으로 N값 분포를 비교한 결과이다. 매립층과 퇴적층은 상대적으로 낮은 N값 범위에 주로 분포하는 반면, 풍화토층과 암반층은 더 큰 N값 범위를 보인다. 특히 암반층은 중앙값과 사분위 범위가 전반적으로 높게 나타나 토사층에 비해 큰 관입저항을 보인다. 이는 N값이 지층군 간 관입저항 차이를 반영하는 주요 지표로 작용할 수 있음을 의미한다.
Fig. 2(c)는 N값이 50이고 30 cm 미만에서 관입이 종료된 관입 한계 자료를 대상으로 관입깊이 분포를 비교한 결과이다. 암반층은 다른 지층군에 비해 관입깊이가 작게 나타나며, 이는 동일한 50회 타격 조건에서 더 작은 관입량을 보이는 높은 관입저항 특성과 부합한다. 반면 퇴적층과 풍화토층은 암반층보다 상대적으로 큰 관입깊이 분포를 보이며, 매립층은 비교적 넓은 분산을 나타낸다. 따라서 단순 N값뿐 아니라 관입깊이와 단위 관입저항은 지층군별 SPT 반응 차이를 설명하는 데 중요한 보조 지표로 활용될 수 있다.
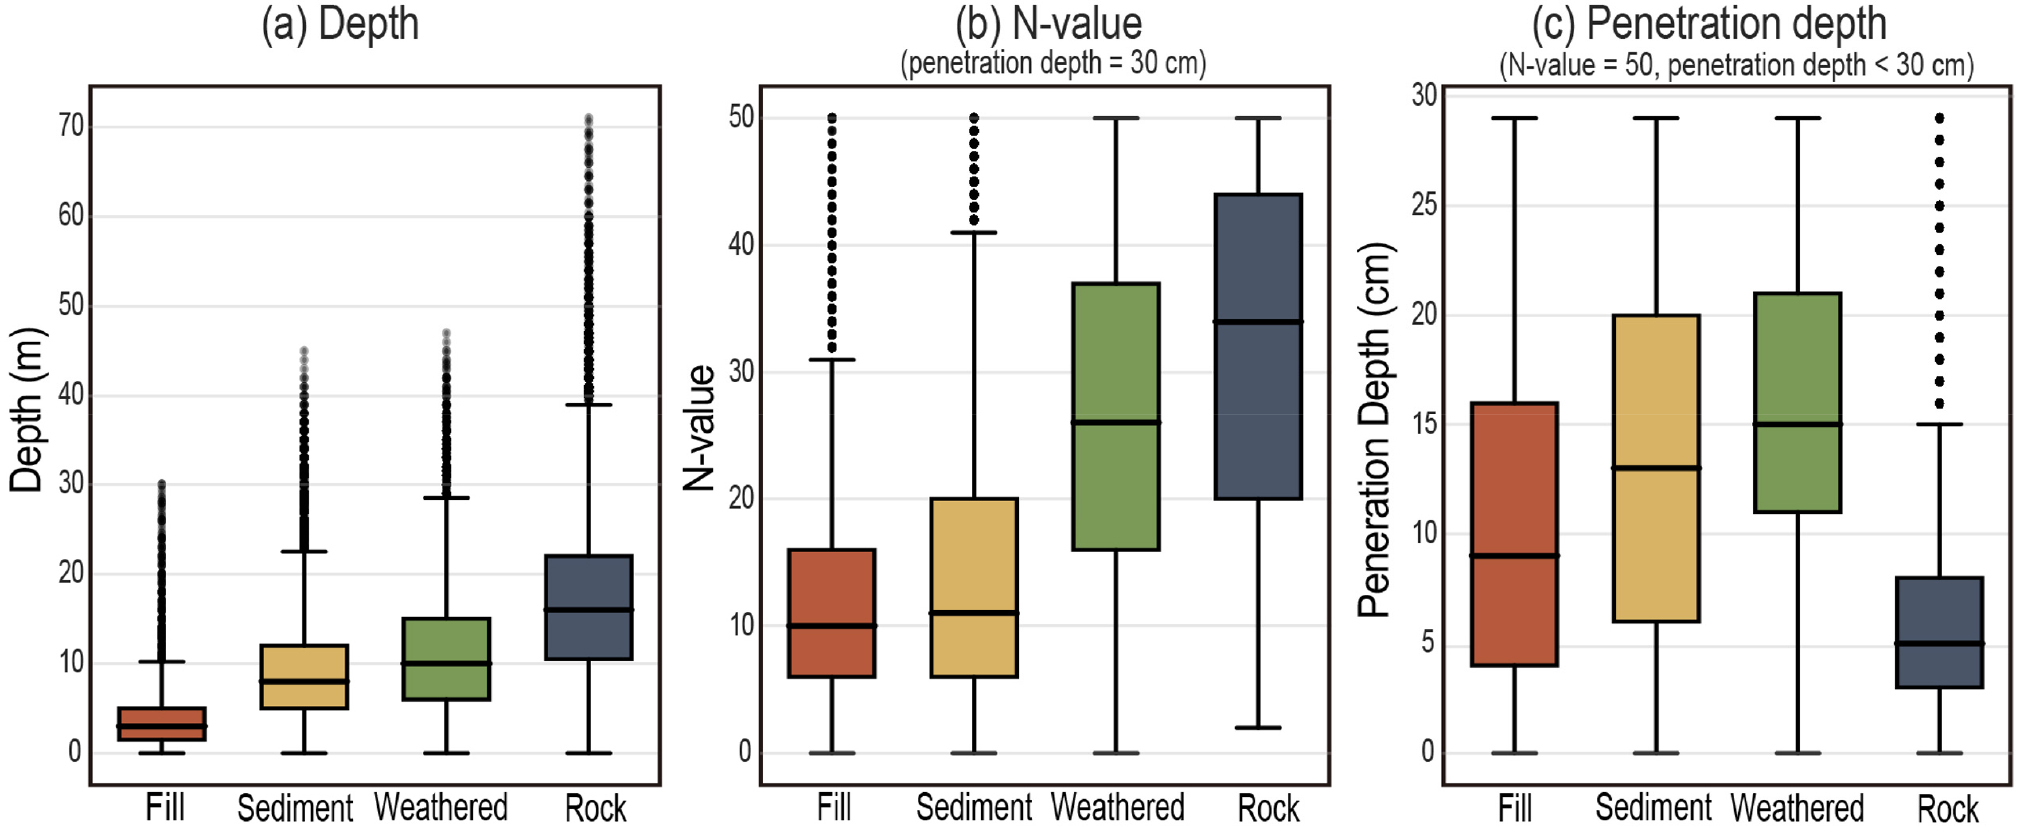
종합하면, 본 연구에서 정의한 4개 지층군은 수정 USCS 구성, 심도 분포, N값 및 관입깊이 분포에서 서로 다른 특성을 보인다. 따라서 이들 지층군은 SPT 입력자료와 지층 기록 간의 지배적 관계를 학습하기 위한 참조 라벨로 활용될 수 있음을 의미한다. 다만 각 지층군의 분포가 완전히 분리되는 것은 아니며, 특히 매립층과 퇴적층, 퇴적층과 풍화토층 사이에는 토질 구성 및 SPT 반응의 중첩이 존재한다. 이러한 중첩성은 지층 기록이 실제 지반 상태의 절대적 정답 값이 아닌 현장 조사 과정에서 확보된 참조 라벨이라는 점을 보여준다. 또한 이는 예측 엔트로피와 정·오분류 유형화 기반의 심층적 데이터 해석을 통해, SPT 자료와 지층 기록 간의 일관성 저하 구간을 검토할 필요가 있음을 시사한다.
한편 수정 USCS 정보는 모델의 입력 피처로 사용하지 않았다. 수정 USCS는 지층 기록과 직접적으로 관련된 보조 정보이므로, 이를 입력 피처로 사용할 경우 지층 라벨과 중첩되는 정보가 모델에 유입될 가능성이 있다. 따라서 본 연구에서는 수정 USCS를 4개 지층군 재분류의 물리적 타당성을 검토하기 위한 보조 자료로만 활용하고, 실제 모델 입력은 SPT 자료에서 직접 산정 가능한 심도, N값, 관입깊이 및 심도 방향 변화 지표로 구성하였다. 각 사용된 입력 피처는 Table 2에 정리되어 있다.
Table 2.
Summary of input features
3. 방법론
3.1 입력 구조 및 모델 구성
SPT 자료는 심도 방향 시퀀스 특성을 반영하였으며, 특정 심도의 입력은 해당 심도와 이전 관측치를 포함하는 고정 길이 윈도우로 구성하였다. 윈도우 크기 결정을 위해 각 지층별 두께 분포의 제3사분위수(Q75)를 산정하고 중앙값을 대표 지층 두께로 산정하였다. 1.5 m 간격으로 수행되는 SPT의 특성을 고려하여 대표 지층 두께를 포함하는 최소 정수의 크기인 5로 윈도우 크기를 결정하였으며 초기 구간에서 윈도우 길이를 충족하지 못하는 경우 pre-padding을 적용하였다.
데이터 분할은 시추공 단위로 수행하였다. 전체 자료의 15%를 test set으로 분리한 후, 나머지 자료에서 동일한 방식으로 validation set을 분리하여 최종적으로 training, validation, test sets의 비율이 70:15:15가 되도록 구성하였다. 이 과정에서 동일 시추공 내부의 샘플이 서로 다른 세트에 포함되지 않도록 하여 정보 누수를 방지하였다. 스케일링은 학습 자료에 대해서만 적합하였으며, padding 값은 변환 이후 다시 0으로 복원하였다.
본 연구에서는 동일한 윈도우 입력을 사용하되, FCNN은 이를 평탄화된 벡터로 처리하고, LSTM은 심도 순서를 유지한 시퀀스 형태로 처리하게 된다(Goodfellow et al., 2016). 따라서 두 모델의 비교는 입력 정보량의 차이가 아니라 심도 방향 순차 구조를 명시적으로 반영하는 방식의 차이를 검토하기 위한 것이다. LSTM은 미래 심도 정보를 사용하지 않는 단방향 구조로 구성하였고, 각 윈도우를 독립적으로 처리한다.
FCNN은 두 개의 fully connected hidden layer로 구성하였으며, hidden unit 수는 각각 128과 64로 설정하였다. 각 hidden layer에는 batch normalization, ReLU activation 및 dropout을 적용하였고, dropout rate는 0.30으로 설정하였다. LSTM은 2개의 LSTM layer와 hidden dimension 128로 구성하였으며, 마지막 시점의 hidden state를 fully connected layer에 입력하여 4개 지층군에 대한 logits를 산정하였다. LSTM의 dropout rate 또한 0.30으로 설정하였다.
모델의 출력은 Fill, Sediment, Weathered Soil, Rock의 4개 참조 라벨에 대한 예측 확률을 제공한다. 학습 과정에서는 예측 확률과 실제 참조 라벨 사이의 차이를 최소화하도록 모델 계수를 갱신하였다. 목적함수로는 클래스 불균형을 고려한 가중 교차 엔트로피 손실함수를 사용하였으며, 목적함수의 최소화는 Adam 최적화 알고리즘을 통해 수행하였다. 이때 사용된 가중 교차 엔트로피는 사후 분석 목적의 예측 엔트로피와 다르게 학습을 위한 목적으로 사용되며 예측 엔트로피의 정의는 3.2절에 제시되어 있다. Adam은 손실함수가 감소하는 방향으로 모델 계수를 반복적으로 갱신하는 경사 기반 최적화 방법으로(Kingma and Ba, 2015), 본 연구에서는 learning rate는 1×10⁻³, weight decay는 1×10⁻⁴, batch size는 128로 설정하였다. 최대 epoch 수는 100으로 설정하였고, validation macro F1이 10 epochs 동안 개선되지 않을 경우 early stopping을 적용하였다. LSTM 계열 모델에는 학습 안정화를 위해 gradient norm 5.0 기준의 clipping을 적용하였다. 이때, FCNN과의 비교는 모델 성능 자체의 경쟁보다, 심도 방향 시퀀스 구조를 고려한 LSTM의 정당성을 확인하기 위한 기준 설정의 의미를 가진다.
3.2 유형 정의 및 해석 지표
본 연구에서는 모델의 사후 출력값을 이용하여 각 샘플의 예측 불확실성을 산정하였다. 모델은 각 SPT 샘플에 대해 4개 라벨(Fill, Sediment, Weathered Soil, Rock)에 대한 예측 확률을 출력하며, 이 확률 분포로부터 예측 엔트로피를 계산하였다. 모델의 예측 확률은 다음과 같은 확률 벡터로 표현된다.
여기서, 는 번째 SPT 샘플이 번째 지층군에 속할 것으로 모델이 산정한 예측 확률이며, 4개 지층군에 대한 예측 확률의 합은 1이다. 모델의 최종 예측 지층군 는 예측 확률이 가장 큰 지층군으로 정의하였다.
이후 가 기록된 참조 지층군 와 일치하는 경우를 정분류, 일치하지 않는 경우를 오분류로 구분하였다. 따라서 정분류와 오분류는 예측 확률의 절대적 크기가 아니라, 가장 높은 예측 확률을 갖는 지층군이 기록된 참조 지층군과 일치하는지 여부에 의해 결정된다.
번째 샘플에 대한 예측 엔트로피 는 다음과 같이 정의된다.
여기서, 는 번째 샘플이 번째 지층군에 속할 것으로 예측된 확률이며, 는 지층군의 개수이다. 본 연구에서는 4개 지층군을 사용하므로 = 4이다. 낮은 엔트로피 값은 특정 지층군에 예측 확률이 집중되어 모델의 판단이 상대적으로 명확함을 의미하며 높은 엔트로피 값은 둘 이상의 지층군에 예측 확률이 분산되어 모델의 판단이 불확실함을 의미한다.
엔트로피는 지층군의 개수에 따라 가능한 최대값이 달라질 수 있으므로, 본 연구에서는 엔트로피를 최대 엔트로피 로 나누어 정규화 하였다.
정규화 엔트로피 은 0에서 1 사이의 값을 가지며, 0에 가까울수록 모델의 예측 확신이 크고 1에 가까울수록 예측 불확실성이 크다. 산정된 엔트로피는 최대 softmax 확률 값의 대소만으로 표현되는 확신도와 달리, 다중 분류에서 전체 확률 값의 퍼짐 정도를 나타낸다. 고엔트로피 구간의 기준은 검증 자료에서 계산된 정규화 엔트로피 분포의 제3사분위수(Q75)로 설정하였다.
본 연구에서는 예측 엔트로피만으로 이상 구간을 직접 판정하지 않고, 모델의 정분류 여부와 결합하여 각 샘플을 네 가지 유형으로 구분하였다. 유형1은 기록된 참조 지층군과 모델 예측 지층군이 일치하고 정규화 엔트로피가 기준 값보다 낮은 경우이다. 유형2는 기록된 참조 지층군과 모델 예측 지층군이 일치하지만 정규화 엔트로피가 기준 값보다 높은 경우이다. 유형3은 기록된 참조 지층군과 모델 예측 지층군이 일치하지 않지만 정규화 엔트로피가 기준 값보다 낮은 경우이다. 유형4는 기록된 참조 지층군과 모델 예측 지층군이 일치하지 않고 정규화 엔트로피가 기준 값보다 높은 경우이다. 이에 대한 내용은 Table 3에서 확인할 수 있다.
Table 3.
Summary of proposed four consistency types
각 유형의 지반공학적 특성을 검토하기 위해 다음의 해석 지표를 산정하였다. 첫째, 각 SPT 측정 심도에서 가장 가까운 지층 경계까지의 거리 를 계산하였다. 이 지표는 고엔트로피 샘플이 지층 경계부 또는 전이부와 관련되는지를 검토하기 위한 것이다. 둘째, 인접 심도 간 N값 변화량의 절댓값 을 산정하였다. 이는 각 유형이 심도 방향의 급격한 관입저항 변화와 관련되는지를 확인하기 위한 지표이다. 셋째, 기록된 지층군별 박스플롯 이상치 분석을 수행하였다. 본 연구에서는 N값, 관입깊이, 단위 관입저항, 인접 심도 간 N값 변화량을 대상으로 해당 분석을 수행하였다. 이 분석은 각 유형이 기록된 지층군의 일반적인 SPT 반응 범위에서 벗어나는 정도를 비교하기 위한 것이다. 이러한 분석을 통해 본 연구에서는 각 유형이 단순한 모델 출력의 조합에 그치는 것이 아니라, 지층 경계, 심도 방향 N값 변화, 지층군별 SPT 반응 범위와 어떤 상관성을 갖는지 검토하였다.
4. 결과 및 분석
4.1 분류 성능 비교
본 연구에서는 SPT 자료의 심도 방향 문맥을 반영하는 것이 지층 참조 라벨과의 관계 학습에 유효한지를 확인하기 위해 FCNN과 LSTM을 비교하였다. 평가 지표로는 정확도, 지층별 F1, Macro F1을 사용하였다. 이때 정확도는 전체 샘플 중 실제 지층과 예측 지층이 일치한 비율이며, 지층별 F1-score는 각 지층에 대해 정밀도와 재현율의 조화평균으로 산정한 성능 지표이고, Macro F1은 이러한 지층별 F1-score를 동일한 가중치로 평균한 값이다. Test set 기준 FCNN의 정확도는 69.53%, Macro F1은 0.6384로 나타났으며, LSTM의 정확도는 72.76%, Macro F1은 0.6701로 나타났다. LSTM은 FCNN에 비해 정확도에서 3.23%, Macro F1에서 0.0317의 성능 향상을 보였다.
지층군별 F1에서도 LSTM은 모든 지층군에서 FCNN보다 높은 값을 보였다. 매립층의 F1은 FCNN 0.383에서 LSTM 0.424로, 퇴적층은 0.628에서 0.687로, 풍화토층은 0.668에서 0.688로, 암반층은 0.874에서 0.882로 증가하였다. 이 결과는 단일 심도에서의 SPT 반응만을 사용하는 것보다, 인접 심도와의 관계를 포함한 국부적 심도 문맥이 SPT 입력자료와 지층 참조 라벨 간의 관계를 설명하는 데 유효한 정보로 작용할 수 있음을 시사한다.
사후 불확실성의 지표로써 예측 엔트로피가 모델의 오분류 가능성과 관련되는지를 확인하기 위해, 예측 엔트로피를 이용해 정분류와 오분류를 구분하는 이진 판별 분석을 수행하였다. 이때 Fig. 3(a)의 Receiver Operating Characteristic(ROC) 곡선은 오분류 샘플을 양성으로 가정할 때 예측 엔트로피 임계값 변화에 따른 재현율(True Positive Rate, TPR)과 위양성률(False Positive Rate, FPR)간의 관계를 나타낸다. 그 결과 Area Under the Curve(AUC)는 FCNN 0.7152, LSTM 0.7340으로 나타났다. 두 모델 모두 AUC가 0.5보다 크게 나타났으며, 예측 엔트로피는 정분류와 오분류를 무작위 수준보다 효과적으로 구분하는 지표로 판단된다. 특히 LSTM의 AUC가 FCNN보다 0.0188 높게 나타난 것은, 심도 방향 문맥을 반영한 모델에서 예측 엔트로피가 오분류 가능성과 더 밀접하게 대응함을 의미한다.
또한 모델의 예측 확률이 실제 정분류 여부와 어느 정도 정합 되는지를 확인하기 위해 Expected Calibration Error(ECE)를 산정하였다. ECE는 예측 확률과 실제 정답률 사이의 차이를 나타내는 지표로, 값이 작을수록 모델의 확률 출력이 실제 예측 신뢰도와 잘 부합함을 의미한다. Fig. 3(b)의 test set 기준 ECE는 FCNN 0.0111, LSTM 0.0068로 나타났으며, LSTM이 FCNN보다 0.0043 낮은 값을 보였다. 이는 LSTM의 예측 확률이 상대적으로 더 안정적인 신뢰도 정보를 제공함을 의미한다. 따라서 LSTM의 출력 확률과 이로부터 계산된 예측 엔트로피는 이후 정분류 여부와 결합하여 SPT 자료와 지층 참조 라벨 간의 일관성 수준을 유형화하는 데 활용되었다.
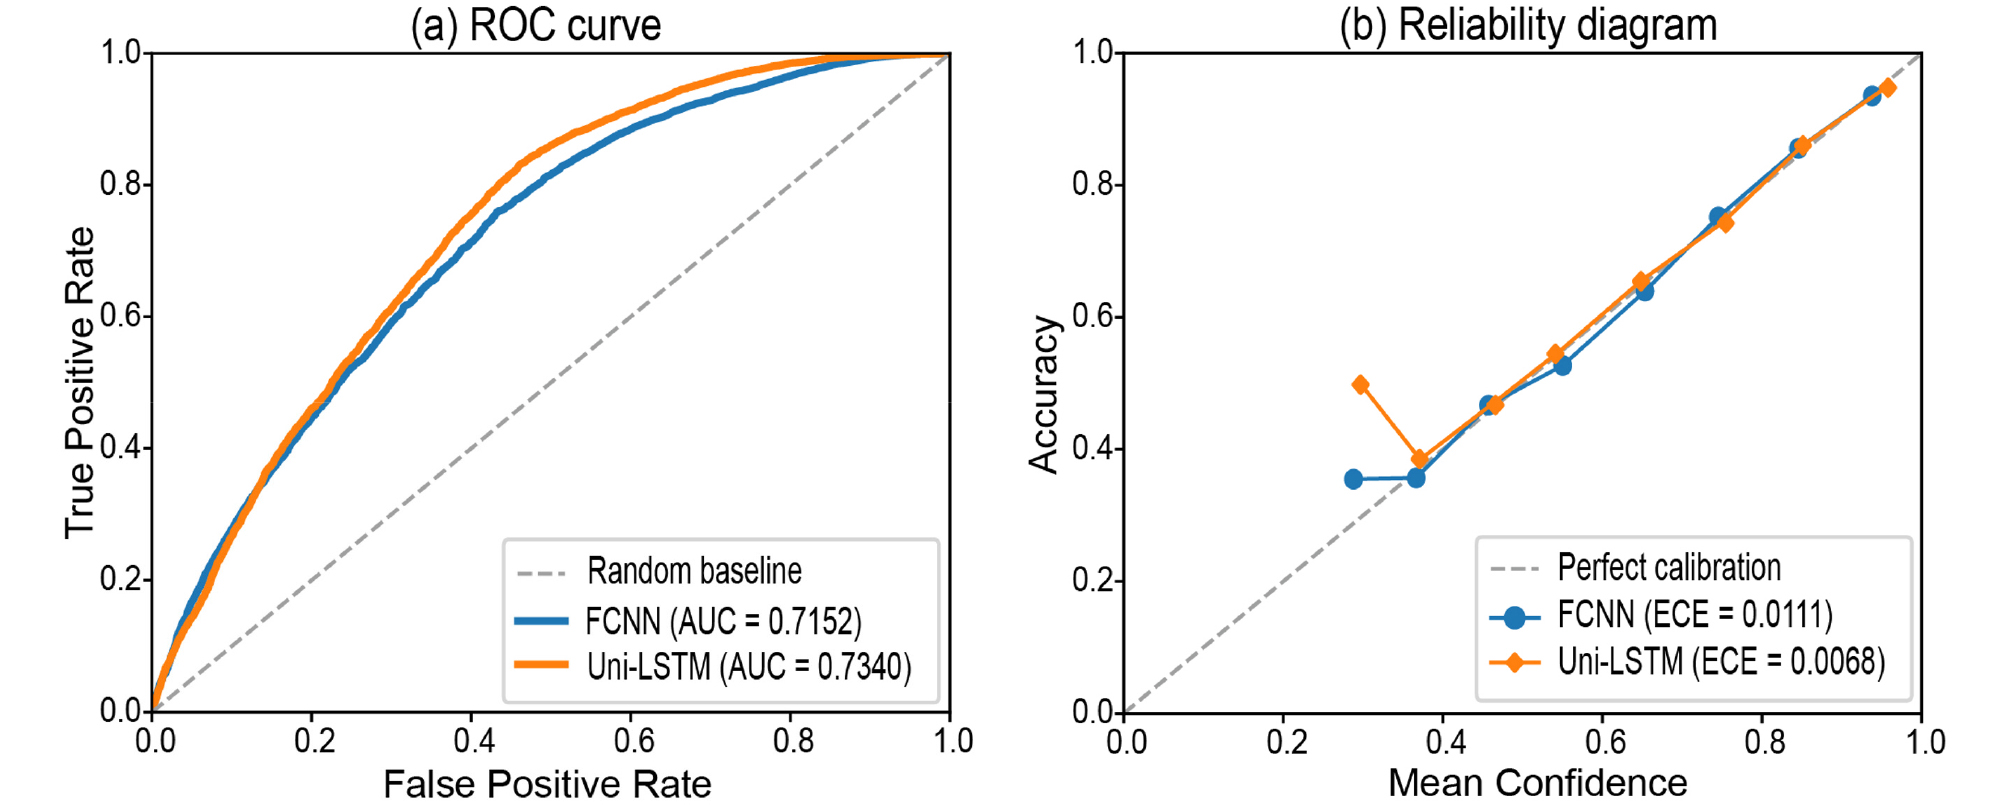
Fig. 3
Uncertainty diagnostics for misclassification detection and calibration. (a) Receiver operating characteristic curves for detecting misclassified samples using normalized predictive entropy as the discrimination score, where misclassification is treated as the positive class; the dashed diagonal denotes random discrimination. (b) Reliability diagrams comparing bin-wise mean softmax confidence with empirical classification accuracy; the dashed diagonal denotes perfect calibration.
4.2 유형별 출력 구조
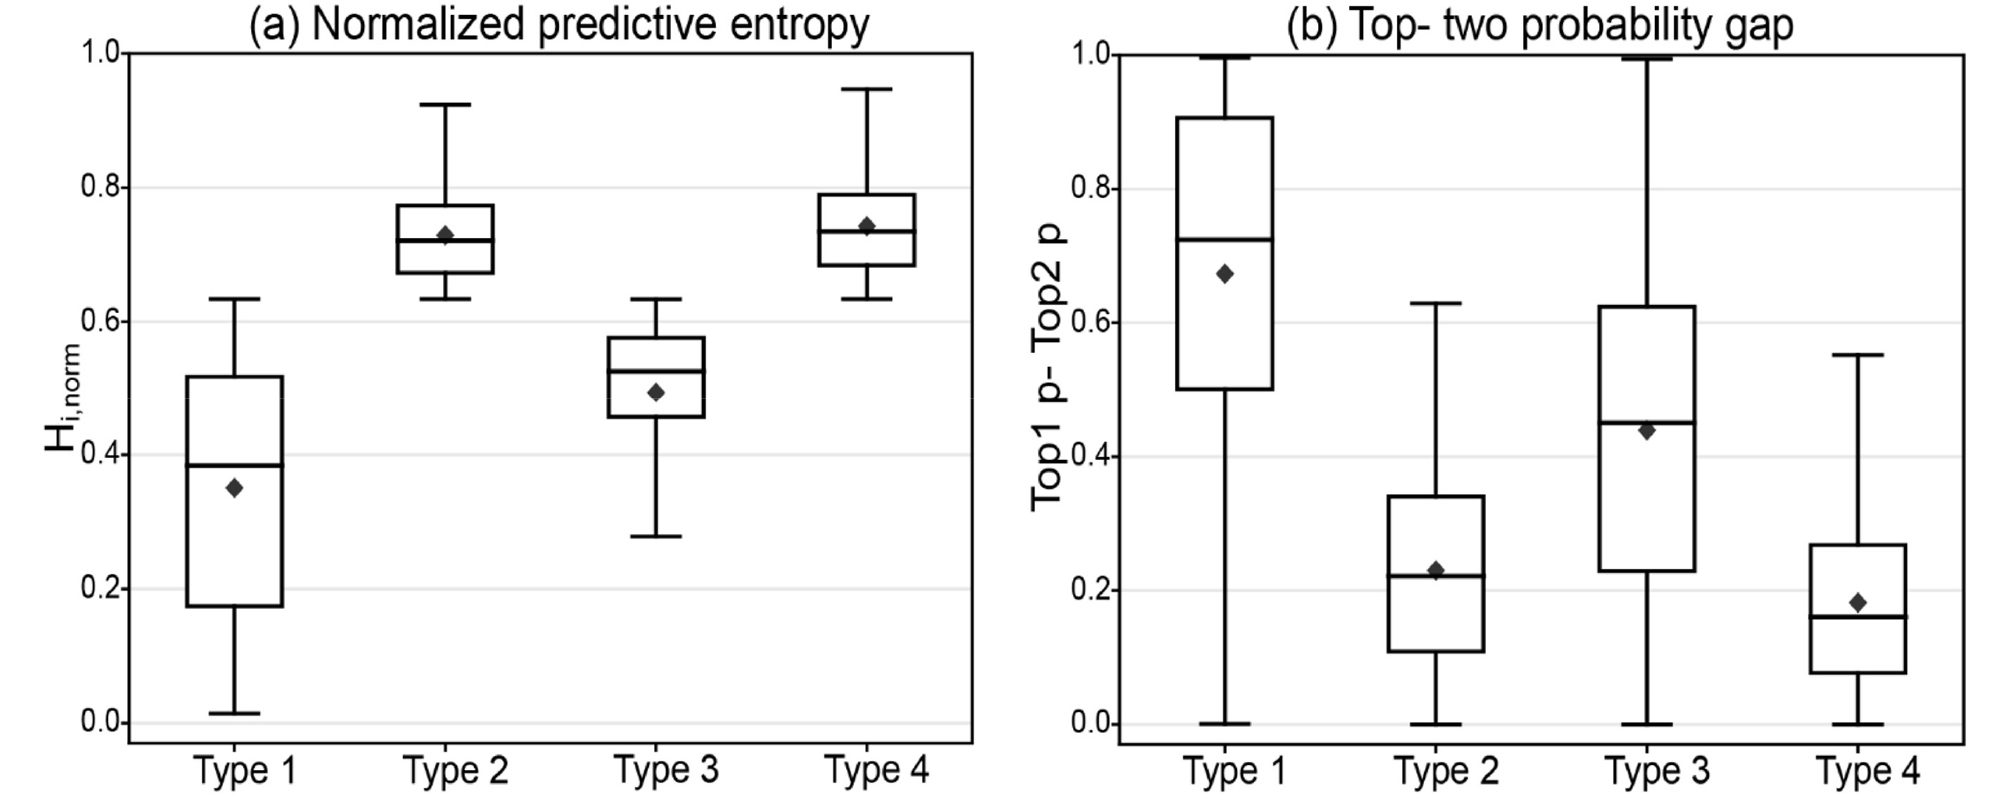
앞서 언급한 바와 같이 LSTM의 예측 결과를 정분류 여부와 예측 엔트로피 수준에 따라 네 가지 유형으로 구분하였다. 유형1은 정분류이면서 낮은 엔트로피를 갖는 경우, 유형 2는 정분류이면서 높은 엔트로피를 갖는 경우, 유형3은 오분류이면서 낮은 엔트로피를 갖는 경우, 유형4는 오분류이면서 높은 엔트로피를 갖는 경우이다. 시험 자료에서 유형1은 19,341개로 전체의 59.45%, 유형2는 4,331개로 13.31%, 유형3은 5,021개로 15.43%, 유형4는 3,841개로 11.81%를 차지하였다.
고엔트로피 그룹인 유형2와 유형4에서의 오분류 비율은 47.00%였으며, 저엔트로피 그룹인 유형1과 유형3에서의 오분류 비율은 20.61%였다. 즉, 고엔트로피 그룹의 오분류 비율은 저엔트로피 그룹보다 약 2.28배 높았다. 이는 검증 자료의 엔트로피 분포를 기준으로 설정한 고엔트로피 구분이 시험 자료에서도 오분류 발생과 일정한 관련성을 가짐을 보여준다.
Fig. 4(a)와 같이 유형별 평균 엔트로피는 유형4: 0.7425, 유형2: 0.7289, 유형3: 0.4941, 유형1: 0.3507 순으로 나타났다. 반대로 Fig. 4(b)의 1순위 예측 확률과 2순위 예측 확률의 차이의 평균은 유형1: 0.673, 유형3: 0.440, 유형2: 0.230, 유형4: 0.182 순이었다. 이 결과는 유형3과 유형4가 모두 오분류에 해당하지만 서로 다른 출력 구조를 갖는다는 점을 보여준다. 유형4는 엔트로피가 가장 높고 예측 확률 간격이 가장 작아 모델이 특정 지층군을 명확히 선택하지 못한 경우이다. 반면 유형3은 오분류임에도 엔트로피가 낮고 예측 확률 간격이 비교적 크므로, 모델이 기록된 참조 지층군이 아닌 다른 지층군을 상대적으로 명확히 선택한 경우로 볼 수 있다.
4.3 유형별 지반공학적 해석
유형별 지반공학적 의미를 검토하기 위해 지층 경계까지의 거리, 인접 심도 간 N값 변화량, 지층군별 조건부 박스플롯 이상치 비율을 분석하였다. Fig. 5(a)와 같이 지층 경계까지의 평균 거리는 유형1에서 2.167 m로 가장 컸으며, 유형3은 1.808 m, 유형2는 1.461 m, 유형 4는 1.459 m로 나타났다. Fig. 5(b)와 같이 경계 1.0 m 이내에 위치한 비율은 유형 1: 40.23%, 유형3: 47.02%, 유형2: 52.76%, 유형 4: 53.37%였다. 이는 고엔트로피 유형인 유형2와 유형4가 지층 경계부 또는 전이부에 더 가깝게 분포함을 의미한다.
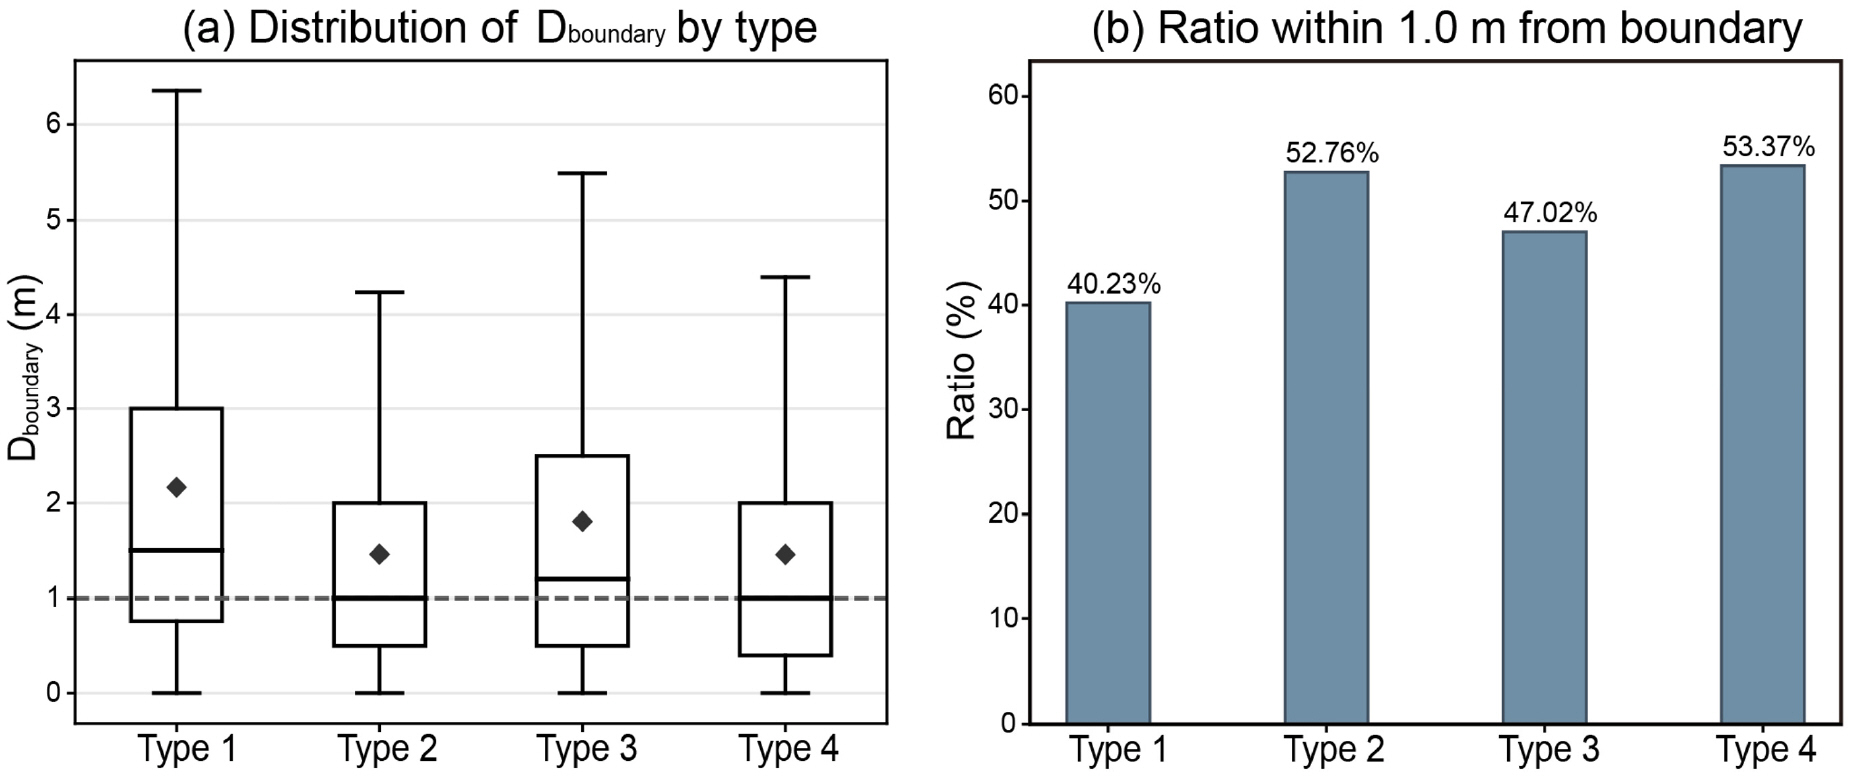
Fig. 5
Layer-boundary proximity of the four consistency types. (a) Distribution of Dboundary, defined as the minimum distance from each SPT measurement depth to the nearest upper or lower boundary of the recorded layer. (b) Percentage of samples located within 1.0 m of a recorded stratigraphic boundary.
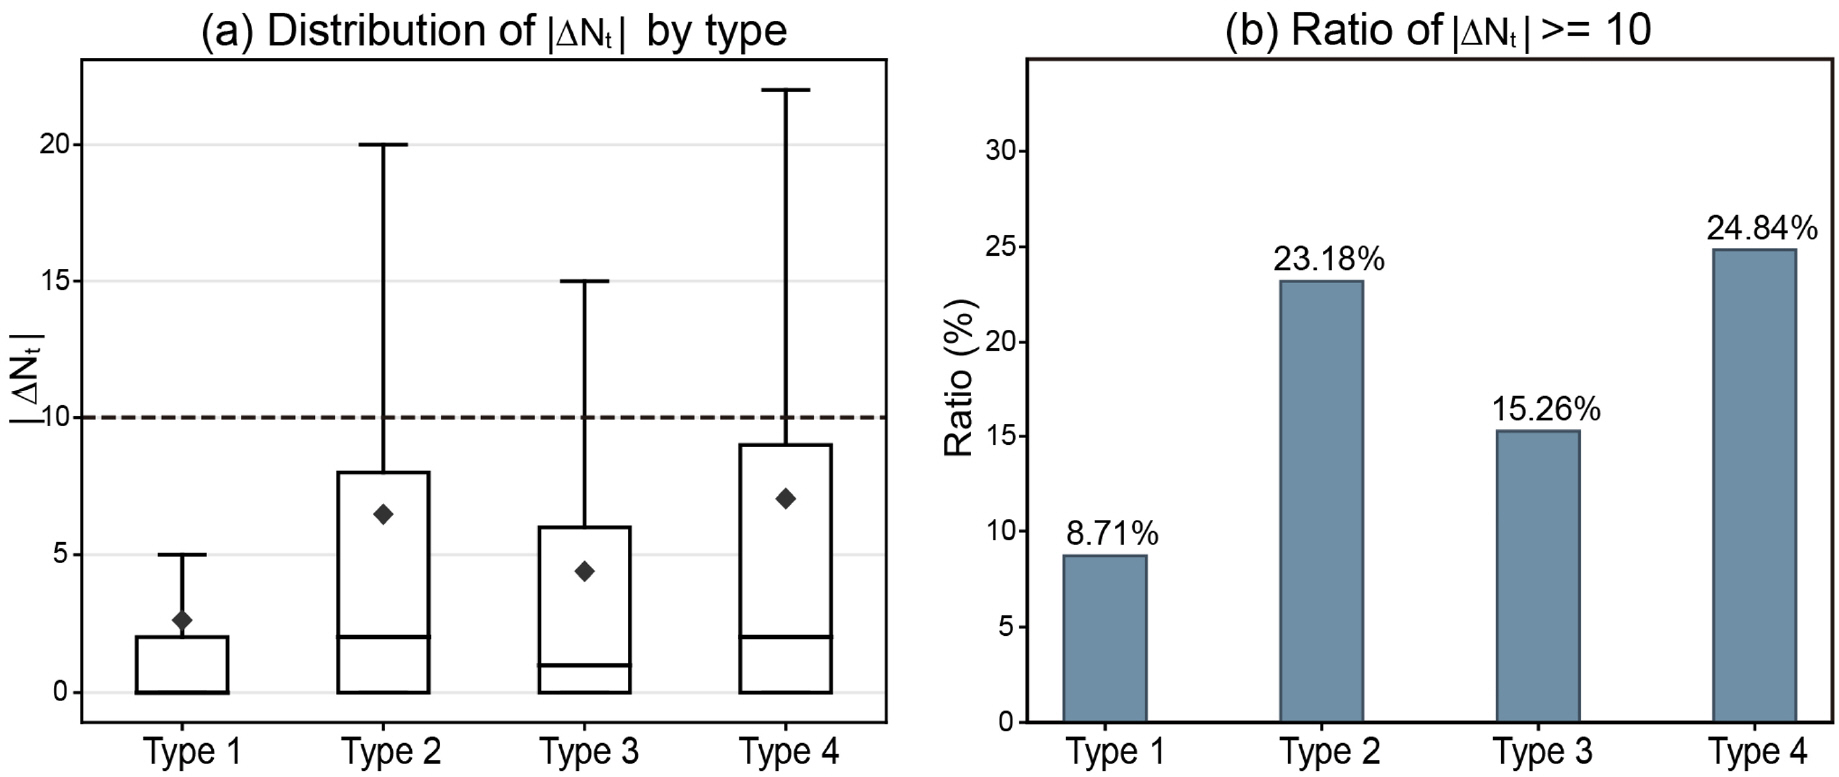
인접 심도 간 N값 변화량의 절댓값에서도 유사한 경향이 확인되었다. Fig. 6(a)의 평균 는 유형1: 2.608, 유형3: 4.392, 유형2: 6.475, 유형4: 7.045 순이었다. 또한 Fig. 6(b)와 같이 ≥10인 샘플의 비율은 유형1: 8.71%, 유형3: 15.26%, 유형2: 23.18%, 유형4: 24.84%로 나타났다. 따라서 유형 2와 유형 4는 단순히 모델의 불확실성이 큰 구간이 아니라, 실제 심도 방향 SPT 반응의 급격한 변화와 관련될 가능성이 큰 구간으로 해석된다.
유형1은 낮은 엔트로피, 큰 확신도 간격, 큰 지층 경계 거리, 작은 N값 변화량을 보였으므로 SPT 반응과 지층 기록이 일관적인 안정 구간으로 해석할 수 있다. 유형2는 최종 예측은 기록된 지층군과 일치하지만, 지층 경계에 가깝고 N값 변화가 크므로 지층 경계부 또는 전이부의 영향을 받아 불확실성이 증가한 구간으로 볼 수 있다.
각 유형의 SPT 반응이 기록된 지층군의 경험적 분포와 얼마나 일치하는지를 확인하기 위해, , , , 에 대한 조건별 IQR 기준 박스플롯 이상치 비율을 산정하였다. 이때 Fig. 7(a)의 이상치 비율은 네 개 피처 중 하나 이상이 이상치로 판정된 샘플 비율이다. 참조 라벨 기준 이상치 비율은 유형1에서 8.77%로 가장 낮았고, 유형2는 30.52%, 유형3은 65.29%, 유형4는 60.74%로 나타났다. Fig. 7(b)에서 유형1의 피처별 이상치 비율은 :3.43%, :4.62%, :1.74%, :5.17%로 낮은 이상치 비율을 보여, 기록 지층군과 SPT 반응이 가장 일관적인 기준 구간으로 해석된다. 반면 유형2는 Fig. 7(a)의 이상치 비율이 30.52%로 증가하였고, 특히 참조 라벨에서 이상치 비율이 20.25%로 가장 크게 나타나, 최종 예측은 기록 지층군과 일치하지만 인접 심도 간 N값 변화 또는 경계부 영향이 반영된 구간으로 볼 수 있다.
오분류 유형인 유형3과 유형4는 모두 참조 라벨 기준 이상치 비율이 높았으나, 예측 라벨 기준으로 재평가했을 때 서로 다른 양상을 보였다. 유형3은 Fig. 7(a)에서의 이상치 비율이 65.29%에서 15.61%로 감소하였으며 피처별 이상치 비율의 경우 는 55.29%에서 7.27%로, 는 42.94%에서 7.05%로 크게 감소하였음을 Fig. 7(b)와 Fig. 7(c)에서 확인하였으며 각 피처별 이상치 비율 감소의 정도는 Fig. 7(d)에 정리되어 있다. 이는 유형3의 비전형성이 주로 기록된 지층군 기준과의 관입저항 수준 간의 불일치에서 발생하며, 모델이 예측한 지층군 기준에서는 해당 SPT 반응이 상당 부분 일관된 특성을 보인다는 것을 의미한다. 반면 유형4는 Fig. 7(a)의 이상치 비율이 60.74%에서 35.80%로 감소하는 데 그쳤고, 이상치 비율은 23.74%에서 22.88%로 거의 유지되었다. 결론적으로 유형3은 기록 지층군과 SPT 관입저항 특성 간의 불일치 가능성이 큰 유형으로, 유형4는 지층군 기준을 바꾸어도 N값의 급변성이 남아 있는 경계성·전이성 또는 고불확실성 구간으로 해석 가능하다.
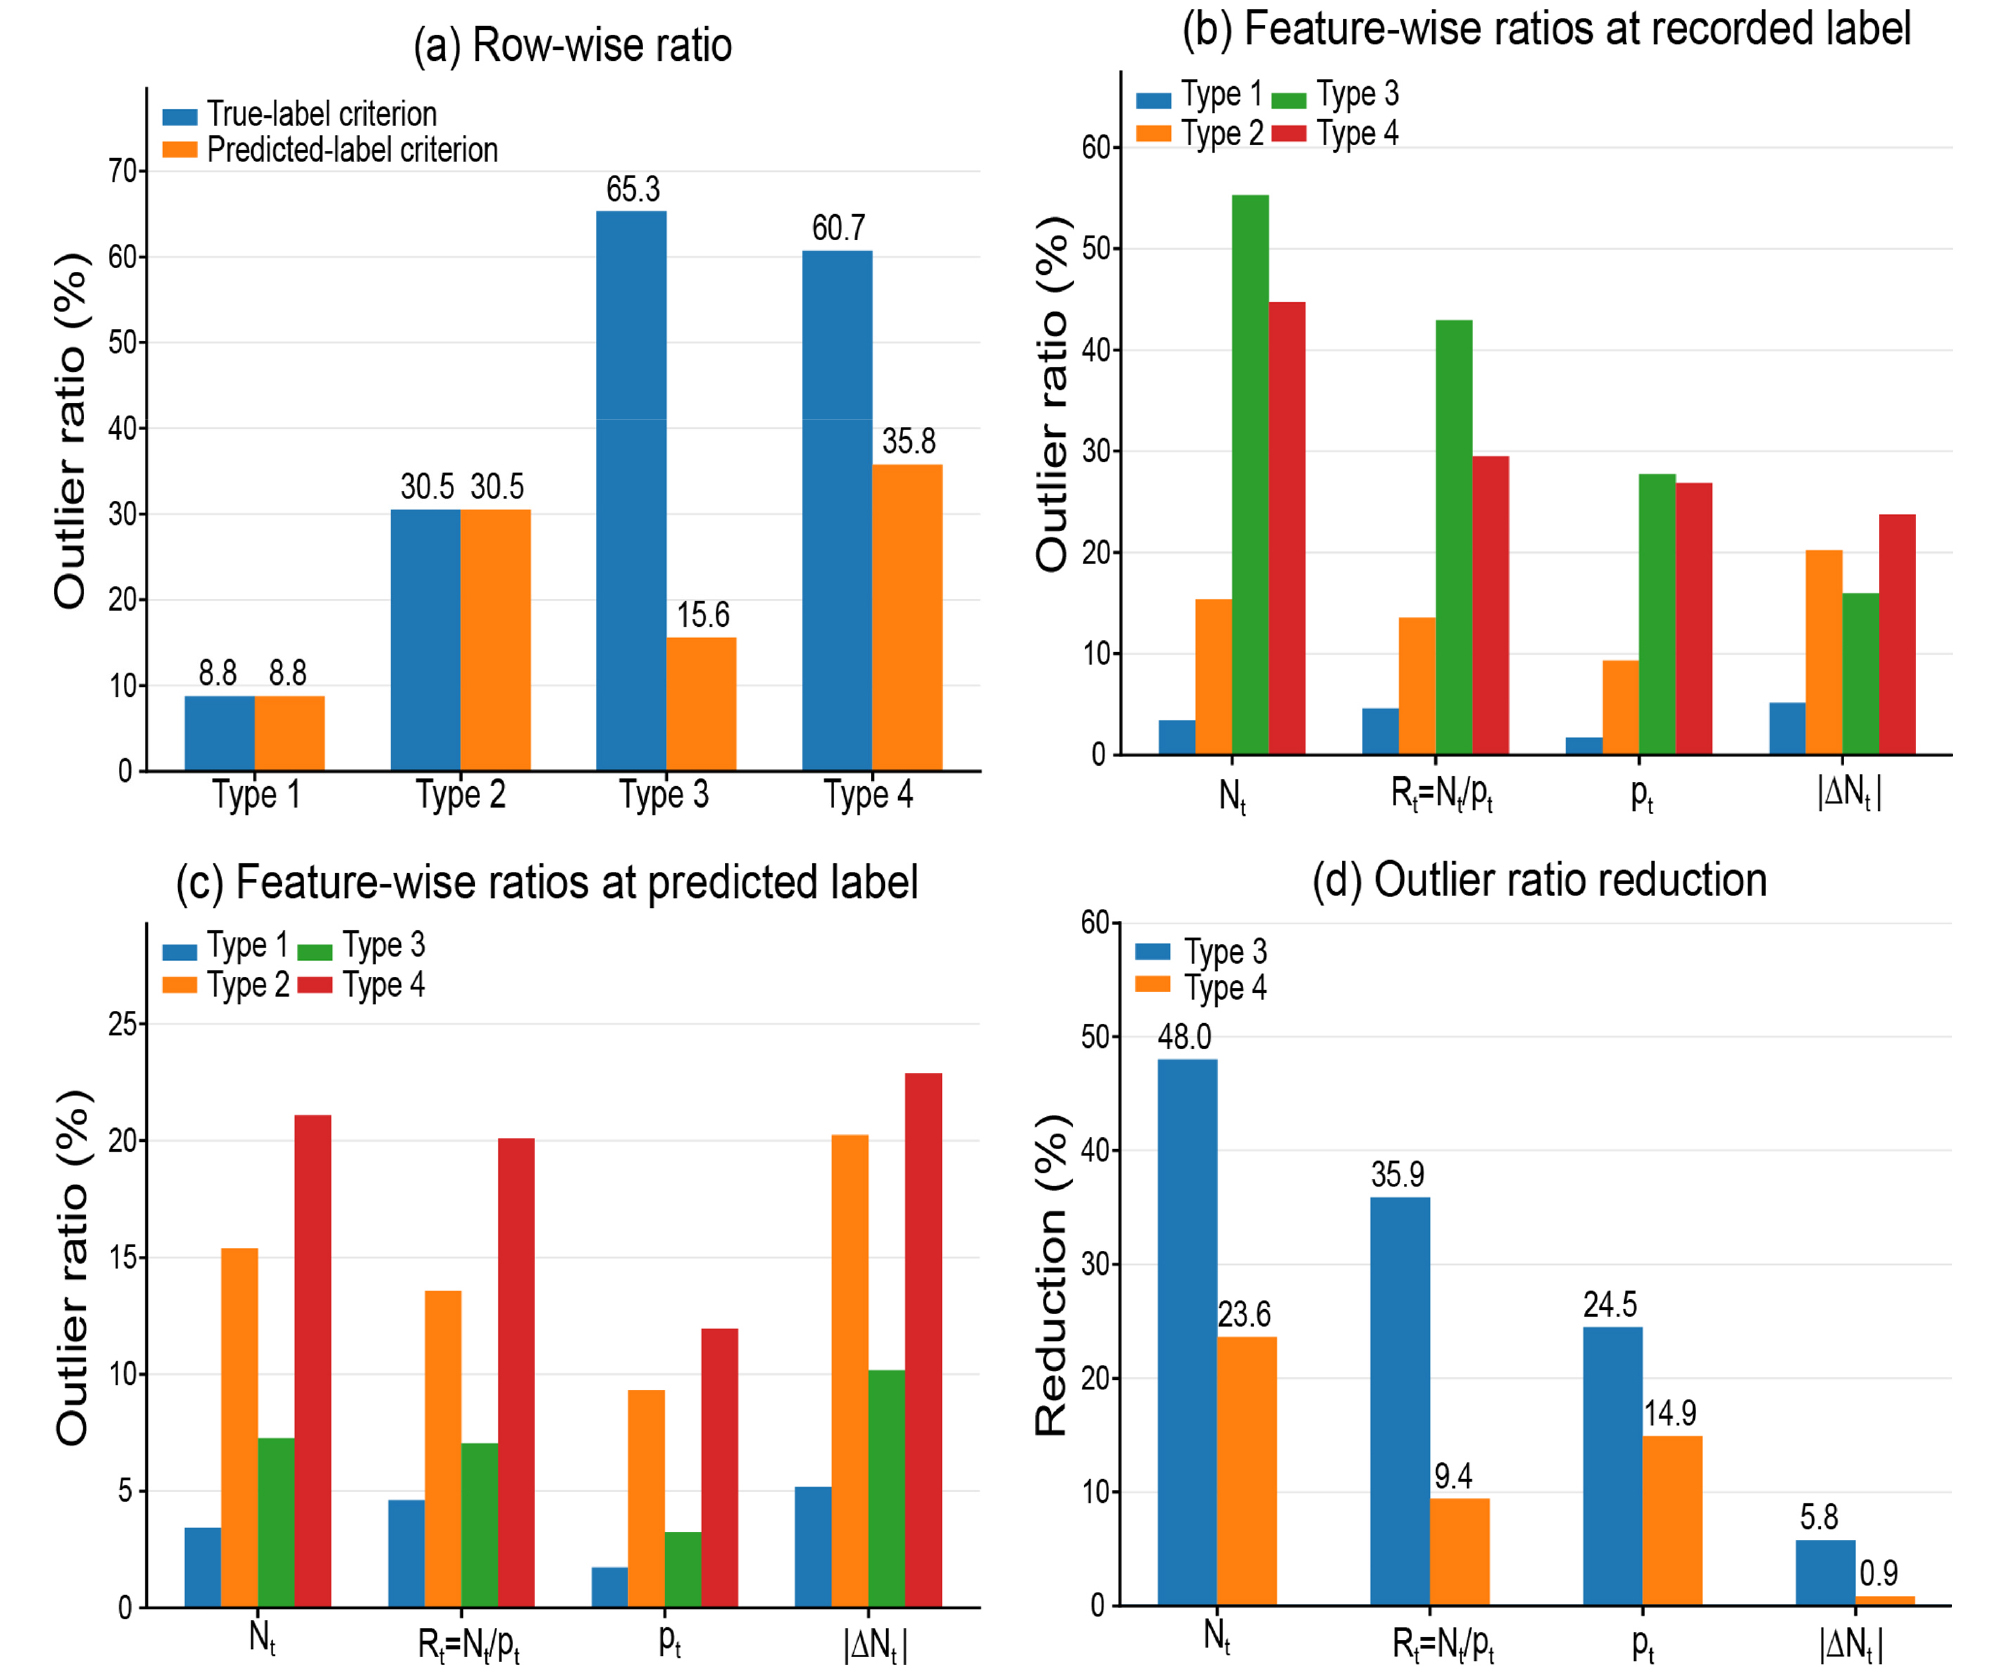
Fig. 7
Boxplot-based outlier ratios by uncertainty type and label criterion. (a) Percentage of samples for which at least one of , , , or falls outside the label-conditioned boxplot bounds, calculated using either the recorded label or the model-predicted label. (b) Feature-wise outlier ratios evaluated using the recorded proxy label. (c) Feature-wise outlier ratios evaluated using the predicted label. (d) Absolute reduction in the feature-wise outlier ratio, in percentage points, when the criterion is changed from the recorded proxy label to the predicted label for Types 3 and 4.
5. 결 론
본 연구에서는 대규모 SPT 자료의 품질관리를 위해, SPT 반응과 지층 참조 라벨 사이의 일관성이 낮은 구간을 식별하고 유형화하는 분석 체계를 제안하였다. 지층 분류는 최종 목적이 아니라 SPT 입력자료와 지층 기록 사이의 지배적 관계를 학습하기 위한 대리 과제로 설정하였으며, 심도 방향 시퀀스 구조를 반영한 단방향 LSTM 모델과 예측 엔트로피를 결합하여 각 샘플의 예측 결과를 해석하였다. 분석 결과, 심도 방향 문맥을 고려한 모델은 단일 심도 기반 모델보다 SPT와 지층 간의 관계를 더 안정적으로 학습하였고, 예측 엔트로피는 모델이 설명하기 어려운 샘플을 우선적으로 선별하는 지표로 활용 가능함을 확인하였다. 이에 따라 본 연구에서는 정분류 여부와 엔트로피 수준을 결합하여 SPT 샘플을 네 가지 유형으로 구분하였다. 유형1은 SPT 반응과 지층 기록이 일관적인 안정 구간으로, 유형2는 최종 예측은 기록 지층군과 일치하지만 지층 경계부 또는 전이부의 영향으로 불확실성이 증가한 구간으로 해석되었다. 유형3은 오분류임에도 낮은 엔트로피와 비교적 큰 확신도 간격을 보였고, 기록된 지층군 기준에서는 비전형적이지만 모델이 예측한 지층군 기준에서는 더 일관적인 SPT 반응을 보였다. 따라서 유형3은 단순한 모델 오류라기보다 지층 기록의 불일치, 지층명 대표성 저하, 또는 SPT 반응의 비전형성이 의심되는 핵심 검토 후보로 해석할 수 있다. 반면 유형4는 오분류와 높은 엔트로피가 동시에 나타나는 구간으로, 지층 경계부, 전이부, 급격한 N값 변화 또는 지층군 간 SPT 반응 중첩이 복합적으로 작용하는 고불확실성 검토 구간으로 볼 수 있다.
종합하면, 본 연구의 주요 의의는 모델의 오분류를 단순한 예측 실패로 처리하지 않고, 예측 엔트로피와 지반공학적 보조 지표를 결합하여 서로 다른 물리적 의미를 갖는 검토 유형으로 체계화하였다는 점에 있다. 제안된 체계는 이상치를 자동으로 확정하거나 제거하는 절차가 아니라, 대규모 SPT 데이터베이스에서 전문가가 우선적으로 검토해야 할 구간을 선별하기 위한 품질관리 지원 도구로 활용될 수 있다. 특히 유형2와 유형4는 지층 경계 또는 전이 구간과 관련된 불확실성 유형으로, 유형3은 기록 지층군과 SPT 반응 간 불일치 가능성이 큰 유형으로 구분될 수 있어 단일 임계값 기반의 이상치 판정보다 세분화된 해석을 제공한다. 또한 고엔트로피 기준을 Q75에서 Q70 및 Q80으로 변화시킨 민감도 분석 결과, 기준 분위수를 약 ±5% 범위에서 조정하더라도 유형별 비율에는 일부 변화가 있었으나, 유형 간 엔트로피와 확신도 구조, 지층 경계와의 관련성 및 인접 심도 간 N값 변화에 대한 주요 해석은 유지되었다. 다만 이러한 결과가 보다 넓은 임계값 범위에서도 동일하게 적용된다고 단정할 수는 없으므로, 향후에는 모델 구조와 데이터 분포의 특성, 검토 목적 및 해석자의 공학적 판단을 함께 고려한 임계값 선택 기준을 체계적으로 제시할 필요가 있다. 한편 본 연구에서 사용한 지층 라벨은 실제 지반 상태의 절대적인 정답이 아니라 현장 조사와 기록 과정에서 확보된 참조 라벨이므로, 유형화 결과는 지층 오류의 확정 판정이 아닌 검토 우선순위로 해석되어야 한다. 또한 유형 3에서 관찰된 예측 지층군 기준의 일관성 증가는 SPT 기반 경험분포를 이용한 사후 해석 결과이므로 독립적인 지질학적·지반공학적 검증을 대체할 수 없다. 향후 연구에서는 시추주상도 원자료, 실내시험 결과, 물리탐사 자료, 전문가 재판독 결과 및 타 지역 자료와의 비교를 통해 각 유형의 실제 공학적 의미와 적용 가능성, 그리고 임계값 선택의 일반화 가능성을 추가로 검증할 필요가 있다.
Notation
ReLU : Rectified Linear Unit activation function
Adam : Adaptive Moment Estimation optimizer
: Number of stratigraphic label classes; = 4
: Softmax probability vector predicted for sample
: Stratigraphic class predicted by the model for sample
: Predictive entropy for sample
: Predictive entropy normalized to a range between 0 and 1
: Minimum distance from sample to the nearest upper or lower boundary of the recorded layer (m)
TPR : True Positive Rate; proportion of misclassified samples correctly identified as positive (0–1)
FPR : False Positive Rate; proportion of correctly classified samples incorrectly identified as positive (0–1)
ROC : Receiver Operating Characteristic curve
AUC : Area Under the ROC Curve (0–1)